
消息队列 / 系统课时
理解消费组与分区并行度
理解消费组与分区并行度
消费组的并行能力不是由消费者实例数单独决定,而是由 Topic 的 Partition 数与实例分配共同决定。本篇建立三者的映射关系,并用实际命令验证:扩容会重新分配分区,但单个消费组的有效并行度不会超过可消费分区数。
学习目标
- 说清 Partition、Consumer Group 与 Consumer 实例之间的分配关系
- 判断增加或减少消费者实例后,哪些实例会真正承担分区
- 用 Kafka 命令核对分区数、成员数与实际分配结果
并行度上限由分区决定
在同一个 Consumer Group 内,一个 Partition 在任一时刻只能分配给该组中的一个消费者成员;一个消费者则可以同时持有多个 Partition。若一个 Topic 有 6 个 Partition,那么这个组针对该 Topic 最多只能形成 6 条并行消费通道。
可以把有效并行度近似理解为:
例如 Topic 有 6 个 Partition:2 个消费者时,通常每个实例承担约 3 个;6 个消费者时,可以达到一实例一分区;8 个消费者时,仍只有 6 个实例能拿到分区,另外 2 个实例会空闲。
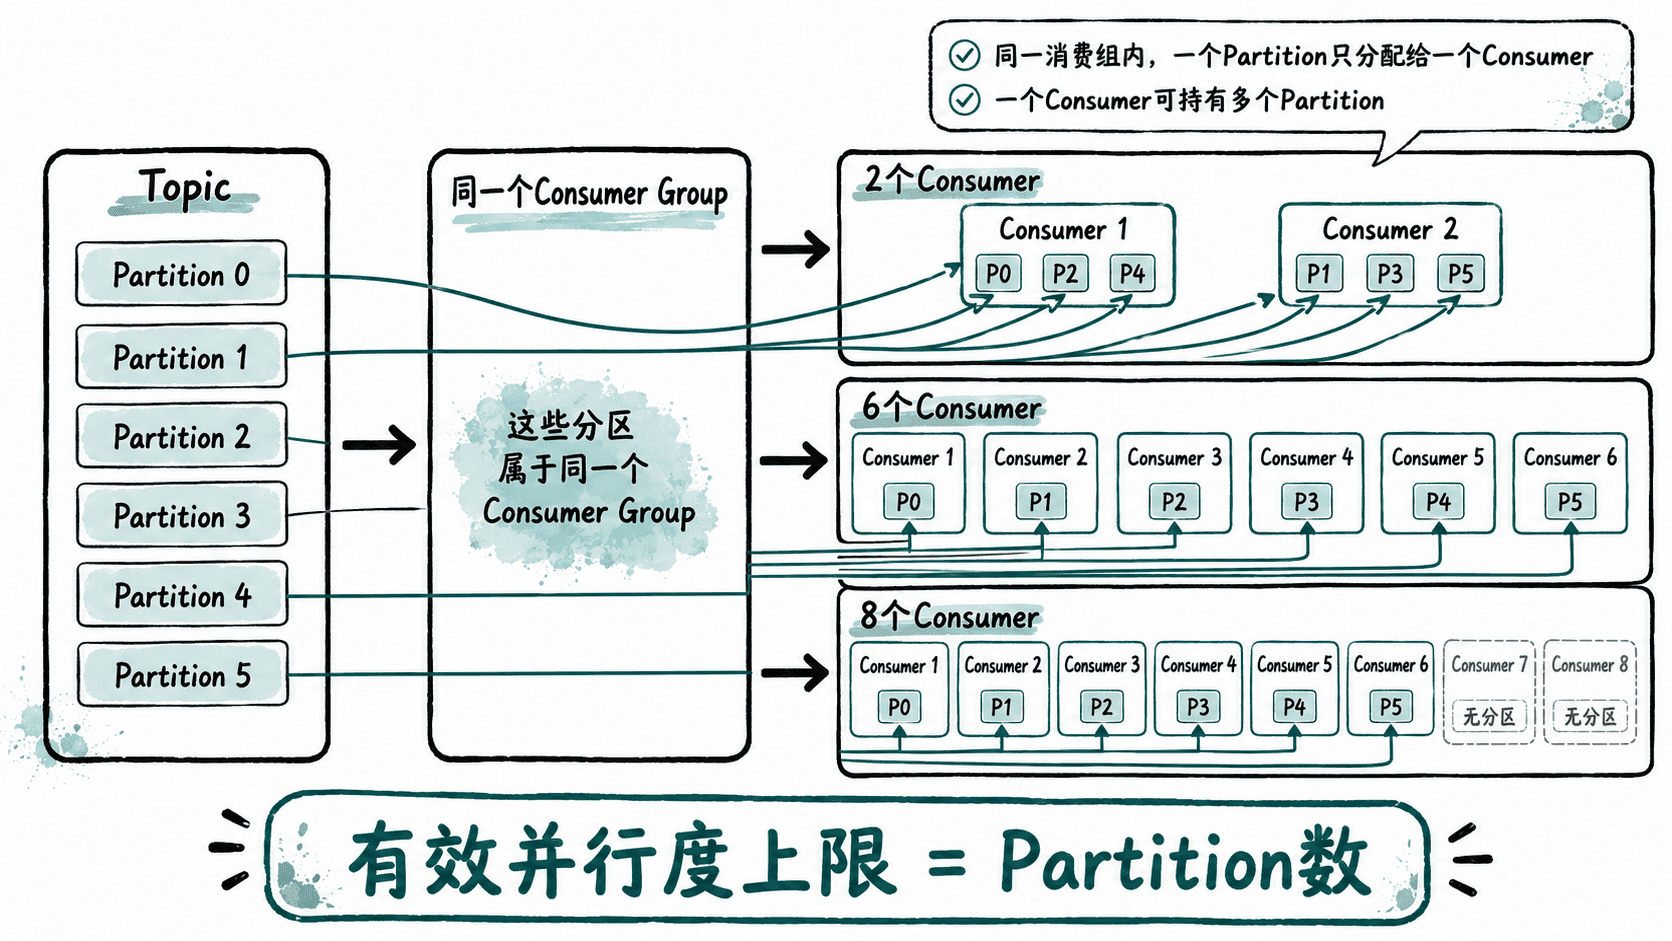
这里的“一个 Partition 只能给一个消费者”只限定在同一个 Group 内。另一个 Consumer Group 可以独立消费同一个 Partition,因此多个业务订阅方不会彼此抢占分区。
实例数变化为什么会触发重新分配
消费者加入、退出,或订阅集合发生变化时,组需要重新确定“哪个成员消费哪些 Partition”。经典消费组协议中,这一过程通常伴随 Rebalance:成员重新加入组,分区重新分配,随后恢复稳定消费。
增加实例的价值,是把现有 Partition 更均匀地摊到更多进程上,而不是凭空创造新的消费通道。若分区已经全部“一实例一分区”,继续横向扩消费者通常不会提高单组吞吐;此时应评估增加 Partition、提高单实例处理能力,或减少下游阻塞。
减少实例则会让剩余成员接管更多 Partition。比如 6 个 Partition 从 6 个实例缩到 3 个实例后,理想情况下每个实例会持有约 2 个 Partition,因此单实例 CPU、网络和下游调用压力都可能上升。
用命令核对实际分配
先确认 Topic 的 Partition 数。把 <BOOTSTRAP> 替换为 Kafka bootstrap server 地址。
kafka-topics.sh --bootstrap-server <BOOTSTRAP> \
  --describe --topic orders
预期输出
Topic: orders  PartitionCount: 6  ReplicationFactor: <VALUE>
Topic: orders  Partition: 0  Leader: <ID>  Replicas: <VALUE>  Isr: <VALUE>
...
Topic: orders Partition: 5 Leader: <ID> Replicas: <VALUE> Isr: <VALUE>ReplicationFactor、Broker ID 和副本集合取决于实际集群;这里真正要确认的是 PartitionCount: 6。
再查看消费组当前由哪些成员承担分区:
kafka-consumer-groups.sh --bootstrap-server <BOOTSTRAP> \
  --describe --group orders-worker
预期输出
GROUP          TOPIC   PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG      CONSUMER-ID   HOST       CLIENT-ID
orders-worker  orders  0          <OFFSET>        <OFFSET>        <VALUE>  <ID>          <IP>       <ID>
orders-worker  orders  1          <OFFSET>        <OFFSET>        <VALUE>  <ID>          <IP>       <ID>
...
orders-worker  orders  5          <OFFSET>        <OFFSET>        <VALUE>  <ID>          <IP>       <ID>
把同一个 CONSUMER-ID 出现的行归在一起,就能看到某个实例实际持有几个 Partition。若有 8 个消费者但只有 6 个 Partition,普通 --describe 主要展示已分配的 Partition 行,不能仅凭行数证明另外两个实例不存在;需要结合成员信息或客户端监控确认空闲成员。
扩容前先判断瓶颈在哪
如果 Lag 持续增长,先判断是不是“分区并行度不足”。当活跃消费者数明显少于 Partition 数,并且单实例已经接近 CPU、I/O 或下游处理上限时,增加消费者通常有效。
如果消费者数已经达到或超过 Partition 数,再扩实例只会增加组成员管理和 Rebalance 成本。此时更应检查单条消息处理耗时、批量拉取与提交策略、下游限流,以及是否需要在可接受的顺序语义下扩充 Partition。
因此,治理消费组的第一条基线不是“实例越多越快”,而是先把 Partition 数、活跃成员数、每个成员的分区分配和实际处理能力 放在同一张图里判断。