
消息队列 / 系统课时
识别 Rebalance 触发条件
识别 Rebalance 触发条件
判断一次变化会不会触发 Rebalance,关键不是看“Kafka 有没有发生变化”,而是看它是否让消费组的成员集合、订阅集合、可分配分区集合或成员活性发生变化。掌握这四类信号后,就能区分真正的再分配事件与普通消息流量、提交位点等无关变化。
学习目标
- 判断消费者加入、退出和失活是否会触发重新分配
- 区分订阅变化、Topic 分区变化与普通数据变化
- 用消费者回调与组状态证据确认是否真的发生过 Rebalance
用四类变化做判断
Classic 消费组的目标,是让协调器维护一份“当前成员如何分到订阅分区”的一致结果。只要这份结果的输入发生变化,组通常就需要重新计算分配。
| 变化 | 通常是否触发 | 判断依据 |
|---|---|---|
新消费者加入同一 group.id |
是 | 成员集合变化,需要把分区重新分给更多成员 |
| 现有成员离组或被判定失活 | 是 | 成员集合变化,原分区需要被接管 |
subscribe() 改变订阅 Topic |
是 | 订阅集合变化,可分配分区集合随之变化 |
| 已订阅 Topic 增加分区 | 是 | 可分配分区集合扩大,需要重新计算分配 |
| 正则订阅匹配到新建 Topic | 是 | 元数据刷新后,订阅实际覆盖的 Topic 集合变化 |
| Topic 中新增消息 | 否 | 分区拓扑没有变化,只是分区内数据增加 |
| 正常提交 offset | 否 | 只更新消费进度,不改变成员或分区归属 |
| 短暂网络抖动但未超过失活阈值 | 通常否 | 成员仍被协调器视为存活 |
因此,“业务流量突然变大”本身不会触发 Rebalance;真正需要关注的是流量变化是否进一步导致消费者超时、扩缩容或 Topic 分区扩容。
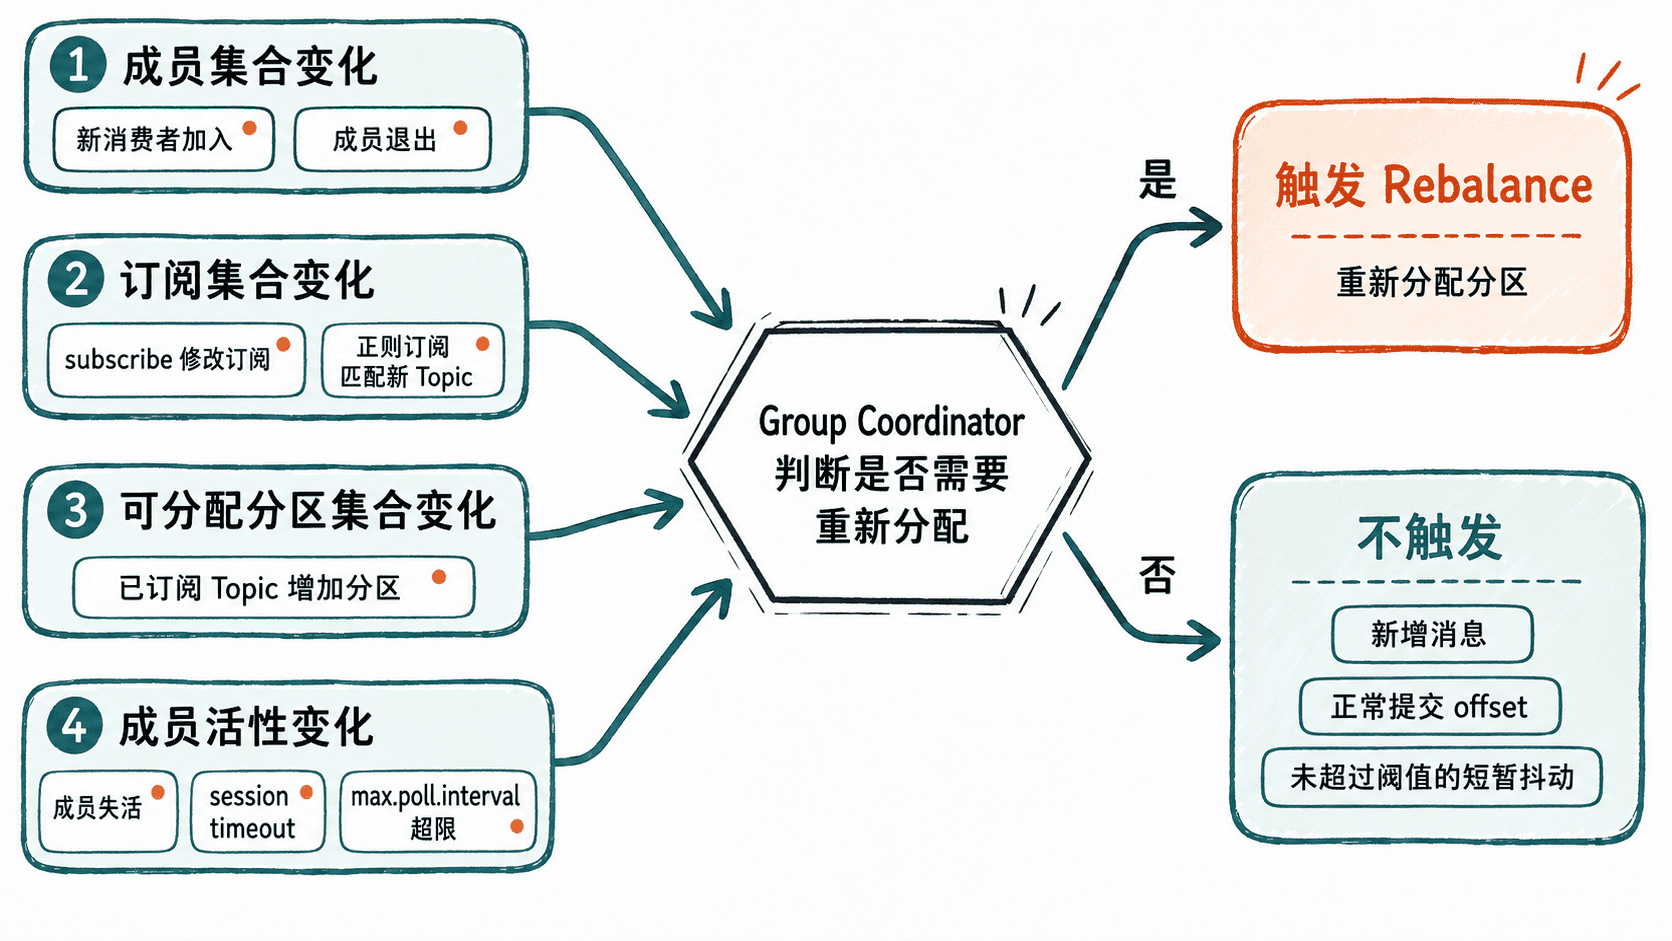
活性判定最容易造成误判
成员“进程还活着”不等于“协调器仍认为它是有效成员”。Classic consumer 主要受两类时间约束影响:心跳长期未到达会触发 session.timeout.ms 相关失活;应用长时间不调用 poll(),超过 max.poll.interval.ms,也会让该成员失去继续持有分区的资格。
这也是线上常见的链式触发:下游变慢或单批处理过重 → poll() 间隔过长 → 成员退出当前代次 → 组重新分配。若配置了静态成员身份,部分超时场景的分区回收时点会不同,不能只看到 max.poll.interval.ms 超限就假定分区已经立刻转移。
Topic 变化要看是否改变可分配集合
已订阅 Topic 增加分区会改变组需要分配的 partition 集合,因此会触发重新分配。若消费者使用正则订阅,新 Topic 的创建或删除也可能在元数据刷新后改变匹配结果,进而触发 Rebalance。
相反,只修改消息内容、生产速率、保留时间或普通 Topic 配置,并不会因为“元数据有更新”就必然导致消费组重新分配。判断时应继续追问:这次变化有没有改变消费者实际订阅到的 Topic 或 partition 集合。
用回调确认一次重新分配
片段示例:下面代码假设已经创建名为 consumer 的 KafkaConsumer<String, String>,并已配置 group.id。它不负责创建消费者,只用于把 Rebalance 回调打印出来,帮助确认分区何时被撤销和重新分配。
consumer.subscribe(List.of("orders"), new ConsumerRebalanceListener() {
    @Override
    public void onPartitionsRevoked(Collection<TopicPartition> partitions) {
        System.out.println("revoked=" + partitions);
    }

    @Override
    public void onPartitionsAssigned(Collection<TopicPartition> partitions) {
        System.out.println("assigned=" + partitions);
    }
});
验证时先保持一个消费者运行,再启动同一 group.id 的第二个消费者,或让其中一个成员退出。采用 eager 分配器时,常见现象是先看到原分区被撤销,再看到新的分区集合被分配;使用 cooperative 分配器时,撤销集合可能只包含需要迁移的分区,而不是全量分区。
预期结果的形态类似下面这样,实际 Topic、分区编号和每次分配数量会随测试环境不同:
revoked=[orders-0, orders-1]
assigned=[orders-0]
先排除不会触发的变化
排障时可以把问题压缩成一个检查顺序:先看成员数是否变化,再看成员是否超时;接着看订阅范围是否变化;最后看 Topic 的 partition 集合是否变化。四项都没有变化时,不要因为看到消费延迟、offset 提交或消息堆积就直接归因于 Rebalance。
对于手工 assign() 分区的消费者,也要单独看待:它不参与消费组的自动分区分配,因此不会因为组成员变化而走常规的 group rebalance 分配流程。真正的判断标准始终是:是否有一份由消费组协调器维护的自动分配结果需要重新计算。