
Java / 系统课时
分析分配速率与分配热点
分析分配速率与分配热点
频繁 Young GC 不一定是堆太小,也可能是应用每秒制造了大量短命对象。本节以 HotSpot JDK 21+ 的 JFR 为主线,从“GC 很频繁”追到“哪些类型在分配、由哪条调用路径产生”,并区分统计采样与精确计数,避免把 JFR 样本直接当成对象总数。
学习目标
- 用 JFR 记录对象分配与 GC 事件,并从录制文件中提取分配热点
- 根据对象类型、采样权重和调用栈定位高分配代码路径
- 结合 Young GC 时间线判断 GC 频率是否主要由分配压力驱动
先建立判断链路
分配热点分析不要从“某个类看起来很多”开始,而应先确认现象。一个可靠的证据链是:单位时间分配量上升,Eden 更快被填满,Young GC 间隔缩短,同时 JFR 的分配样本集中到少数类型和调用栈。
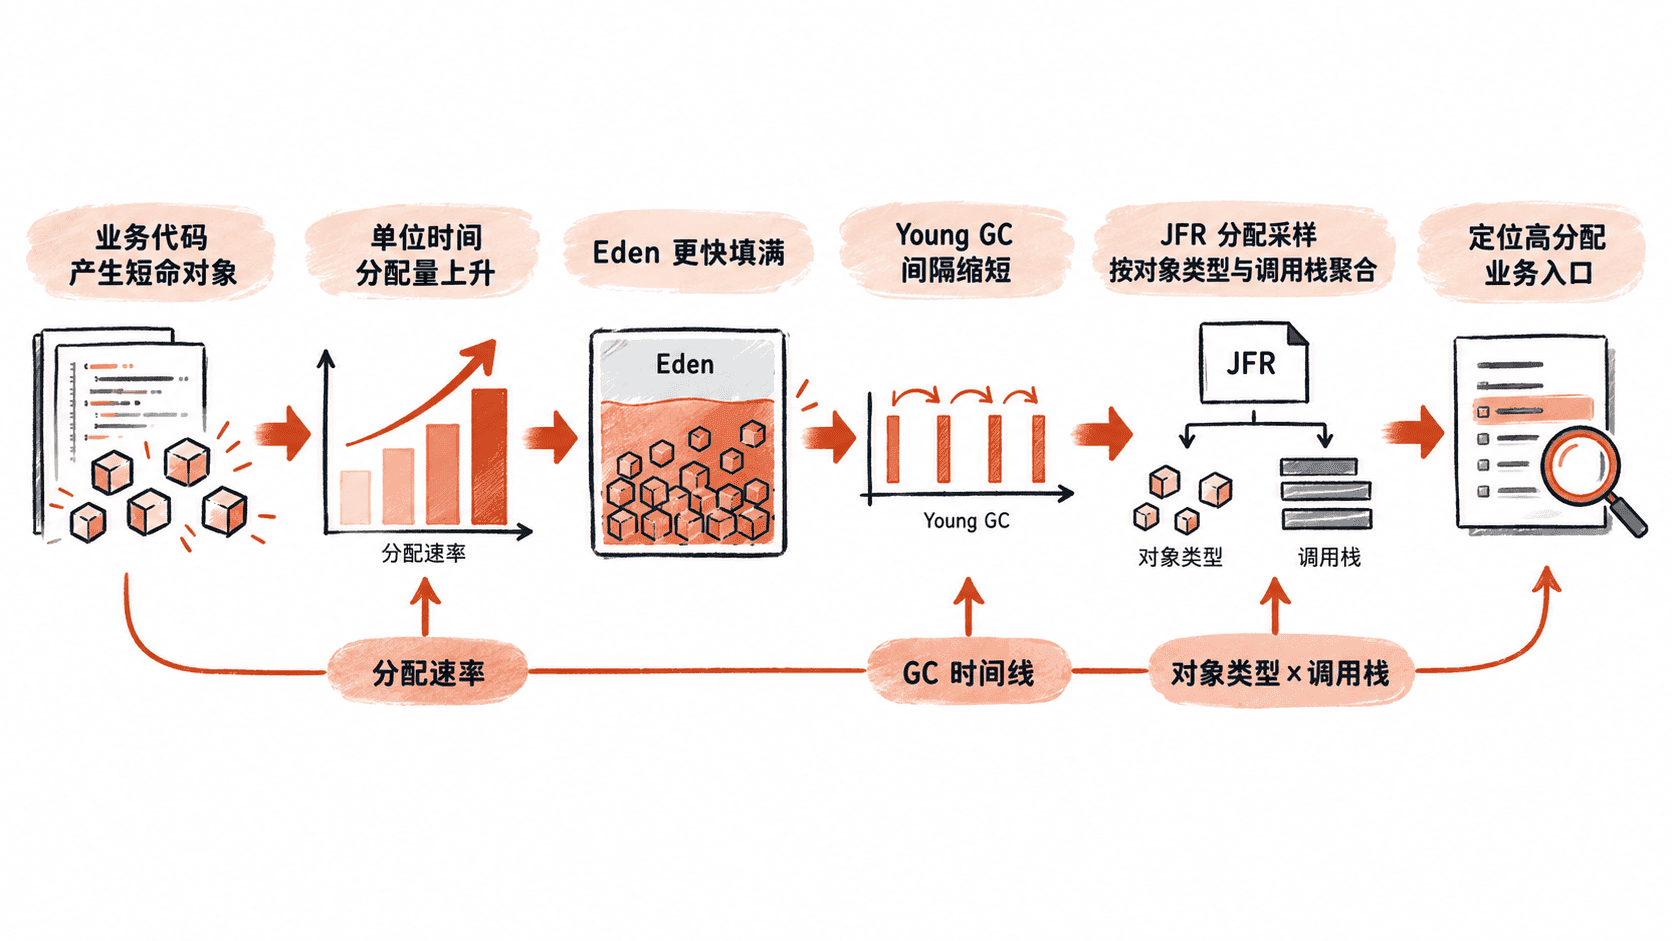
如果只有 Young GC 次数增加,却没有明显的分配速率上升,还应检查年轻代容量变化、存活对象比例、晋升压力或收集器调参。反过来,如果分配量很高但暂停可控,也不能仅凭“对象多”认定存在性能故障。
录制一段可分析的 JFR
下面程序刻意制造两类分配:大量 String 和 1 KiB 的 byte[]。对象被保存到容器后再整体替换,既能产生持续分配,也不会无限增长到 OOM。
import java.util.ArrayList;
import java.util.List;

public final class AllocationHotspotDemo {
    private static volatile Object sink;

    public static void main(String[] args) {
        for (int round = 0; round < 2_000; round++) {
            buildMessages();
            buildPayloads();
        }
        System.out.println("done");
    }

    private static void buildMessages() {
        List<String> messages = new ArrayList<>(2_000);
        for (int i = 0; i < 2_000; i++) {
            messages.add("order-" + i + "-" + System.nanoTime());
        }
        sink = messages;
    }

    private static void buildPayloads() {
        byte[][] payloads = new byte[2_000][];
        for (int i = 0; i < payloads.length; i++) {
            payloads[i] = new byte[1_024];
        }
        sink = payloads;
    }
}
编译并使用 profile 配置启动 JFR:
javac AllocationHotspotDemo.java
java -Xms256m -Xmx256m -XX:StartFlightRecording=filename=alloc.jfr,settings=profile,dumponexit=true AllocationHotspotDemo
预期结果是程序正常结束并生成 alloc.jfr;JFR 的启动提示、记录 ID 和耗时会随 JDK 与环境变化:
[<TIME>s][info][jfr,startup] Started recording <ID>.
...
done
如果业务进程已经在运行,也可以临时录制 60 秒:
jcmd <PID> JFR.start name=alloc settings=profile duration=60s filename=<PATH>/alloc.jfr预期结果是 JVM 接受录制请求,并在指定位置写出文件;记录 ID 与实际路径可能不同:
Started recording <ID>. The result will be written to:
<PATH>/alloc.jfr
生产环境应先评估录制时长和事件配置,优先使用受控时间窗口,而不是长期打开高成本事件。
找出高分配类型与调用栈
先确认录制里确实包含分配事件,再打印对象分配采样:
jfr summary alloc.jfr
jfr print --events jdk.ObjectAllocationSample alloc.jfr预期结果中,jfr summary 会列出事件计数;分配样本会给出对象类型、weight、线程和调用栈。实际样本数量与权重取决于运行时采样:
jdk.ObjectAllocationSample {
  startTime = <TIME>
  objectClass = byte[] (classLoader = bootstrap)
  weight = <VALUE> bytes
  eventThread = "main" (javaThreadId = <ID>)
  stackTrace = [
    AllocationHotspotDemo.buildPayloads() line: <VALUE>
    AllocationHotspotDemo.main() line: <VALUE>
  ]
}
jdk.ObjectAllocationSample 是统计采样事件,不是“每创建一个对象就记录一次”。weight 表示该样本代表的估算分配字节,因此适合按分配体量排序热点,不适合把事件条数直接解释成对象精确数量。
如果需要补充分配路径信息,可以关注 jdk.ObjectAllocationInNewTLAB 与 jdk.ObjectAllocationOutsideTLAB。前者更接近“触发新 TLAB 的那次分配”,并不等于 TLAB 内所有对象;后者用于观察绕过 TLAB 的分配,因此两者都不能单独替代总分配速率。
把分配热点和 Young GC 对上时间
同一份录制中再查看 GC 事件:
jfr print --events jdk.GarbageCollection alloc.jfr预期结果会按时间列出 GC 事件,字段随收集器和 JDK 版本略有差异:
jdk.GarbageCollection {
  startTime = <TIME>
  duration = <VALUE> ms
  gcId = <ID>
  name = "<VALUE>"
  cause = "<VALUE>"
}
判断“Young GC 主要来自分配压力”时,需要看到三个信号同时成立:GC 间隔因持续分配而缩短;分配采样的总权重在相同时间窗内较高;热点调用栈能够解释这些短命对象为何大量出现。只看到 byte[] 很多还不够,必须继续沿栈找到真正的业务入口,例如序列化、日志拼接、临时缓冲区或批处理转换。
从热点到可验证的优化
定位到调用路径后,一次只改一个主要分配源,再用相同负载重新录制 JFR。有效优化应表现为该调用栈的分配权重下降,同时单位时间 Young GC 次数、GC CPU 或业务延迟至少有一个得到改善,而且不能用更高的老年代占用换取表面上的 Young GC 减少。
如果热点来自框架或第三方库,先确认版本和配置是否提供低分配模式,再决定是否替换实现。分配治理的终点不是“零分配”,而是在可接受的代码复杂度下减少没有业务价值的对象创建,并用同样的观测方法证明收益。