
Java / 系统课时
从 G1 迁移到 ZGC 并验证
从 G1 迁移到 ZGC 并验证
本课把“换成 ZGC 会不会更快”变成可验证的迁移实验。你将保持应用、JDK、资源和流量不变,只替换收集器,分别记录尾延迟、CPU、吞吐与内存,再用明确的验收条件决定继续迁移、补充调优或保留 G1。
学习目标
- 搭建 G1 与 ZGC 的同负载对照实验,避免把其他变量混入结果。
- 正确准备两套 JVM 参数,并验证实际启用的收集器。
- 根据尾延迟、CPU、吞吐、内存和 GC 异常信号做迁移决策。
先固定对照实验边界
以下以 JDK 21 为实验基线,ZGC 使用 Generational ZGC。对照实验必须保持 JDK 构建、应用制品、CPU 配额、容器内存、Xms、Xmx、请求数据、预热时长、压测时长和目标负载一致。首次比较时不要同时修改堆大小、线程池、缓存或业务参数。
迁移时也不要把 G1 专属调优项原样带给 ZGC。像 G1 region、IHOP、mixed GC 等参数属于不同回收机制;ZGC 首轮应从最小必要配置开始,否则你无法判断结果来自“收集器变化”还是“历史参数副作用”。
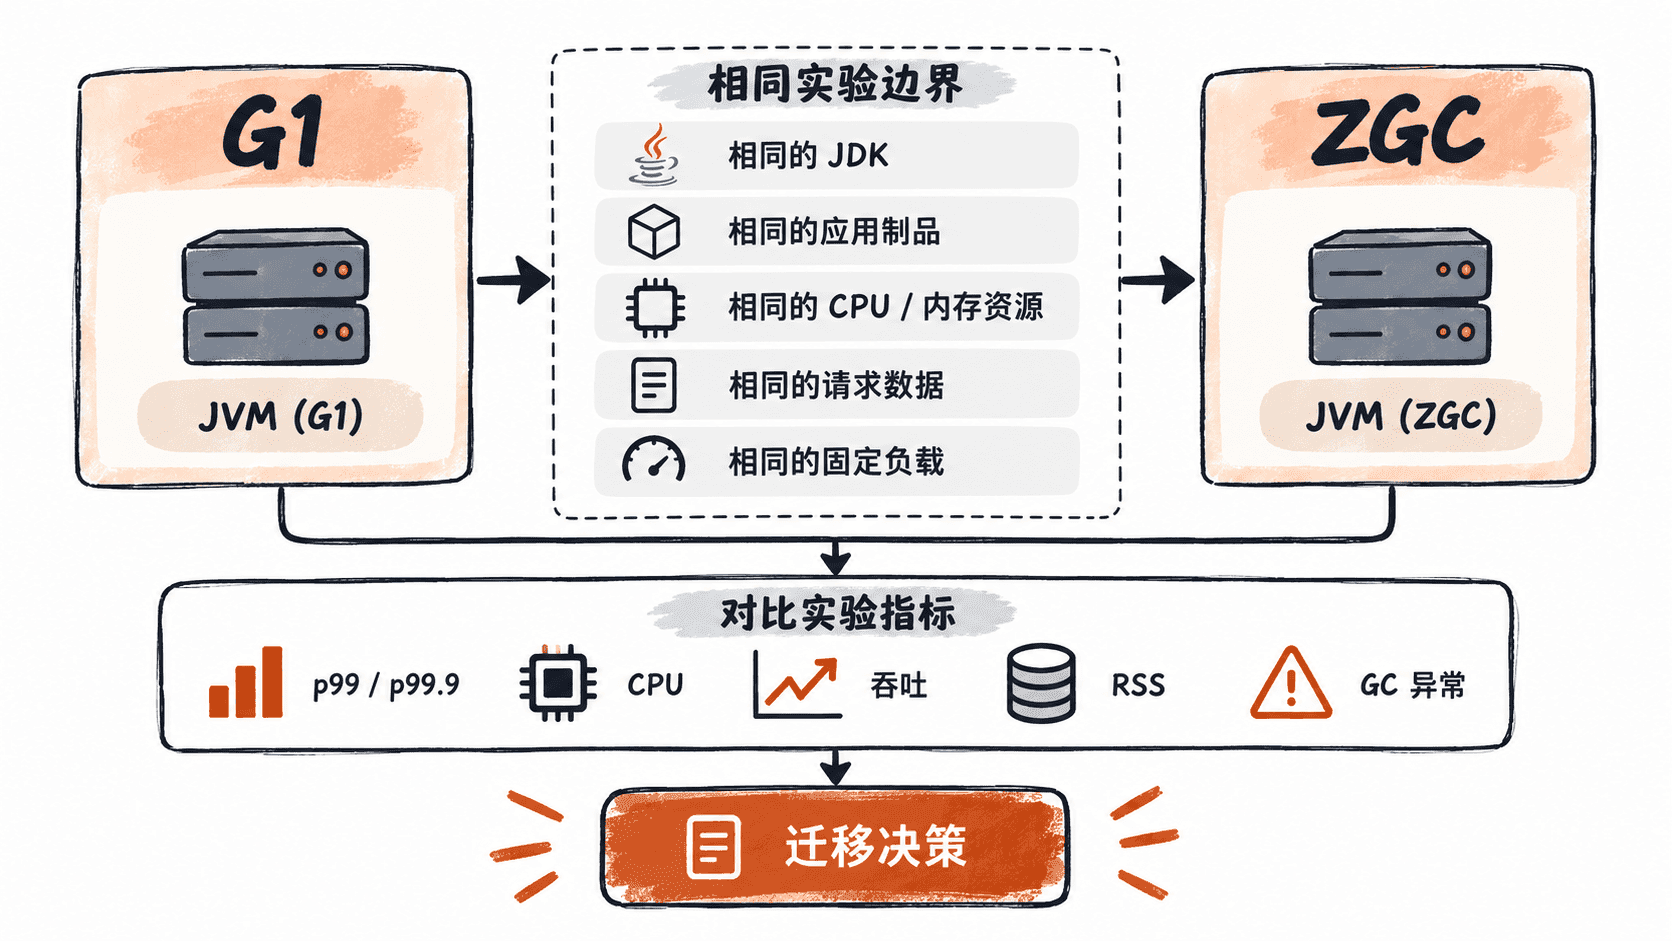
为了减少偶然波动,每个收集器至少重复多轮测试,并比较中位结果与最差一轮,而不是只挑最好的一次。若业务有明确 SLO,应先写下验收线,例如“固定请求速率下 p99.9 必须下降,错误率不升,CPU 与 RSS 不超过现有预算”。
准备两套最小启动参数
片段示例:假设当前 G1 没有必须保留的特殊诊断参数,应用包位于 \<PATH>/app.jar。两组都使用 -Xms2g -Xmx8g,并记录同粒度 GC 日志;实际压测时应分别启动,不能同时占用同一服务端口。
# G1 基线
java \
  -XX:+UseG1GC \
  -Xms2g \
  -Xmx8g \
  -Xlog:gc*,safepoint:file=<PATH>/gc-g1.log:time,uptime,level,tags \
  -jar <PATH>/app.jar

# ZGC 候选,JDK 21
java \
  -XX:+UseZGC \
  -XX:+ZGenerational \
  -Xms2g \
  -Xmx8g \
  -Xlog:gc*,safepoint:file=<PATH>/gc-zgc.log:time,uptime,level,tags \
  -jar <PATH>/app.jar
预期结果:
两次运行都应正常启动同一应用。
G1 运行生成 <PATH>/gc-g1.log。
ZGC 运行生成 <PATH>/gc-zgc.log。
JDK 23 已默认使用 generational ZGC;JDK 24 及更高版本则移除了 ZGenerational 选项,因此在这些版本上应使用 -XX:+UseZGC,不要机械复制 JDK 21 的开关。
启动后先验证实际生效的收集器,而不是只相信部署脚本。将 <PID> 替换为对应 JVM 的进程号。
jcmd <PID> VM.flags | grep -E 'UseG1GC|UseZGC|ZGenerational'预期结果:
G1 进程的关键结果应包含:
... -XX:+UseG1GC ...

JDK 21 的 ZGC 进程关键结果应包含:
... -XX:+UseZGC ...
... -XX:+ZGenerational ...
如果验证结果与预期不同,先修正启动参数或启动脚本,再进行压测;否则后续所有“G1 对比 ZGC”的结论都不可信。
用同一负载采集四类结果
压测应先预热到 JIT、连接池和缓存进入稳定状态,再进入固定测量窗口。对延迟敏感服务,优先使用能维持固定发送速率的压测方式,避免服务变慢后客户端自动降压,从而掩盖最差延迟。
至少记录以下指标,并把两组结果按相同时间窗口对齐:
| 维度 | 必看指标 | 判读重点 |
|---|---|---|
| 延迟 | p50、p99、p99.9、最大值 | ZGC 的价值主要应体现在尾延迟,而不是只看平均值 |
| CPU 与吞吐 | 进程 CPU、成功 RPS、错误率 | 低停顿不能以不可接受的 CPU 或吞吐损失换取 |
| 内存 | heap used、committed、进程 RSS | 相同 Xmx 不代表相同 RSS,必须测进程级内存 |
| GC | pause、cycle、Allocation Stall、OOM | 查找极端停顿、分配等待和容量不足证据 |
G1 与 ZGC 的 GC 日志事件名称和周期结构不同,所以不要用“GC 次数越少越好”这种单指标比较。更有意义的是把 GC 日志与同一时刻的 CPU、吞吐和尾延迟关联起来:用户请求是否真的少受停顿影响,才是迁移目标。
用验收条件做决策
如果 ZGC 在相同负载下显著压低 p99/p99.9,同时成功吞吐不下降,CPU 和 RSS 仍在预算内,而且日志中没有持续的分配停顿或容量告警,那么它具备迁移价值。接下来再针对 ZGC 单独调 Xmx、SoftMaxHeapSize 等参数,而不是把首次对照实验做成多变量优化。
如果尾延迟改善很小,但 CPU 或 RSS 明显上升,继续使用 G1 往往更合理;如果 ZGC 尾延迟改善明显但资源成本略超预算,则应先做单变量调优,再重复同一对照实验。任何一项结果都应以多轮稳定测试为依据,而不是一次峰值或一次最佳值。
灰度上线并保留回滚路径
压测通过不等于生产迁移完成。上线时先让少量实例使用 ZGC,其余实例继续 G1,保持相同业务流量分布和监控口径;确认真实流量下的 p99/p99.9、CPU、RSS、错误率以及 GC 日志都符合实验结论后,再逐步扩大比例。
回滚条件必须在灰度前写清,例如尾延迟超过 SLO、CPU 长时间越过预算、RSS 接近容器上限或出现持续 Allocation Stall。这样迁移决策就从“ZGC 理论上低停顿”变成“在本服务、本负载和本资源预算下有可重复收益”,也能在收益不成立时快速恢复到已验证的 G1 基线。