
Java / 系统课时
使用 NMT 定位本地内存增长
使用 NMT 定位本地内存增长
当 Java 堆没有明显上涨,但进程 RSS 或容器内存持续逼近上限时,NMT 可以把 HotSpot 的本地内存按线程、类、代码缓存和内部结构拆开比较。本课用“基线—差分—下钻”的方式,把模糊的非堆增长缩小到可继续验证的范围。
学习目标
- 正确启用 NMT,并理解
reserved、committed与进程 RSS 的区别。 - 使用
baseline和summary.diff判断哪个本地内存类别持续增长。 - 根据
Thread、Class、Code、Internal的变化选择下一步证据。
先确认 NMT 能回答什么
NMT 是 HotSpot 自身的本地内存账本,适合回答“JVM 的哪一类本地内存在增长”。它不是整个进程的 RSS 明细:第三方 native 库等分配可能不在 NMT 中,因此 NMT 总量与操作系统看到的进程内存不要求完全相等。
还要区分 reserved 与 committed。前者表示为某个区域预留的虚拟地址空间,后者表示已经提交、可实际使用的部分。排查内存压力时,不能看到很大的 reserved 就直接认定发生泄漏,应重点观察 committed、类别计数以及一段时间内的增量。
建立可比较的基线
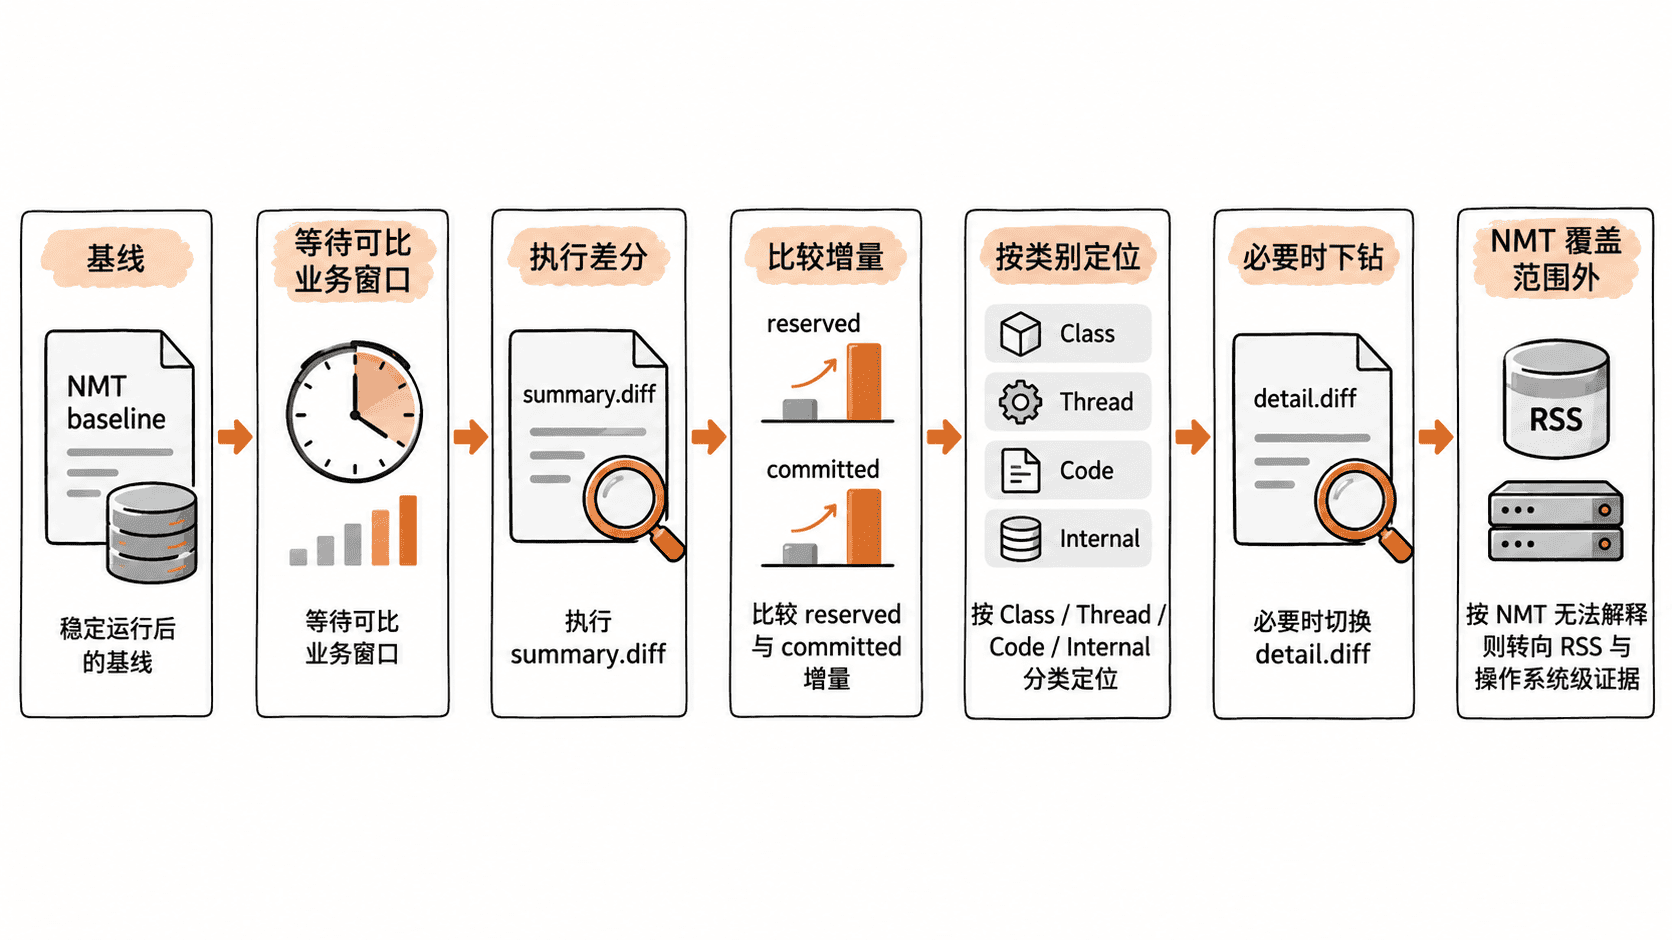
一般先用 summary 模式定位大类;只有需要追到更细调用点时,才在后续重启中改用 detail。片段示例:把下面的 JVM 参数加入应用启动配置,并重启进程使其生效。
-XX:NativeMemoryTracking=summary应用完成预热、类加载和 JIT 初始波动后,再查看一次摘要并建立基线:
jcmd <PID> VM.native_memory summary scale=MB
jcmd <PID> VM.native_memory baseline
预期输出
<PID>:
Native Memory Tracking:
Total: reserved=<VALUE>MB, committed=<VALUE>MB
-                 Java Heap (reserved=<VALUE>MB, committed=<VALUE>MB)
-                     Class (reserved=<VALUE>MB, committed=<VALUE>MB)
-                    Thread (reserved=<VALUE>MB, committed=<VALUE>MB)
-                      Code (reserved=<VALUE>MB, committed=<VALUE>MB)
...
<PID>:
Baseline succeeded
<PID> 和各项 <VALUE> 会随进程与负载变化。基线应放在业务进入稳定状态之后,否则启动期的类加载、编译和线程初始化会被误算成异常增长。
用差分锁定增长类别
等待一个能覆盖问题复现窗口的时间段,并尽量保持业务负载可比较,然后执行差分:
jcmd <PID> VM.native_memory summary.diff scale=MB预期输出
<PID>:
Native Memory Tracking:
Total: reserved=<VALUE>MB +<VALUE>MB, committed=<VALUE>MB +<VALUE>MB
-                     Class (reserved=<VALUE>MB +<VALUE>MB, committed=<VALUE>MB +<VALUE>MB)
-                    Thread (reserved=<VALUE>MB +<VALUE>MB, committed=<VALUE>MB +<VALUE>MB)
-                      Code (reserved=<VALUE>MB +<VALUE>MB, committed=<VALUE>MB +<VALUE>MB)
-                  Internal (reserved=<VALUE>MB +<VALUE>MB, committed=<VALUE>MB +<VALUE>MB)
差分中的正负值才是关键。单次快照只能说明“现在用了多少”,连续差分才能说明“谁在持续长”。最好重复采样几个相似业务周期,排除正常预热、流量突增和批处理阶段带来的暂时扩张。
把类别变化映射到根因
| NMT 类别 | 重点一起看 | 常见判断方向 |
|---|---|---|
Thread |
thread 数、stack 的 reserved/committed | 线程池失控、线程泄漏、栈配置过大 |
Class |
classes 数量、Metaspace/Class space | 动态类生成、类加载器无法回收 |
Code |
Code committed | JIT 编译和代码缓存增长;启动期增长常属正常 |
Internal |
committed 增量是否持续 | HotSpot 内部 native 分配,需要更细证据确认 |
例如 Thread 的 committed 与线程数同时持续增加,比只看到 Thread reserved 很大更有诊断价值;Class 增长则要同时确认类数量是否也在爬升。不要只凭类别名直接下结论,要把内存增量与对应对象数量、业务时间线放在一起看。
若 summary 已经稳定指向某一类别,而仍无法解释增长,可在下一次重启改为更细粒度。片段示例:把当前 NMT 启动参数替换为下面的配置。
-XX:NativeMemoryTracking=detail随后重新建立基线,再使用 detail.diff 查看更细的分配信息。summary 运行中的 JVM 不能直接切换成 detail,因此应先用较低粒度缩小范围,再决定是否承担更高的观测成本。
NMT 对不上 RSS 时怎么判断
如果操作系统看到 RSS 明显上涨,而 NMT 的 committed 总量与各类别差分都解释不了这部分增量,不要继续在 NMT 类别里强行找答案。此时更应该怀疑 NMT 覆盖范围之外的 native 分配、共享库或内存映射,并转向操作系统级内存映射、容器指标以及 native profiler。
NMT 最有价值的用法不是“看一张大表”,而是建立稳定基线后看趋势:先确认总量差异,再找增长类别,最后决定是否下钻 detail 或离开 NMT。这样才能把非堆故障从“进程内存一直涨”收敛成一个可验证的具体方向。