
Java / 系统课时
排查 Direct Buffer OOM
排查 Direct Buffer OOM
Direct Buffer OOM 常见于网络通信、NIO 文件处理或框架缓冲池:Java 堆看起来还有空间,但进程无法继续申请直接缓冲区。排查时要同时看直接内存上限、BufferPool 使用量、对象保留关系和操作系统内存余量,而不是只调大堆或反复触发 GC。
学习目标
- 判断异常是否来自 NIO direct buffer,并确认
MaxDirectMemorySize的实际限制。 - 理解
DirectByteBuffer包装对象、堆外内存与 Cleaner 回收之间的生命周期关系。 - 区分缓冲区泄漏、瞬时分配过快、池化配置不当和文件映射增长,并完成修复验证。
先锁定异常与内存上限
常见现场包含 java.lang.OutOfMemoryError: Cannot reserve ... bytes of direct buffer memory。先确认启动参数中的直接缓冲区上限;-XX:MaxDirectMemorySize 控制 java.nio direct buffer 可使用的最大直接内存额度,未显式设置时由 JVM 自动选择默认值。
jcmd <PID> VM.flags -all | grep MaxDirectMemorySize预期输出包含该 JVM flag,实际字节数和标记信息可能不同:
size_t MaxDirectMemorySize = <VALUE> ...如果异常不是 direct buffer 的保留失败,而是容器直接被 OOMKill、RSS 持续上涨或 native malloc 失败,就不要仅凭这个参数下结论。线程栈、Metaspace、Code Cache、JNI/本地库和内存映射都可能占用进程地址空间或物理内存。
看懂 DirectByteBuffer 的回收生命周期
ByteBuffer.allocateDirect() 返回的 DirectByteBuffer 包装对象位于 Java 堆中,但真正的缓冲内容位于堆外 native memory。普通 direct buffer 不再被应用引用后,关联的清理机制才有机会释放这块堆外内存;因此,包装对象是否存活与 native buffer 何时真正释放并不是简单同步的关系。调用 clear() 只是重置 position、limit 等读写状态,并不等于释放堆外内存。
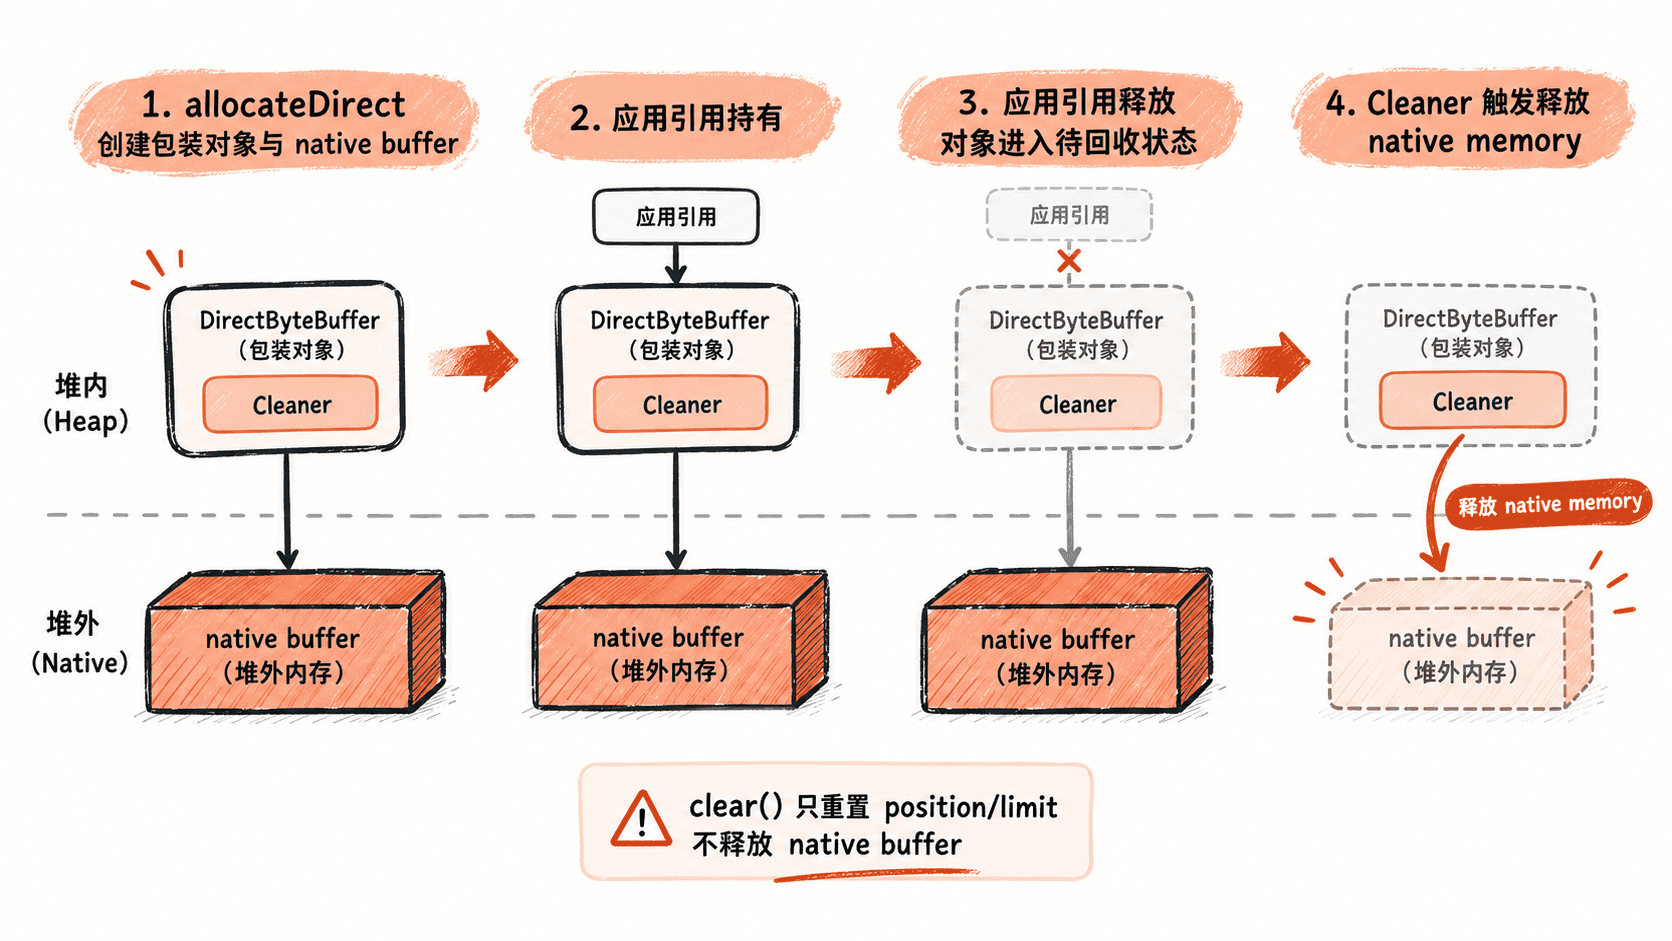
这解释了一个常见误判:一次 Full GC 后堆使用率下降,并不保证 direct memory 会按同样幅度、同一时刻下降;反过来,堆里看到的 DirectByteBuffer 包装对象本身通常也很小,不能用它的浅堆大小推算 native buffer 的实际容量。排查时应把“堆对象数量”和“堆外容量”作为两个不同指标观察。
用 BufferPool 指标判断是哪种增长
JDK 提供 BufferPoolMXBean,可以读取 direct、mapped 等 buffer pool 的数量、已用内存估计值和总容量。生产环境最好把这些值接入现有 JMX/指标系统持续观察;下面的完整示例演示如何读取当前 JVM 的 buffer pool。
import java.lang.management.BufferPoolMXBean;
import java.lang.management.ManagementFactory;

public class BufferPoolProbe {
    public static void main(String[] args) {
        for (BufferPoolMXBean pool :
                ManagementFactory.getPlatformMXBeans(BufferPoolMXBean.class)) {
            System.out.printf(
                    "name=%s count=%d memoryUsed=%d totalCapacity=%d%n",
                    pool.getName(),
                    pool.getCount(),
                    pool.getMemoryUsed(),
                    pool.getTotalCapacity());
        }
    }
}
预期输出会至少列出当前 JVM 支持的 buffer pool,实际名称、数量和字节数可能不同:
name=direct count=<VALUE> memoryUsed=<VALUE> totalCapacity=<VALUE>
name=mapped count=<VALUE> memoryUsed=<VALUE> totalCapacity=<VALUE>
把 direct 的 memoryUsed 与请求量、连接数和错误时间对齐:业务负载回落后仍持续增长,更像对象或缓冲池泄漏;高峰期迅速冲顶、随后能回落,更像容量与并发不匹配;count 大增但单个容量不大,则要查是否频繁创建小 buffer。若主要增长的是 mapped,应转向文件映射生命周期排查,不要把它直接等同于 MaxDirectMemorySize 问题。
从保留对象和分配速率定位根因
如果 direct 使用量长期不回落,先查谁还持有 buffer:未消费完的网络写队列、无界消息队列、缓存、ThreadLocal、未关闭的 channel/stream,以及框架池化缓冲区的引用计数错误都值得优先检查。必要时采集 heap dump,搜索 java.nio.DirectByteBuffer,重点看对象数量和到 GC Roots 的引用链;浅堆大小只代表包装对象本身,不能代表堆外容量。
如果对象最终能释放,但高并发阶段仍频繁 OOM,则关注“申请速度大于释放速度”。应减少每请求临时直接分配,优先复用或池化,限制并发与单次 buffer 大小,并检查是否把大文件一次性读入 direct buffer。对于 Netty 等框架,还要查看其自身 allocator、池化和引用计数指标,因为框架可能有独立的内存管理策略。
调整上限时给进程总内存留余量
增大 -XX:MaxDirectMemorySize 只适合确认 direct buffer 有合理、可解释的容量需求时使用。容器内必须按总进程预算核算:Java heap、direct buffer、Metaspace、线程栈、Code Cache、JIT/JVM 本身和其他 native 分配会共同占用内存。若只把 direct 上限顶到容器边界附近,应用可能从 Java OOM 变成更难诊断的 OOMKill。
修复后的验收应覆盖真实峰值流量:direct 的 memoryUsed 和 count 在负载稳定后进入平台,负载回落后能够下降或维持在池化设计允许的稳定水位;没有新的 direct-buffer OOM,同时进程 RSS 与容器内存仍保留安全余量。这样才能证明问题被消除,而不是仅把失败阈值向后移动。