
Java / 系统课时
排查 To-space exhausted 与 Full GC
排查 To-space exhausted 与 Full GC
当 G1 日志出现 to-space exhausted、Evacuation Failure 或紧随其后的 Full GC 时,核心问题不是“GC 太慢”这么简单,而是转移对象需要的目标空间、晋升速度与并发回收进度失去平衡。本篇给出一条按日志证据定位并验证修复的排查路径。
学习目标
- 区分 To-space exhausted、Evacuation Failure 与 Full GC 的因果关系
- 从堆余量、晋升压力、并发标记和 Humongous 对象判断根因
- 按风险从低到高选择修复手段,并用同负载 GC 日志验证
先确认到底发生了什么
G1 的 Young 或 Mixed GC 会把 Collection Set 中仍存活的对象复制到其他 Region。旧版 HotSpot 日志常用 to-space exhausted 表示目标空间不足;在较新的 JDK 中,同类问题会以 Evacuation Failure: Allocation 更明确地记录。如果原因是 Pinned,则说明存在暂时不能移动的对象,排查方向与单纯空间不足不同。
在已经开启 Unified GC Logging 的 gc.log 上先筛出关键事件:
grep -E "to-space exhausted|Evacuation Failure|Pause Full|Humongous regions|Concurrent Mark" <PATH>/gc.log预期输出(存在转移空间不足并退化为 Full GC 时,具体格式会随 JDK 版本变化):
<TIME> ... GC(<ID>) ... (Evacuation Failure: Allocation) ...
<TIME> ... GC(<ID>) Pause Full (G1 Compaction Pause) ...
如果只有 Pinned 而没有 Allocation,优先检查 JNI 临界区或其他导致对象被固定的本地代码;如果出现 Allocation,才进入“空间为什么不够”的主线。
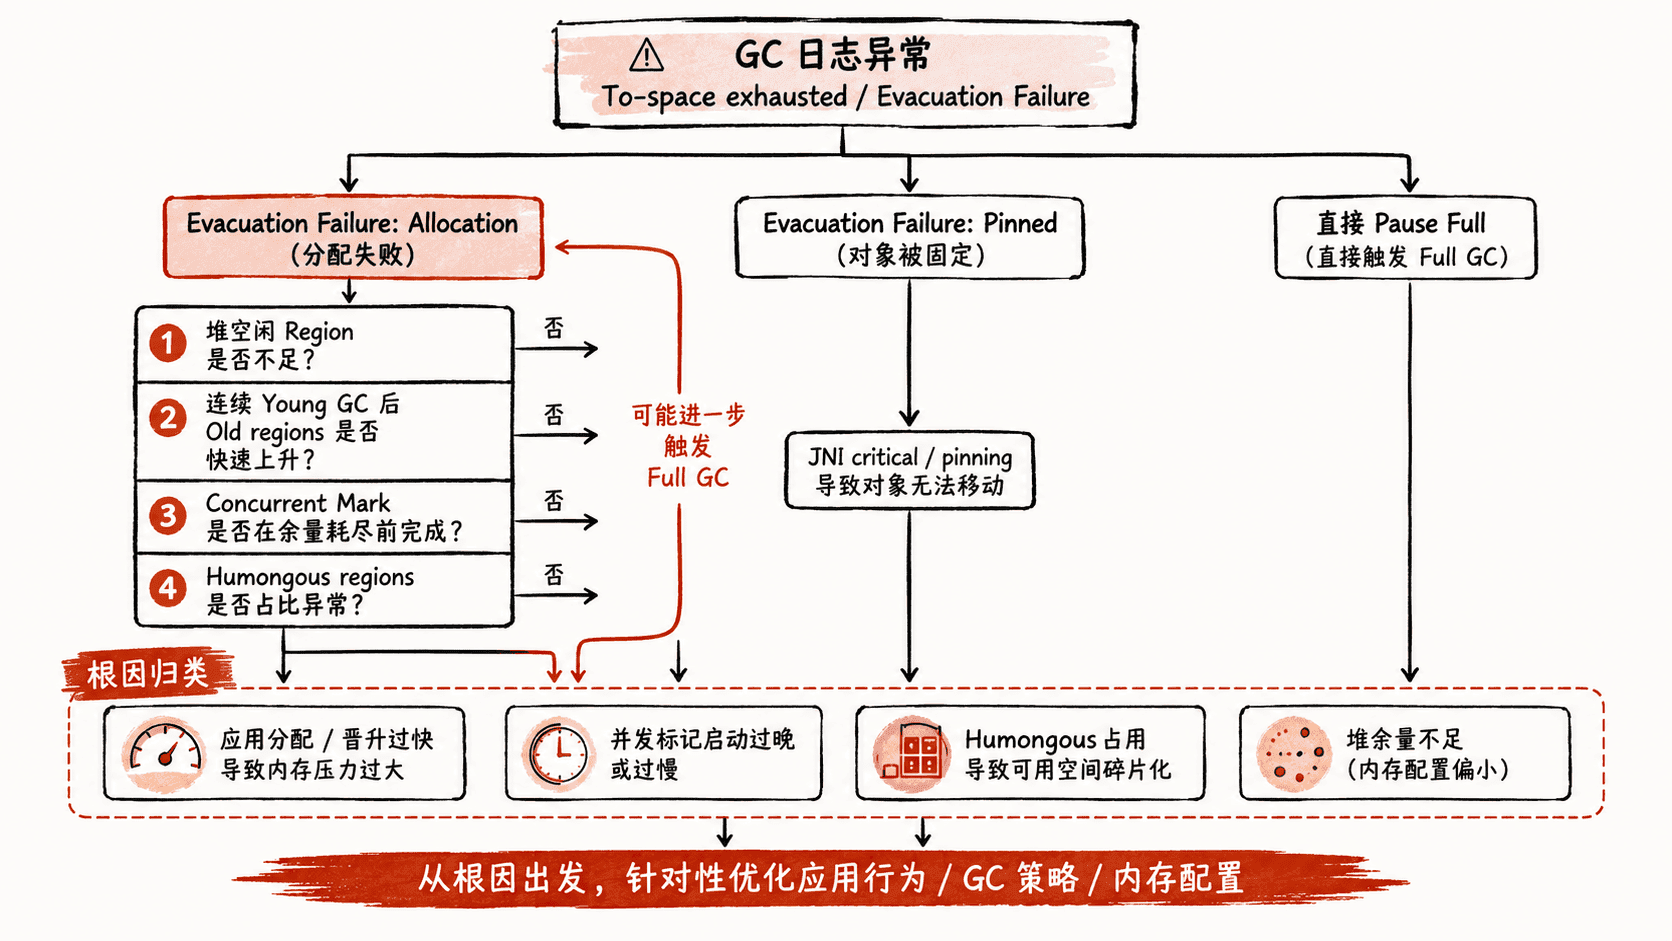
用三个时间序列找根因
不要只看某一次 GC 后的堆使用量。真正有价值的是故障前一段时间内的趋势:可用空间还剩多少、每次回收向 Old 区带入多少存活对象、并发标记能否赶在余量耗尽前完成。
| 观察信号 | 日志表现 | 主要含义 |
|---|---|---|
| 堆余量持续下降 | GC 后已用堆越来越高,空闲 Region 越来越少 | 转移时缺少可用目标 Region |
| 晋升压力过大 | 连续 Young GC 后 Old regions 明显阶梯式增长 |
短时间存活对象过多,Old 区被快速吃掉 |
| 标记进度落后 | Concurrent Mark 尚未完成,Old 区已逼近上限 | Mixed 回收启动太晚,回收速度落后于分配 |
| Humongous 占用高 | Humongous regions 长期较高或快速增加 |
大对象直接占用连续 Old Region,降低可用余量 |
判断“晋升过快”时,不要把一次 Old Region 增长就当成异常。缓存预热、批任务开始都可能造成短时上升;只有在多个 GC 周期持续增长,并且回收后的最低占用也不断抬高时,才说明 live set 或晋升速率正在挤压转移空间。
并发标记也不能只看有没有启动。G1 需要先完成标记,才能识别适合进入 Mixed GC 的 Old Region。如果应用在标记期间仍高速向 Old 区分配,而标记还没结束,最终就可能在“知道哪些旧区值得回收”之前先耗尽保留空间。
按证据选择修复动作
最优先的修复通常在应用侧。若故障前分配速率或晋升速率突然升高,应先定位大批量对象创建、请求峰值、缓存一次性扩容、队列积压或对象生命周期变长。只靠增大堆可以争取时间,但无法消除持续增长的 live set。
如果 live set 稳定,只是并发标记偶尔赶不上,可以增加堆余量,或在压测中小步提高 -XX:G1ReservePercent,让 G1 为转移保留更大的安全缓冲。若 CPU 仍有余量且 Concurrent Mark 明显过慢,再评估提高 -XX:ConcGCThreads;不要在 CPU 已饱和时机械增加并发 GC 线程。
如果 Adaptive IHOP 对突发负载预测失准,应先用更大的保留空间观察效果,再考虑关闭自适应并手工降低 -XX:InitiatingHeapOccupancyPercent。过早固定 IHOP 会让标记周期更频繁,可能用吞吐量换来并不必要的安全余量。
Humongous Region 很高时,先确认是否真的存在大量大数组、缓冲区或批量序列化结果。调整 -XX:G1HeapRegionSize 只应建立在对象尺寸分布证据上,因为 Region 变大会改变 Humongous 阈值和回收粒度,并不是通用的“消灭大对象”开关。
用同一负载验证是否真正恢复
修复后应使用相同堆上限、相同流量模型和足够长的稳定运行窗口复测。验收标准不是“Full GC 少了一次”,而是故障链条整体消失:不再出现 to-space exhausted 或 Evacuation Failure: Allocation,Old 区回收后的基线不再持续抬高,并发标记能够在安全余量耗尽前完成并进入有效的空间回收阶段。
同时比较 p99 延迟、GC CPU 与吞吐量。如果只是通过更频繁的并发标记或更大的 GC 线程数掩盖了空间问题,尾延迟可能改善,但业务吞吐会下降。真正稳定的结果应当同时满足“有足够转移空间、回收进度跟得上分配、没有重复 Full GC”这三个条件。