
Java / 系统课时
比较 HotSpot 主要收集器
比较 HotSpot 主要收集器
选择 GC 收集器不是寻找一个永远最快的选项,而是在吞吐量、暂停时间、CPU 开销、堆规模和运维复杂度之间做取舍。本篇以 JDK 21 LTS 的 HotSpot 为比较基准,梳理 Serial、Parallel、G1 与 ZGC 的执行模型和负载边界。
学习目标
- 区分 Serial、Parallel、G1 与 ZGC 的并行和并发执行模型
- 根据暂停目标、吞吐目标与堆规模选择合理的候选收集器
- 识别“低暂停”“高吞吐”等标签背后的成本与适用边界
先分清并行与并发
比较收集器前要先区分两个容易混淆的词。并行 GC 是多个 GC 工作线程同时执行收集工作,但应用线程此时可以仍然处于 STW;并发 GC 则表示部分垃圾收集工作能够与应用线程同时进行。
因此,Parallel GC 虽然能使用多个 CPU 核心加速收集,却仍然以较明显的 STW 为主要执行方式。G1 和 ZGC 会把更多工作放到并发阶段,但它们也不是“完全没有 STW”。根集合处理、线程协调或部分重定位相关阶段仍需要暂停,只是暂停目标和工作量不同。
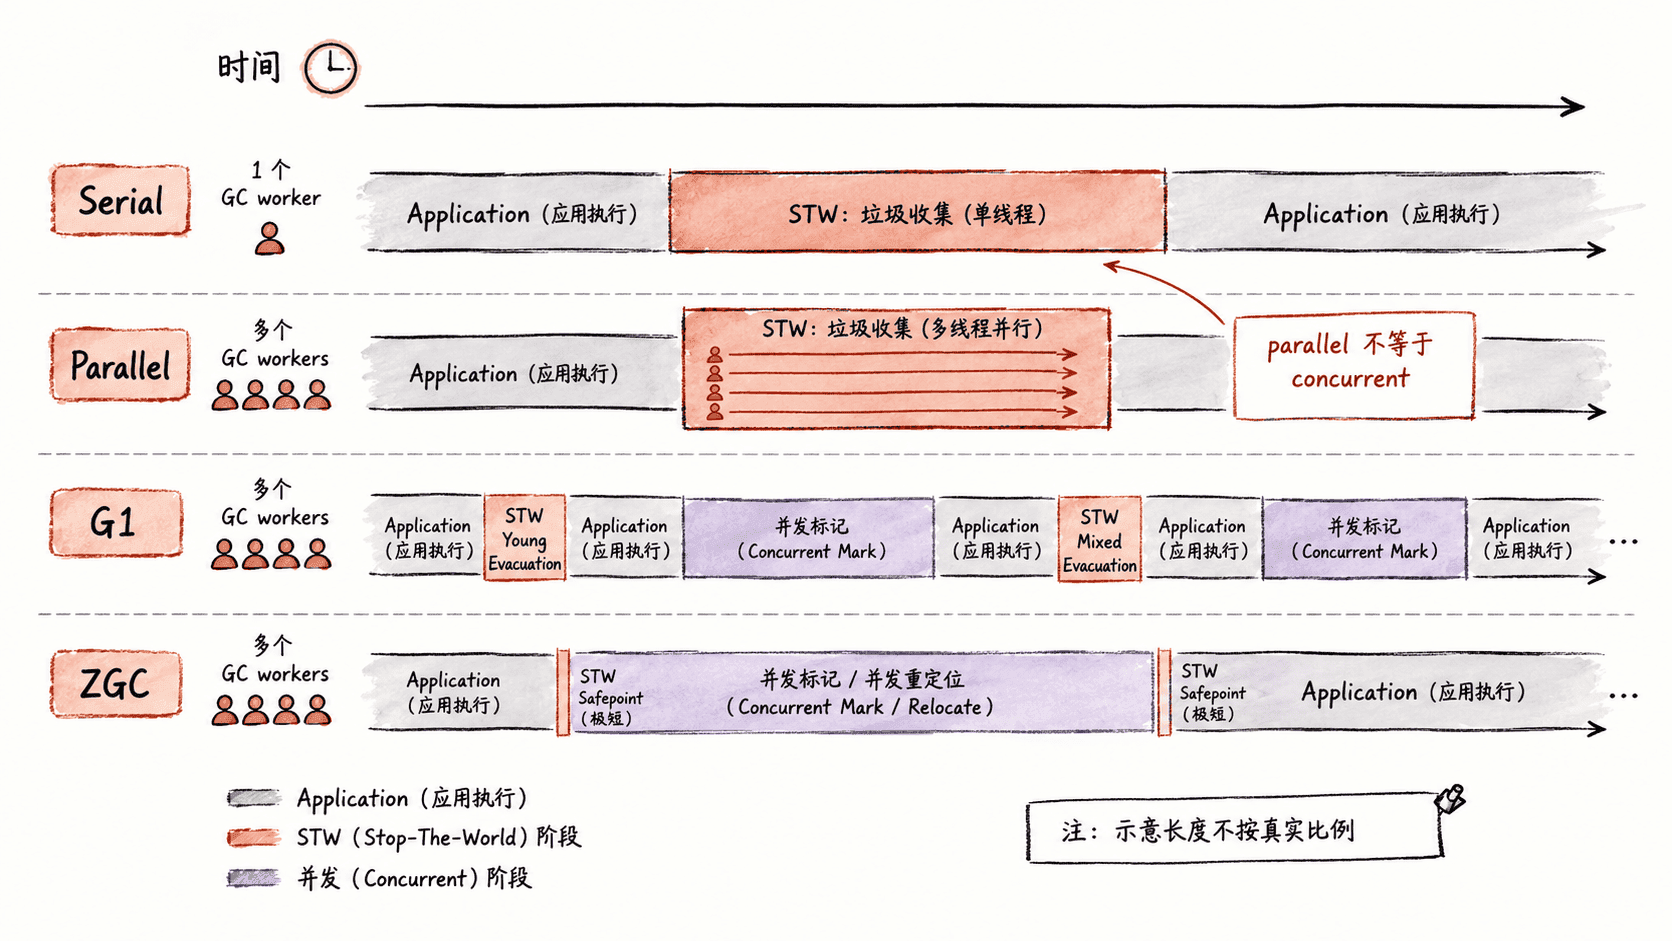
四种收集器解决的目标不同
| 收集器 | 主要执行模型 | 暂停特征 | 更典型的目标 |
|---|---|---|---|
| Serial | 单线程 STW 收集 | 暂停期间只有一个主要 GC 工作线程 | 小堆、CPU 资源有限、简单进程 |
| Parallel | 多线程并行 STW 收集 | 充分利用多核缩短一次收集,但暂停仍明显 | 最大化批处理吞吐量 |
| G1 | Region 化分代收集,并发标记配合 STW evacuation | 多次可预测性更强的 Young/Mixed Pause,仍可能出现重暂停 | 通用服务端负载、兼顾吞吐与暂停 |
| ZGC | 大量标记与重定位工作并发执行 | STW 工作被压缩到很短的阶段,暂停对大堆更友好 | 对尾延迟敏感的大堆在线服务 |
Serial 的优势主要是实现路径简单、额外线程和并发协调成本低。它不会因为“只有一个线程”就天然低效:对于几十或几百 MB 的小堆,启动额外 GC 线程和维护复杂并发状态未必值得。但堆增大后,单线程完成全部关键收集工作会迅速成为暂停瓶颈。
Parallel GC 的目标非常明确:在 STW 已经发生的前提下,动用多个 CPU 核心尽快完成垃圾收集,从而把更多总 CPU 时间留给业务。对于离线计算、批处理和允许周期性较长暂停的服务,它常常比追求极低延迟的收集器更符合目标。
G1 用 Region 换取暂停控制能力
G1 将堆划分为大量 Region,不要求老年代始终是一块连续区域。Young GC 和 Mixed GC 会选择一批 Region,在 STW 阶段把仍然存活的对象 evacuation 到其他 Region;全局存活情况的标记工作则可以有较大部分并发完成。
这套模型让 G1 能根据暂停目标和候选 Region 的回收收益决定一次收多少区域。-XX:MaxGCPauseMillis 表达的是暂停目标,而不是硬性 SLA:如果存活对象太多、分配速度过高、可用 Region 不足或者并发标记来不及完成,实际暂停仍然可能明显超过目标。
G1 因此适合作为通用服务端收集器,但它并不意味着“无需调优”。堆过度压满、晋升压力过大或留给 evacuation 的空间不足,都可能把原本平稳的 Young/Mixed GC 推向更重的回收路径。
ZGC 把更多工作移出 STW
ZGC 的核心方向是低暂停。它通过并发标记、并发重定位以及访问屏障等机制,让应用线程运行期间也能完成大量对象图处理和内存整理工作,因此堆扩大时不必把同等规模的对象处理工作全部塞进一次 STW 窗口。
代价是并发 GC 工作本身需要 CPU、内存余量和运行时屏障。一个 CPU 已长期接近饱和的吞吐型任务,切换到 ZGC 后并不保证整体处理能力提升;如果业务没有严格的尾延迟要求,额外的并发成本可能得不偿失。
本篇以 JDK 21 为基准。JDK 21 提供分代 ZGC,可通过 -XX:+ZGenerational 启用;后续 JDK 对 ZGC 默认模式已有演进,因此生产环境选择参数时应以实际运行的 JDK 版本为准,而不是直接复制其他版本的启动参数。
在目标 JDK 上确认实际收集器
不要只根据默认值猜测当前 JVM 使用了什么收集器。可以显式启动四种收集器,并让 Unified Logging 输出实际选择结果。以下命令适用于提供相应收集器的 JDK 21 HotSpot,示例使用 POSIX Shell 的 grep 过滤版本信息。
java -XX:+UseSerialGC -Xlog:gc=info -version 2>&1 | grep "Using"
java -XX:+UseParallelGC -Xlog:gc=info -version 2>&1 | grep "Using"
java -XX:+UseG1GC -Xlog:gc=info -version 2>&1 | grep "Using"
java -XX:+UseZGC -Xlog:gc=info -version 2>&1 | grep "Using"
预期输出
[<TIME>][info][gc] Using Serial
[<TIME>][info][gc] Using Parallel
[<TIME>][info][gc] Using G1
[<TIME>][info][gc] Using The Z Garbage Collector
日志时间会因每次独立进程启动而不同;部分 JDK 构建或平台若不支持某个收集器,会直接报告对应 JVM 参数不可用,此时不能把测试结果外推到另一套 JDK 或操作系统。
根据业务约束做选择
如果进程堆很小、核心数有限,而且暂停本身不是问题,Serial 的简单性可能已经足够。批处理任务更在意单位时间完成多少工作、可以容忍停顿时,应优先把 Parallel 纳入基准测试。
在线服务既不能接受很长的 Full GC,又希望保持较高吞吐时,G1 通常是更平衡的起点;真正受 P99、P999 尾延迟约束,且堆规模较大时,再重点评估 ZGC。这里的“选择”都只是候选方向,最终必须在相同数据量、相同堆大小和相同业务负载下比较吞吐、暂停分布、CPU 使用率以及堆余量。
收集器名称本身不是性能结论。Parallel 的长 STW 可能完全符合离线任务目标,ZGC 的短暂停也可能以更高 CPU 成本换来。先确定业务到底优化吞吐还是尾延迟,再用实际负载验证,才能避免把“先进收集器”误当成“适合所有应用的收集器”。