
Java / 系统课时
建立 GC 异常分诊流程
建立 GC 异常分诊流程
生产出现延迟抖动、GC 频率突增或内存持续上涨时,首轮目标不是立刻“调参数”,而是快速判断问题属于停顿、分配压力、存活集增长、OOM 还是堆外/RSS 异常,并按低风险到高成本的顺序固定证据。
学习目标
- 能按症状把 GC 异常分到可验证的首轮路径
- 能使用
jcmd、GC 日志和 JFR 采集关键证据 - 能区分 Java 堆问题与进程 RSS、原生内存问题
先按现象分流
同样是“内存高”,根因可能完全不同。首轮分诊应先看用户侧症状和进程级指标,再进入 JVM 内部,避免只凭一次 Full GC 或一次堆快照下结论。
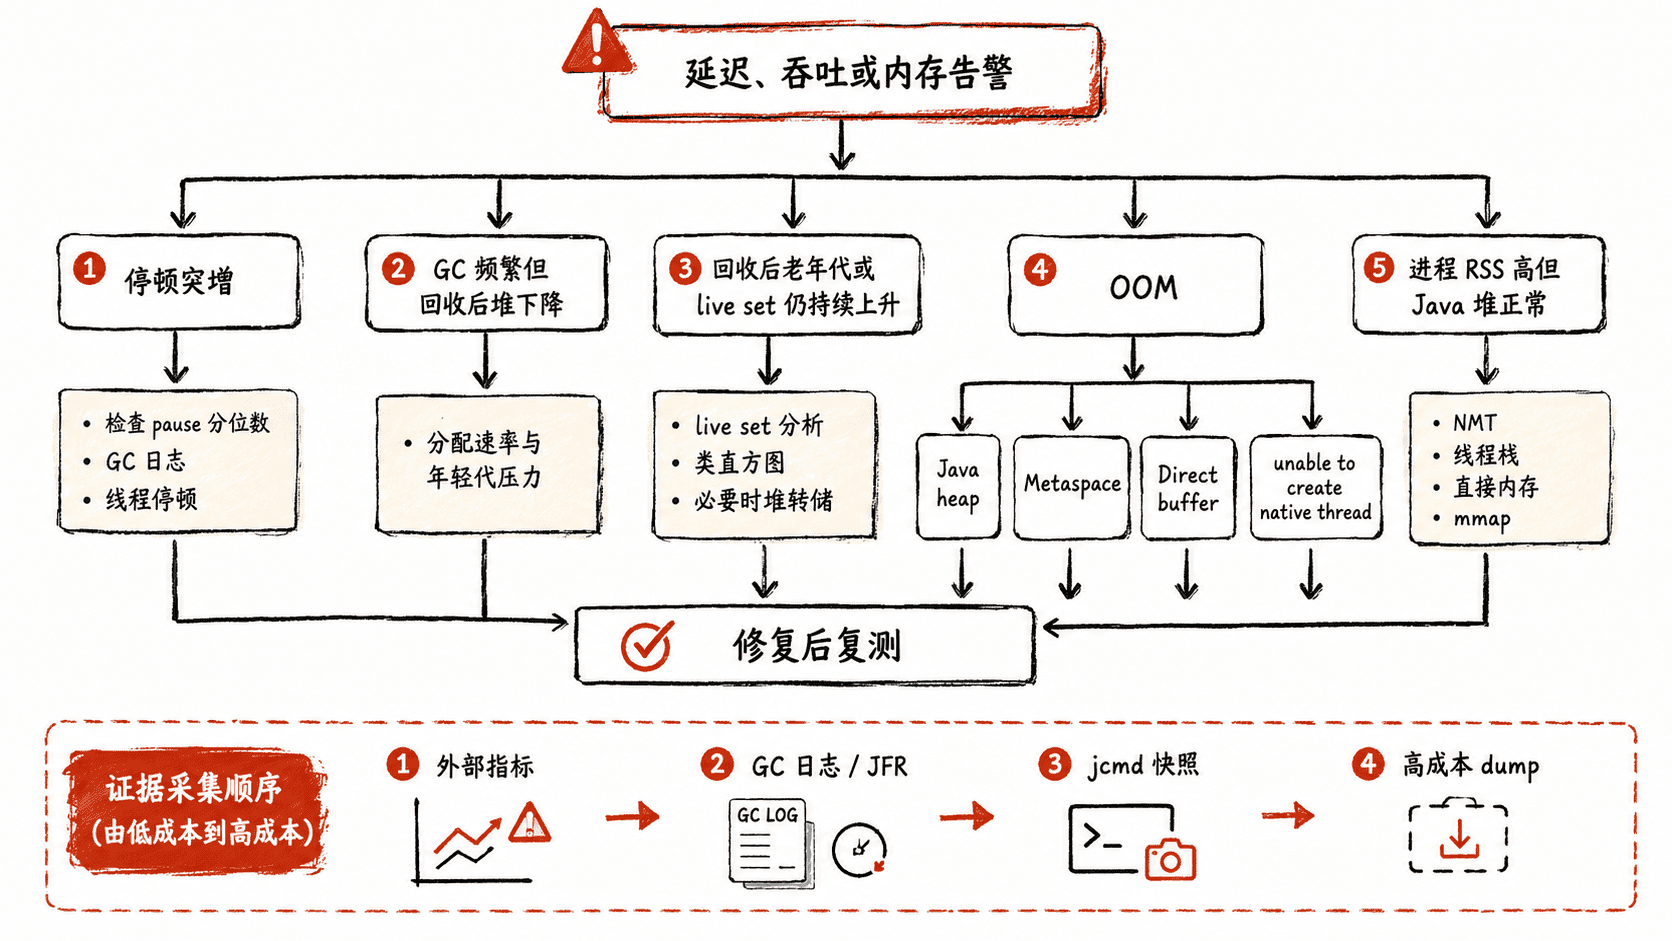
典型分流可以这样理解:停顿突增优先确认哪类 GC 事件变慢;GC 频繁但每次都能把堆降下来,通常先查分配速率和年轻代压力;回收后占用持续抬升,才重点怀疑存活集增长、缓存失控或泄漏。RSS 明显高于堆占用时,则必须转向原生内存。
固定证据采集顺序
先保存事发时间窗、请求延迟、吞吐、CPU、RSS、容器限制和 GC 指标,再进入 JVM。这样即使后续重启,也保留了“什么时候开始、影响多大、是否与流量变化同步”的基线。
接着用 jcmd 获取轻量快照。下面命令不会替代持续监控,但适合在进程仍可响应时做首轮确认:
jcmd <PID> VM.flags
jcmd <PID> GC.heap_info
jcmd <PID> Thread.print -l
预期输出会因 JDK、收集器和线程数量不同而变化,重点确认 JVM 参数、当前堆布局/占用以及是否存在大量阻塞线程:
<PID>:
-XX:... -Xmx<VALUE> ...
<PID>:
 garbage-first heap   total <VALUE>K, used <VALUE>K ...
<PID>:
Full thread dump Java HotSpot(TM) 64-Bit Server VM ...
如果已启用 GC 日志,应优先截取异常前后同一时间窗,关注 GC 类型、暂停时长、回收前后占用与并发周期是否正常完成。JDK 9 及之后可在启动参数中使用统一日志:
java -Xlog:gc*,safepoint:file=<PATH>/gc.log:time,uptime,level,tags -jar app.jar预期结果是 <PATH>/gc.log 持续写入带时间戳的 GC 与 safepoint 记录;实际事件名称和字段取决于所用收集器。
如果 GC 日志不足以解释异常,而进程仍能接受诊断开销,可以启动一段有界 JFR 录制,把 GC、分配、线程和 safepoint 放到同一时间线:
jcmd <PID> JFR.start name=gc-triage settings=profile duration=5m filename=<PATH>/gc-triage.jfr预期输出会确认录制已启动,并在约 5 分钟后写出 <PATH>/gc-triage.jfr。实际 recording ID 和提示文本可能因 JDK 版本不同;生产环境应先确认诊断目录可写且磁盘空间充足。
用症状验证根因
停顿突增时,先确认暂停是否来自 GC 本身,再看 safepoint 和线程活动。如果暂停分位数升高但 GC 时间占比并不高,问题可能是少数长暂停或非 GC safepoint,而不是“GC 太频繁”。
频繁回收时,重点比较单位时间分配量、Young GC 次数和回收后堆占用。若分配速率同步上升、每次回收后堆仍能回落,优先排查突增流量、对象创建热点、批处理放大或年轻代容量是否不匹配,而不是直接扩大整个堆。
回收后占用持续抬升时,观察多轮 GC 后的 live set 是否呈单调增长。此时可采集类直方图,先找增长最快的类型,再决定是否做更重的堆分析:
jcmd <PID> GC.class_histogram预期输出类似:
 num     #instances         #bytes  class name
----------------------------------------------
   1:        <VALUE>        <VALUE>  [B
   2:        <VALUE>        <VALUE>  java.lang.String
   3:        <VALUE>        <VALUE>  <CLASS>
类直方图只能告诉你“什么对象多”,不能直接证明谁引用了它们。需要确认保留链时,再在磁盘、I/O 和暂停风险可接受的前提下采集 heap dump。
单独处理 OOM 与 RSS 异常
看到 OutOfMemoryError 时先读完整异常类型。Java heap space、Metaspace、Direct buffer memory 和 unable to create native thread 指向的资源完全不同,不能统一按“加大 -Xmx”处理。
为了保留 Java 堆 OOM 的现场,可在启动时预先配置:
java -XX:+HeapDumpOnOutOfMemoryError -XX:HeapDumpPath=<PATH> -jar app.jar预期结果是在发生 Java 堆相关 OOM 时,于 <PATH> 生成堆转储文件;文件名和生成时机可能随 JDK 与路径配置不同,生产环境需提前确认磁盘容量和写入权限。
如果 RSS 持续上涨而 Java 堆水位稳定,优先检查线程数、Direct Buffer、类元数据、JNI、代码缓存和其他原生分配。启用了 Native Memory Tracking 时,可以执行:
jcmd <PID> VM.native_memory summary预期输出会列出 Java Heap、Class、Thread、Code、GC 等原生内存分类;若 JVM 启动时未启用 NMT,则会明确提示 Native Memory Tracking 未启用。NMT 有额外开销,应在部署阶段决定是否开启,而不是事故发生后才假设它可用。
修复后必须回到同一组指标
一次重启只能消除现场,不能证明问题解决。修复后应使用与故障时相同的流量区间和观测指标复测:停顿分位数是否回落、GC 时间占比是否恢复、回收后 live set 是否稳定、RSS 与堆占用差值是否停止扩大。
只有“症状消失、证据链与根因一致、修复后同指标复测通过”三个条件同时满足,才能关闭一次 GC 异常。这样做可以把临时救火变成可复用的生产分诊流程。