
Java / 系统课时
设计 JVM 监控与告警
设计 JVM 监控与告警
JVM 告警要回答的是“现在是否需要人介入”,而不是把所有指标都设阈值。本篇把堆水位、分配速率、GC 时间占比、停顿分位数、线程与进程内存组合成可行动规则,并给出可落地的 Prometheus 示例。
学习目标
- 能建立覆盖堆、GC、线程与进程内存的最小监控集
- 能用趋势、持续时间和多信号组合减少误报
- 能把告警直接映射到可执行的排查动作
从四类信号建立仪表盘
监控至少覆盖容量、速率、延迟和进程资源四类信号。容量看“还剩多少空间”,速率看“压力是否突然变大”,延迟看“GC 是否影响请求”,进程资源则用于发现堆外和线程问题。
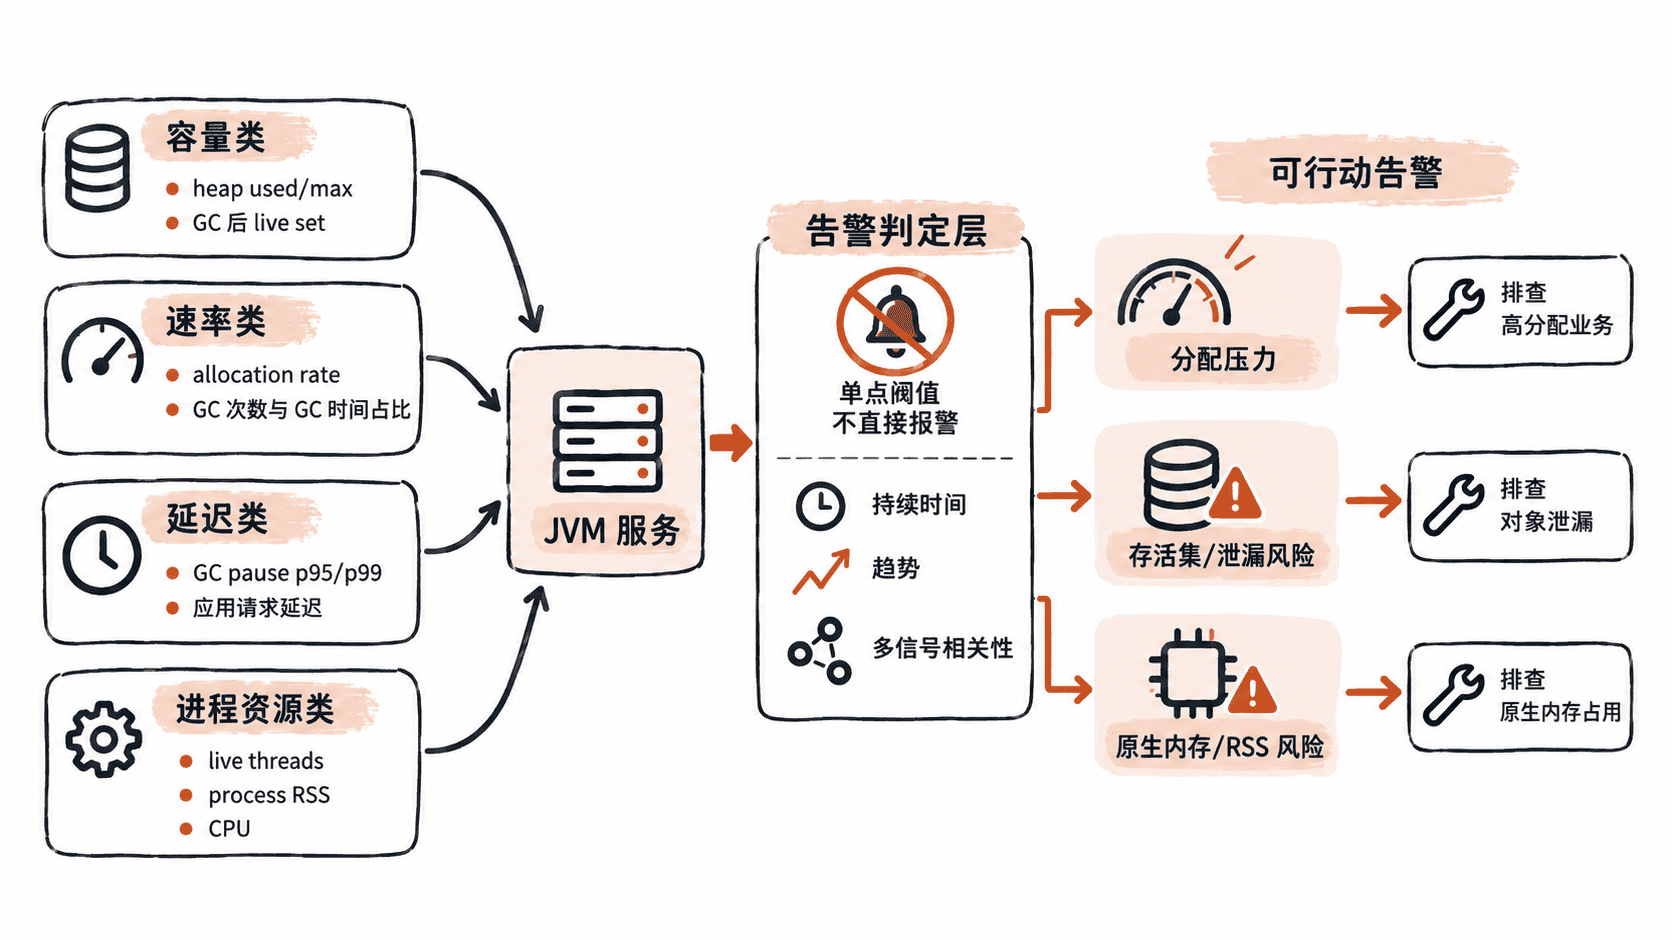
推荐把下列指标放在同一时间轴上:堆使用率与 GC 后 live set、对象分配速率、GC pause 总时间占比、pause p95/p99、应用请求延迟、活跃线程数、进程 RSS 与 CPU。单独看其中任何一项都容易误判,组合后才知道是容量问题、吞吐问题还是暂停问题。
用比率和趋势替代单点阈值
堆水位适合看 GC 后的趋势。若每次 GC 后占用逐步抬高,且业务负载没有同步增长,应提高泄漏或缓存失控的优先级。单看瞬时 used / max 容易被正常的锯齿波形触发。
分配速率用于解释“为什么 GC 突然变频繁”。它应与 Young GC 频率、CPU 和请求吞吐联动观察。若分配速率翻倍但请求量没有变化,通常比“堆使用率 80%”更值得立即调查。
GC 时间占比可以用一个滑动窗口内的 GC 累计耗时除以墙钟时间估算。例如 5 分钟窗口中 GC 累计消耗 45 秒,则 GC 时间占比约为 15%。这个指标持续升高时,说明吞吐被回收工作侵蚀。
停顿告警应优先看 p95/p99,而不是平均值。平均暂停 20 ms 并不能排除少量 2 秒长暂停;真正影响尾延迟的往往正是这些高分位事件。
组合成可行动的告警
下面以 Prometheus 为例。指标名采用 Micrometer/Prometheus 常见命名;如果你的采集链做过 relabel 或自定义命名,应在保持语义一致的前提下替换。pause 分位数依赖 jvm_gc_pause_seconds_bucket,需要先确认直方图桶已实际导出。
groups:
  - name: jvm-gc
    rules:
      - alert: JvmGcTimeRatioHigh
        expr: sum by (instance) (rate(jvm_gc_pause_seconds_sum[5m])) > 0.15
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "JVM GC time ratio has stayed above 15%"

      - alert: JvmGcPauseP99High
        expr: histogram_quantile(0.99, sum by (le, instance) (rate(jvm_gc_pause_seconds_bucket[5m]))) > 0.5
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "JVM GC pause p99 has stayed above 500 ms"

      - alert: JvmProcessRssDivergesFromHeap
        expr: sum by (instance) (process_resident_memory_bytes) - sum by (instance) (jvm_memory_used_bytes{area="heap"}) > 1073741824
        for: 15m
        labels:
          severity: warning
        annotations:
          summary: "Process RSS exceeds used Java heap by more than 1 GiB"
这是配置片段,实际阈值不能直接照搬。应先用服务自己的 SLO、堆大小、容器限制和历史基线校准;RSS 与 heap 的差值还包含线程栈、代码缓存、元空间、直接内存和 JVM 自身结构,因此它只用于触发“查原生内存”的动作。
可用 promtool 在发布前校验规则语法:
promtool check rules <PATH>/jvm-alerts.yml预期输出类似:
Checking <PATH>/jvm-alerts.yml
  SUCCESS: <VALUE> rules found
<VALUE> 取决于文件中的规则数量。语法通过只说明规则可被 Prometheus 解析,不代表表达式一定匹配到你的真实指标。
把告警绑定到排查动作
一个好的告警必须让值班人员知道下一步查什么。JvmGcTimeRatioHigh 应先看分配速率、GC 类型和 CPU;JvmGcPauseP99High 应关联同时间窗的 GC 日志、safepoint 与请求 p99;RSS 与 heap 差值持续扩大时,则优先查 NMT、线程数和 Direct Buffer,而不是先增大堆。
告警还应设置持续窗口和恢复条件。持续 10~15 分钟能过滤瞬时抖动,但对低延迟服务可能过慢;生产阈值应按业务 SLO 和流量周期回放验证。可以先以只记录不通知的方式运行一段时间,统计触发频率,再决定页面、电话或工单级别。
验证监控是否真的可用
上线前至少做一次受控验证:短时增加对象分配压力,确认 allocation rate 和 GC 时间占比同步变化;在非生产环境制造短暂停顿,确认 pause 分位数和应用延迟能在同一时间轴对应;调整进程外内存占用时,确认 RSS 与 heap 的差值能被观察。
不要把“Prometheus 有数据”当作监控完成。真正的验收标准是:指标能解释现象、规则能在正确时间触发、通知包含服务与实例上下文,并且值班人员能从告警直接进入对应的排查路径。