
Java / 系统课时
基于压测结果做容量规划
基于压测结果做容量规划
容量规划不是把压测得到的最高 RPS 直接当作单机能力。本篇从阶梯压测中找出满足延迟、CPU、GC 和内存约束的稳定区间,再折算安全单实例容量、扩容阈值和冗余实例数,得到可用于上线与扩容决策的结果。
学习目标
- 能从负载阶梯中识别稳定区间和性能拐点,而不是只看峰值吞吐。
- 能把业务 SLO、CPU、GC 与内存约束合并成单实例安全容量。
- 能根据峰值预测、利用率目标和冗余要求估算实例数与扩容阈值。
从阶梯压测找稳定容量
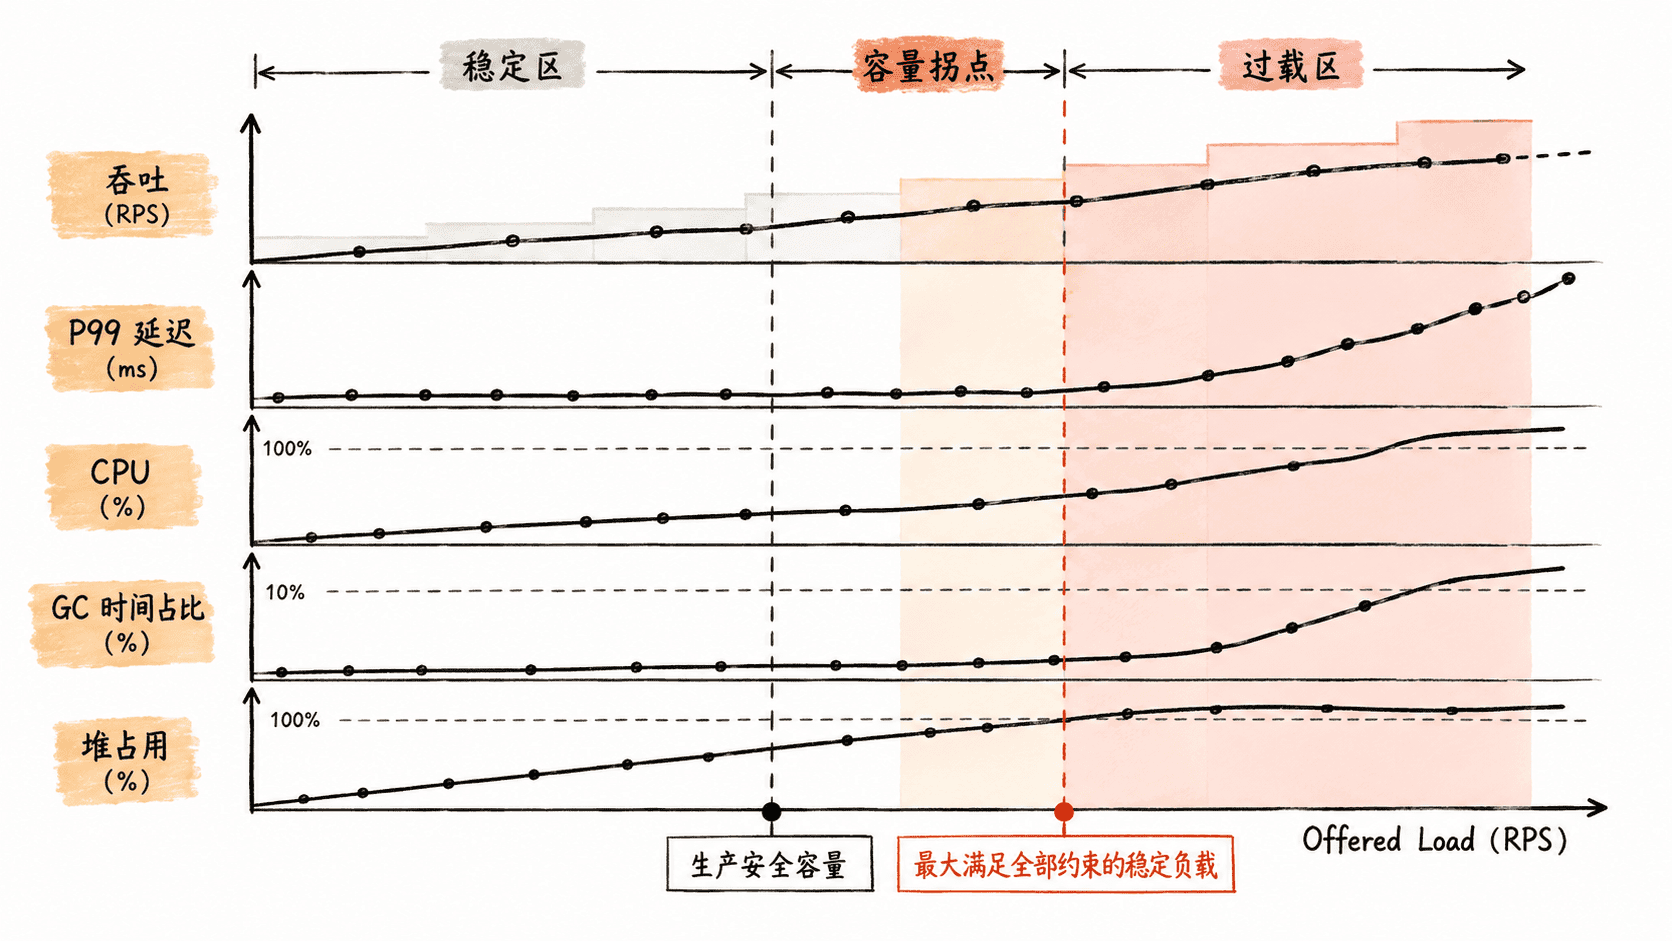
压测应按固定步长逐级提高输入负载,并在每个台阶进入稳态后采样。每一级至少同时记录 offered load、实际吞吐、P99、错误率、CPU、GC 时间占比、堆使用和进程 RSS。真正的容量边界通常出现在“吞吐增长开始跟不上输入、P99 加速上升、CPU 或 GC 接近预算”的区域。
单实例稳定容量应取满足全部约束的最高负载,而不是工具还能继续发压的最高负载。例如 5000 RPS 时服务仍能处理请求,但 P99、CPU 与 GC 已同时越界,那么 5000 RPS 就不能作为生产容量。
把多项约束合成一个安全值
先定义稳定容量 :它是同时满足业务 SLO 和资源预算的最高输入负载。然后再乘以目标运行利用率 ,给流量波动、JIT/GC 抖动、请求复杂度变化和实例间不均衡留余量:
例如稳定容量为 4000 RPS,若希望常态只使用其中 75%,则安全单实例容量为 3000 RPS。这里的 75% 不是通用常数,应根据历史波动、扩容速度和故障恢复时间确定;扩容慢、流量尖峰陡的系统通常需要更大的余量。
下面的脚本把一组阶梯压测结果转成稳定容量、安全容量和实例数。通过条件为 P99 不超过 120 ms、CPU 不超过 75%、GC 时间占比不超过 5%。
import math

steps = [
    {"offered": 2000, "throughput": 1990, "p99_ms": 70, "cpu_pct": 45, "gc_pct": 2.0},
    {"offered": 3000, "throughput": 2990, "p99_ms": 80, "cpu_pct": 55, "gc_pct": 2.5},
    {"offered": 4000, "throughput": 3980, "p99_ms": 95, "cpu_pct": 66, "gc_pct": 3.5},
    {"offered": 5000, "throughput": 4930, "p99_ms": 125, "cpu_pct": 78, "gc_pct": 6.2},
    {"offered": 6000, "throughput": 5600, "p99_ms": 240, "cpu_pct": 94, "gc_pct": 11.5},
]

qualified = [
    step for step in steps
    if step["p99_ms"] <= 120
    and step["cpu_pct"] <= 75
    and step["gc_pct"] <= 5
]

stable_rps = max(qualified, key=lambda x: x["offered"])["offered"]
safe_rps = int(stable_rps * 0.75)

peak_rps = 13500
redundancy_factor = 1.20
instances_by_factor = math.ceil(peak_rps * redundancy_factor / safe_rps)
instances_n_plus_1 = math.ceil(peak_rps / safe_rps) + 1

print(f"stable_rps={stable_rps}")
print(f"safe_rps={safe_rps}")
print(f"instances_by_factor={instances_by_factor}")
print(f"instances_n_plus_1={instances_n_plus_1}")
预期输出:
stable_rps=4000
safe_rps=3000
instances_by_factor=6
instances_n_plus_1=6
在这组数据中,4000 RPS 是最后一个同时满足三项门槛的台阶;5000 RPS 虽然实际吞吐接近输入,但延迟、CPU 和 GC 已经越界,因此不能算稳定容量。
计算实例数和扩容阈值
若预计峰值为 ,并用冗余系数 覆盖实例故障、预测误差或突发流量,可以按下式估算实例数:
冗余系数法和 N+1 是两种不同策略,不应机械叠加,否则可能重复计算同一份故障余量。若系统明确要求任意时刻损失一个实例仍能承载峰值,可以直接校验剩余 个实例的总安全容量是否仍大于等于峰值。
扩容阈值也不应只绑定 CPU。更稳妥的做法是把“流量接近安全容量”作为主信号,再辅以 P99、GC 时间占比、CPU 或队列长度。以安全容量 3000 RPS 为例,如果希望在达到安全容量前留出自动扩容时间,可以在单实例等效负载达到约 80%~85% 时触发扩容,并根据实例启动到可接流量所需时间反推阈值是否足够提前。
用内存与故障场景做最后校验
吞吐满足要求并不代表容量规划完成。还要检查峰值台阶下的堆占用、GC 后 Old 区基线、Metaspace、Direct Memory、线程栈和进程 RSS,确保容器或主机内存仍有余量。如果随着台阶上升,GC 后存活对象持续累积,即使当前 P99 合格,也可能只是压测时间太短,不能据此放大单机容量。
上线前再做一次故障容量校验:模拟减少一个实例、出现流量偏斜或短时突增,确认剩余实例仍位于安全区。最终容量数字应同时回答三个问题:单实例长期安全承载多少、什么时候必须扩容、损失部分实例后还能否守住 SLO。