
Java / 系统课时
读懂标记、复制与整理
读懂标记、复制与整理
GC 的“回收”并不是一个单一动作。不同收集器会组合标记、清除、复制和整理,以换取不同的暂停时间、复制量和空间连续性。本课从对象是否移动、需要扫描多少内存、是否产生碎片三个维度,建立判断这些算法成本的直觉。
学习目标
- 区分标记清除、复制与压缩整理的核心动作
- 解释碎片、存活对象比例与对象搬运成本的关系
- 根据对象存活特征理解收集器为什么组合不同算法
三种机制解决的不是同一个成本
“标记”负责识别哪些对象仍然存活,后续如何回收才决定空间会变成什么样。标记清除保留存活对象原位置并回收空洞;复制把存活对象搬到目标区域;压缩整理则让存活对象向一侧或连续区域聚拢,并更新被移动对象的引用。
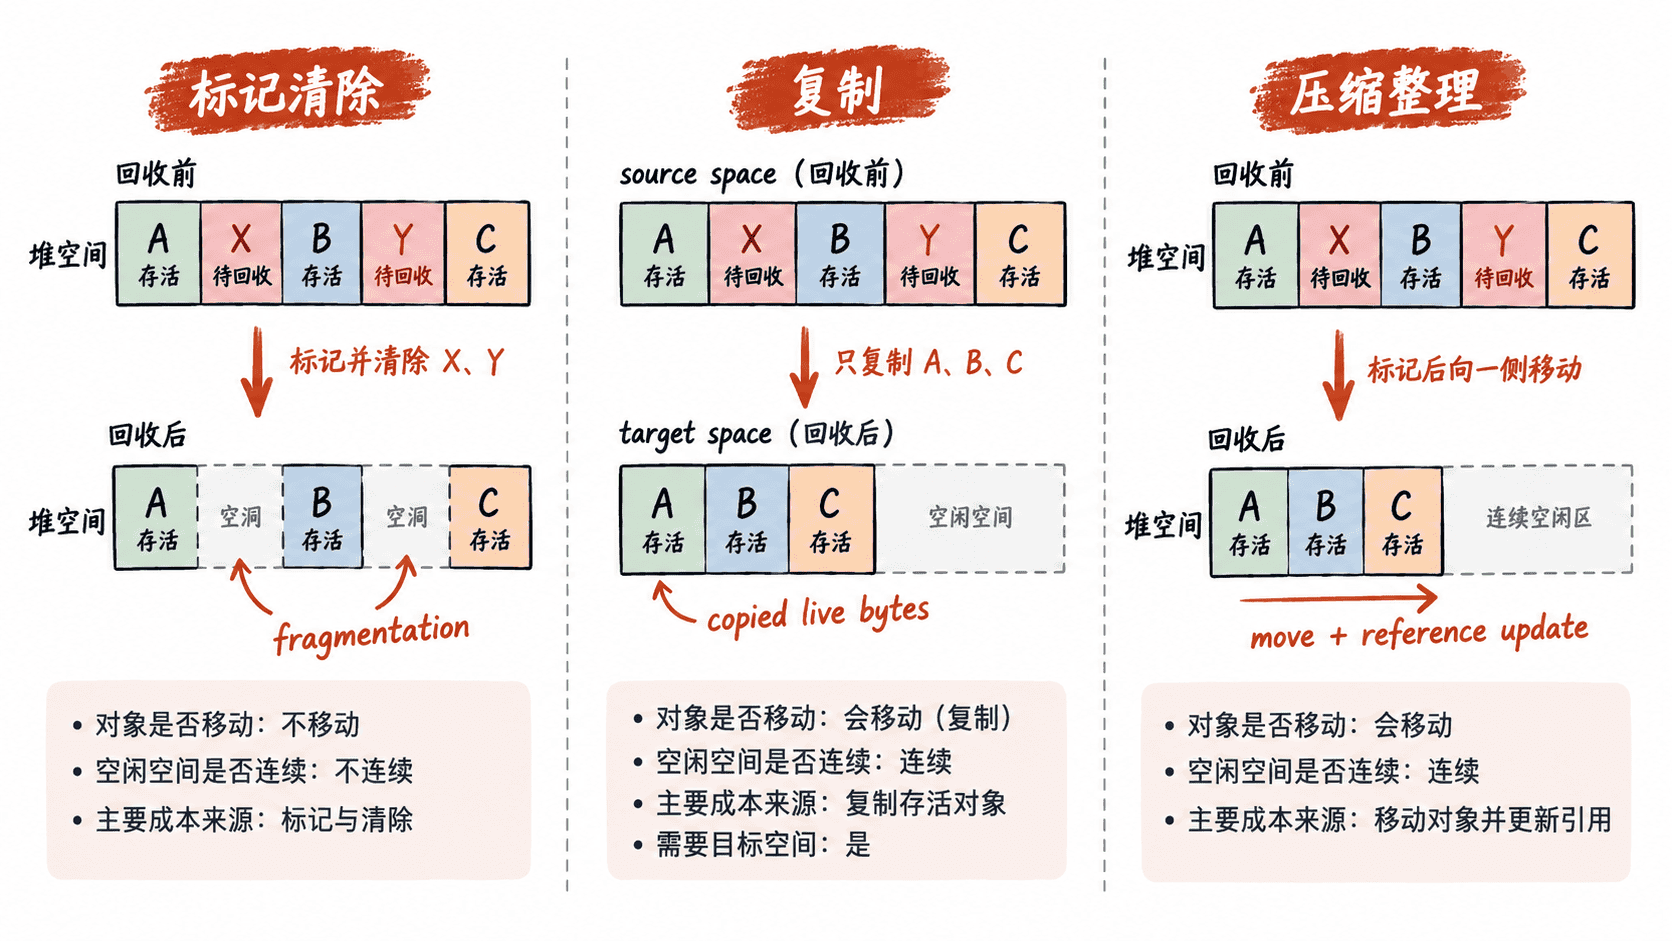
标记清除省搬运,但会留下碎片
标记清除先找到存活对象,再把未标记区域加入可复用空间。它的优势是存活对象不用移动,因此不会产生大规模对象复制和引用重写;代价是回收后可能留下很多大小不一的空洞。
碎片会让后续分配变复杂:总空闲空间看起来很多,却未必有足够大的连续区域容纳新对象。实现上可以通过空闲列表管理这些洞,但分配路径和空间局部性通常不如连续分配简单。清扫本身还要处理一段内存范围,因此成本不能只看存活对象数量。
复制的成本主要跟存活量走
复制算法把存活对象从源区域搬到目标区域,源区域随后可以整体释放。只要死亡对象很多,真正需要搬运的数据就少,因此这种方式特别适合“绝大多数对象很快死亡”的年轻代或局部回收场景。
它的代价也很明确:必须准备足够的目标空间,并更新所有指向被移动对象的引用。如果一次回收时存活率突然升高,需要复制的字节数会显著增加,暂停时间和目标区域压力也可能上升。
压缩整理用搬运换连续空间
压缩整理会在识别存活对象后移动它们,使存活对象尽量连续排列,并把空闲区域聚合成大块连续空间。这样后续分配可以更接近简单的指针碰撞,长期碎片问题也会显著减轻。
但“整理”意味着要搬动存活对象并修正引用,因此当老年代存活对象很多时,工作量可能很大。判断整理成本时,关注的重点不是刚刚死了多少对象,而是还活着、需要移动和更新引用的对象有多少。
用分配压力观察存活率差异
下面的程序会持续创建短命字节数组,但每轮只保留极少数对象。它不能直接实现某种 GC 算法,却能构造“死亡多、存活少”的对象分布,用来理解为什么复制式回收在低存活率场景下更划算。
import java.util.ArrayList;
import java.util.List;

public class GcChurnDemo {
    public static void main(String[] args) {
        List<byte[]> survivors = new ArrayList<>();

        for (int round = 0; round < 40; round++) {
            for (int i = 0; i < 2000; i++) {
                byte[] block = new byte[4096];
                // 每 400 个对象只保留 1 个,其余对象很快失去强引用
                if (i % 400 == 0) {
                    survivors.add(block);
                }
            }
        }

        System.out.println("survivors=" + survivors.size());
    }
}
预期输出:
survivors=200程序共创建大量临时对象,但最终只保留 200 个数组。对采用复制或疏散机制的回收阶段来说,低存活率意味着需要搬运的数据相对较少;如果把保留比例大幅提高,搬运量也会随之上升。实际 GC 次数与暂停信息取决于堆大小、收集器和 JVM 参数,不能从这段程序固定推导。
选择机制时同时看空间和暂停目标
| 机制 | 主要工作量来源 | 空间结果 | 典型风险 |
|---|---|---|---|
| 标记清除 | 标记扫描与清扫范围 | 可能形成不连续空洞 | 碎片、分配路径变复杂 |
| 复制 | 需要搬运的存活对象与引用更新 | 目标区域通常连续 | 存活率高时复制量上升 |
| 压缩整理 | 存活对象搬运与引用更新 | 形成连续空闲区 | 活对象多时整理成本高 |
因此不要把三者理解成“谁更先进”。GC 收集器真正做的是在对象存活率、可用空间、碎片程度和暂停目标之间取舍:短命对象多时复制很有优势,碎片不可接受时需要整理,而不移动对象的阶段则能减少搬运成本。