
Java / 系统课时
设计 JVM 参数对照实验
设计 JVM 参数对照实验
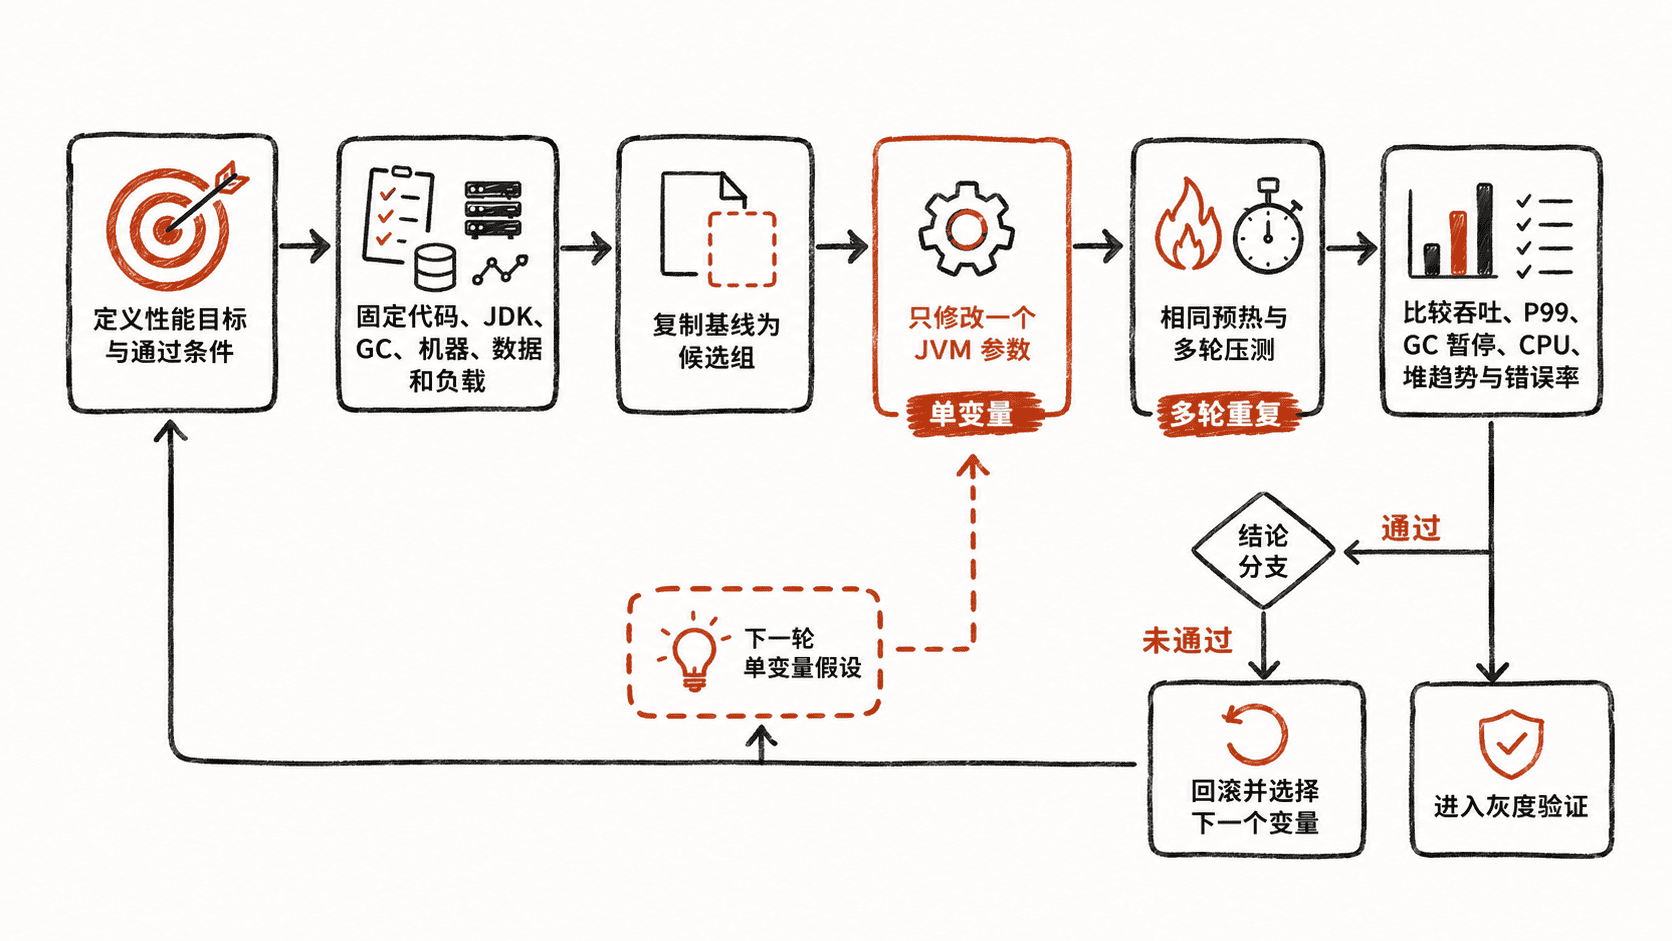
JVM 参数调优不能靠“改完一次压测看起来更快”下结论。本篇把参数变更变成可复现的对照实验:固定代码、数据、负载与环境,每次只改一个变量,重复多轮采样,再用稳定性和业务指标决定保留还是回滚。
学习目标
- 能列出 JVM 参数实验中必须固定的控制变量,并定义单变量实验。
- 能用多轮压测的中位数与波动程度比较基线组和候选组。
- 能为参数变更设置通过、失败和回滚条件,避免只看单项指标。
先固定实验边界
一次可信的 JVM 参数实验,首先要保证两组测试除了目标参数外尽量一致。至少固定应用构建版本、JDK 版本、垃圾收集器、容器 CPU/内存限制、测试数据、流量模型、预热时间、正式采样时长和监控口径。若这些条件同时变化,最终差异就无法归因给 JVM 参数。
例如要验证“增大最大堆是否能降低 GC 压力”,可以让基线保持 -Xms4g -Xmx4g,候选组只把 -Xmx 改为 6g,而不是顺手再修改收集器、线程数和暂停目标。若测试的是 G1 的暂停目标,也应只改变对应参数,并明确它是调优目标而不是暂停时间的硬上限。
用多轮数据比较而不是挑最好的一次
每个方案至少重复多轮,并保留每轮完整指标。吞吐和延迟通常先比较中位数,波动可用变异系数观察;GC 还要同时看暂停总量、长暂停、分配速率以及压测结束时的堆趋势。只比较平均延迟,很容易掩盖尾延迟恶化。
下面的脚本用五轮结果演示同一负载下的基线与候选组比较。示例数据已经内置,因此可以直接运行;真实实验时把数组替换为每轮采集值即可。
from statistics import mean, median, pstdev

runs = {
    "baseline": [
        {"throughput_rps": 4980, "p99_ms": 118, "gc_pause_ms": 610},
        {"throughput_rps": 5030, "p99_ms": 121, "gc_pause_ms": 640},
        {"throughput_rps": 5000, "p99_ms": 117, "gc_pause_ms": 600},
        {"throughput_rps": 5010, "p99_ms": 119, "gc_pause_ms": 620},
        {"throughput_rps": 4970, "p99_ms": 120, "gc_pause_ms": 630},
    ],
    "candidate": [
        {"throughput_rps": 5050, "p99_ms": 104, "gc_pause_ms": 480},
        {"throughput_rps": 5070, "p99_ms": 106, "gc_pause_ms": 500},
        {"throughput_rps": 5030, "p99_ms": 105, "gc_pause_ms": 490},
        {"throughput_rps": 5060, "p99_ms": 103, "gc_pause_ms": 470},
        {"throughput_rps": 5040, "p99_ms": 107, "gc_pause_ms": 510},
    ],
}

for variant, rows in runs.items():
    print(variant)
    for metric in ("throughput_rps", "p99_ms", "gc_pause_ms"):
        values = [row[metric] for row in rows]
        cv = pstdev(values) / mean(values) * 100
        print(f"  {metric}: median={median(values):.1f}, cv={cv:.1f}%")
预期输出:
baseline
  throughput_rps: median=5000.0, cv=0.4%
  p99_ms: median=119.0, cv=1.2%
  gc_pause_ms: median=620.0, cv=2.3%
candidate
  throughput_rps: median=5050.0, cv=0.3%
  p99_ms: median=105.0, cv=1.3%
  gc_pause_ms: median=490.0, cv=2.9%
这组数据说明候选方案的 P99 与 GC 暂停总量下降,同时吞吐略升,且各项波动仍较小。但这还不是“可以上线”的充分条件:还应确认错误率没有增加、CPU 没有明显抬升、堆占用没有形成持续上涨趋势,并检查更大的堆是否带来容器内存风险。
预先写好通过条件
实验开始前就定义判定标准,避免看完结果后再挑有利指标。一个常见做法是把条件分成业务 SLO、资源边界和 GC 健康度三类,例如:P99 不高于基线且满足业务 SLO,吞吐不下降超过允许范围,CPU 和 RSS 不突破运行预算,长暂停次数不增加,Old 区在稳态负载下不存在持续抬升。
通过条件应使用“同时满足”,而不是某一项改善就判胜。如果候选组把 P99 从 120 ms 降到 100 ms,却让 RSS 接近容器上限,生产环境可能更容易被 OOM Killer 终止;如果吞吐提升但错误率上升,也不能视为性能优化。
把实验结果转成可回滚变更
最终记录至少要包含基线参数、候选参数、环境指纹、负载模型、每轮原始结果、聚合统计与结论。候选参数通过压测后,仍应先小范围灰度,并继续观察同一组核心指标;一旦触发预先定义的回滚阈值,就恢复基线参数,而不是在线继续叠加新的调优项。
参数实验真正要优化的是因果判断质量。固定条件、单变量、多轮重复和预设门槛能让一次“参数尝试”变成可以复现、比较和回滚的工程实验。