
Java / 系统课时
分析容器 OOMKill 与 JVM 预算
分析容器 OOMKill 与 JVM 预算
容器里的 Java 进程可能没有抛出 OutOfMemoryError,却被平台直接标记为 OOMKilled。这类故障的关键不是只看 -Xmx,而是把 cgroup 上限与 Heap、Metaspace、线程栈、代码缓存、Direct Buffer 和其他本地内存放到同一张预算表里核对。
学习目标
- 区分 Java 堆 OOM 与 cgroup OOMKill,并确认内核是否因内存上限杀进程
- 用 cgroup 指标、JVM 堆信息和 Native Memory Tracking 估算主要内存去向
- 建立包含安全余量的容器内存预算,并据此调整 JVM 参数或容器限制
先确认是不是 cgroup OOMKill
Java 抛出 OOM 时,通常还能在应用日志里看到异常与堆栈;cgroup OOMKill 则是内核在容器达到内存约束后终止进程,JVM 可能来不及打印任何 Java 异常。排查时先确认容器状态,再看 cgroup 的内存事件,不要从 GC 日志直接猜原因。
在 Kubernetes 中可以先查看容器上一次退出原因;随后进入同一容器或节点侧对应 cgroup,读取 cgroup v2 的上限、当前用量和事件计数。
kubectl get pod <POD> -n <NAMESPACE> -o jsonpath='{.status.containerStatuses[0].lastState.terminated.reason}{"\n"}'
cat /sys/fs/cgroup/memory.max
cat /sys/fs/cgroup/memory.current
cat /sys/fs/cgroup/memory.events
预期输出
OOMKilled
<BYTES_OR_MAX>
<BYTES>
low <COUNT>
high <COUNT>
max <COUNT>
oom <COUNT>
oom_kill <COUNT>
如果 reason 是 OOMKilled,且 memory.events 中 oom_kill 增长,就可以把调查重点放到容器总内存,而不是只寻找 Java 堆 OOM。使用 cgroup v1 的系统路径不同,应读取该环境对应的 memory limit、usage 和 OOM 计数文件。
把容器上限拆成完整预算
容器限制约束的是 cgroup 统计到的总内存,而 -Xmx 只限制 Java 堆最大值。即使堆仍有空间,Metaspace、线程栈、Code Cache、Direct Buffer、GC 内部结构、JNI/本地库以及 libc 或 mmap 等分配继续增长,也可能让 cgroup 先触顶。
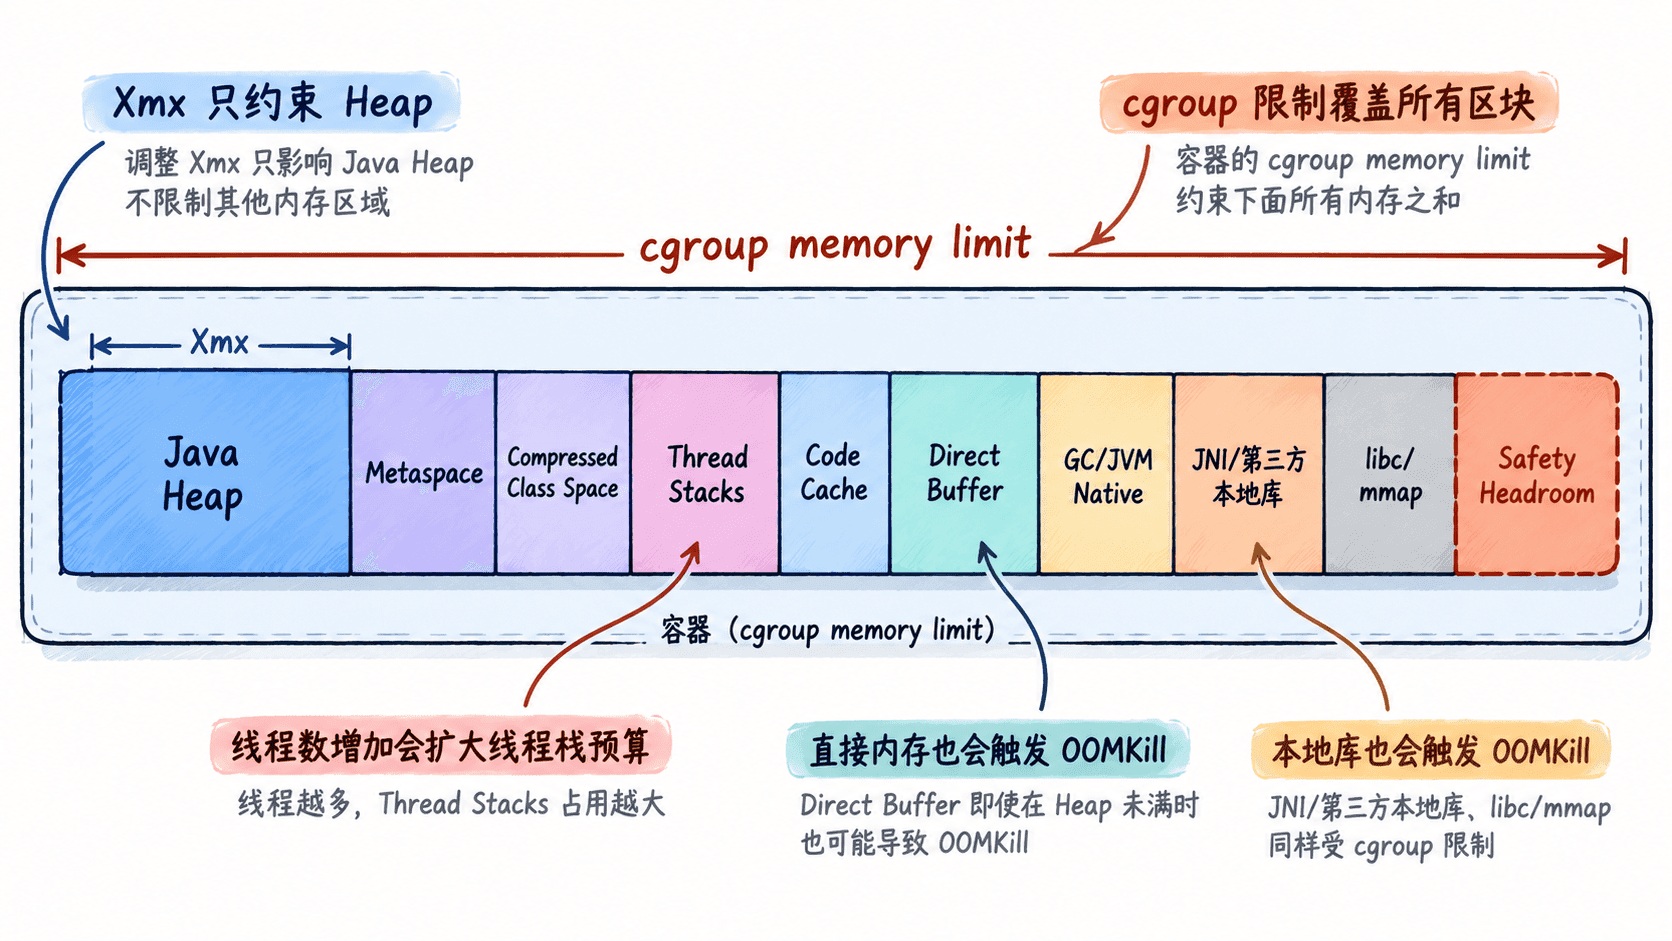
预算可以先写成一个保守关系:
其中线程栈预算常用“线程数 × -Xss”做上界估算,但这更接近保留空间的保守值,不等于实际常驻内存。容器容量规划最终仍应以进程 RSS、cgroup 用量和压测峰值为准。
用 JVM 与 NMT 找主要内存去向
先确认运行中的 JVM 实际使用了什么堆参数,再检查堆当前状态。若启动时已启用 Native Memory Tracking,可进一步查看 JVM 能追踪到的本地内存类别。
jcmd <PID> VM.flags
jcmd <PID> GC.heap_info
jcmd <PID> VM.native_memory summary scale=MB
预期输出
<PID>:
-XX:InitialHeapSize=<BYTES> -XX:MaxHeapSize=<BYTES> ...
<PID>:
<GC_NAME> heap total <VALUE>K, used <VALUE>K ...
<PID>:
Native Memory Tracking:
Total: reserved=<VALUE>MB, committed=<VALUE>MB
- Java Heap (reserved=<VALUE>MB, committed=<VALUE>MB)
- Class (reserved=<VALUE>MB, committed=<VALUE>MB)
- Thread (reserved=<VALUE>MB, committed=<VALUE>MB)
- Code (reserved=<VALUE>MB, committed=<VALUE>MB)
...
NMT 必须在 JVM 启动时通过 -XX:NativeMemoryTracking=summary 或 detail 开启,未开启时无法事后补采完整历史。NMT 也不是进程 RSS 的等价物:第三方本地库、部分 libc 行为和文件映射等未必能被完整归类,因此要把 NMT 与 cgroup、/proc/<PID>/status 或平台监控交叉验证。
识别常见的预算失衡
最常见的问题不是“Heap 太大”这一种,而是几个预算同时把余量吃光。固定 -Xmx 接近容器上限时,任何线程增长或堆外波动都可能把进程推过限制;线程数失控时,即使每个栈实际只提交一部分页面,也会显著增加风险;网络框架、大文件处理或 JNI 场景还要特别观察 Direct Buffer 和第三方本地内存。
| 现象 | 更可能的方向 | 优先检查 |
|---|---|---|
| Heap 使用稳定,cgroup 用量持续升高 | 非堆或本地内存增长 | NMT、Direct Buffer、本地库、RSS |
| 线程数与内存同时上升 | 线程栈与线程相关本地结构 | 线程池上限、线程数量、-Xss |
| Full GC 后 Heap 明显下降但容器仍接近上限 | Heap 不是主要压力源 | Metaspace、Code Cache、Direct、本地分配 |
| 启动后很快 OOMKill | 固定预算已超过容器可承受范围 | -Xmx、-Xms、容器 limit、启动期峰值 |
修复后用同一压力场景验收
修复通常只有三类:降低 Heap 或其他 JVM 预算、限制线程或堆外增长、提高容器 limit。改完后要用与故障相同的负载窗口复测,确认三个条件同时成立:memory.current 峰值低于 memory.max 且保留明确余量;oom_kill 不再增长;应用延迟和 GC 指标没有因为过度压缩 Heap 而恶化。
如果缩小 -Xmx 后 OOMKill 消失,但 GC 频率和停顿显著升高,这只是把“容器内存不足”换成了“堆压力过大”。正确的 JVM 预算必须同时满足容器不会被杀、GC 可接受、业务负载有峰值余量这三个约束。