
Java / 系统课时
区分堆泄漏与容量不足
区分堆泄漏与容量不足
同样是“堆快满了”,背后可能是对象持续泄漏、堆容量确实偏小,也可能只是短时间分配峰值。本课用业务负载、GC 前后占用和回收后水位三个信号建立判断顺序,避免一看到高内存就直接认定泄漏。
学习目标
- 根据回收后堆水位的走势区分泄漏、容量不足和突发分配峰值。
- 使用 HotSpot 自带工具采样堆与 GC 指标,并把采样结果和业务负载对齐。
- 根据判断结果选择 Heap Dump、容量评估或分配热点分析,而不是盲目调大堆。
先采集能区分问题的信号
排查时不要只看某一刻的“堆使用率”。真正有区分度的是三个量:同一时间窗口内的业务负载、GC 是否持续发生,以及一次有效回收之后仍然存活的对象占用,也就是回收后水位。如果负载不变而回收后水位持续抬升,才更像泄漏。
对于常见 HotSpot 服务,可以先用 jstat 连续采样。下面示例每秒采一次,共采 60 次;<PID> 替换为目标 Java 进程号。
jstat -gcutil <PID> 1000 60预期输出
 S0     S1     E      O      M     CCS    YGC   YGCT   FGC  FGCT   CGC  CGCT    GCT
<VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE> <VALUE>
...
实际列和值会随 JDK 与垃圾收集器不同而变化。对 G1、Parallel、Serial 等常见 HotSpot 配置,重点不是记某个瞬时数字,而是观察老年代或长期存活区域在多次回收后的趋势,同时记录同一分钟的 QPS、在线会话数、批任务量等业务指标。
用回收后水位识别三种典型形态
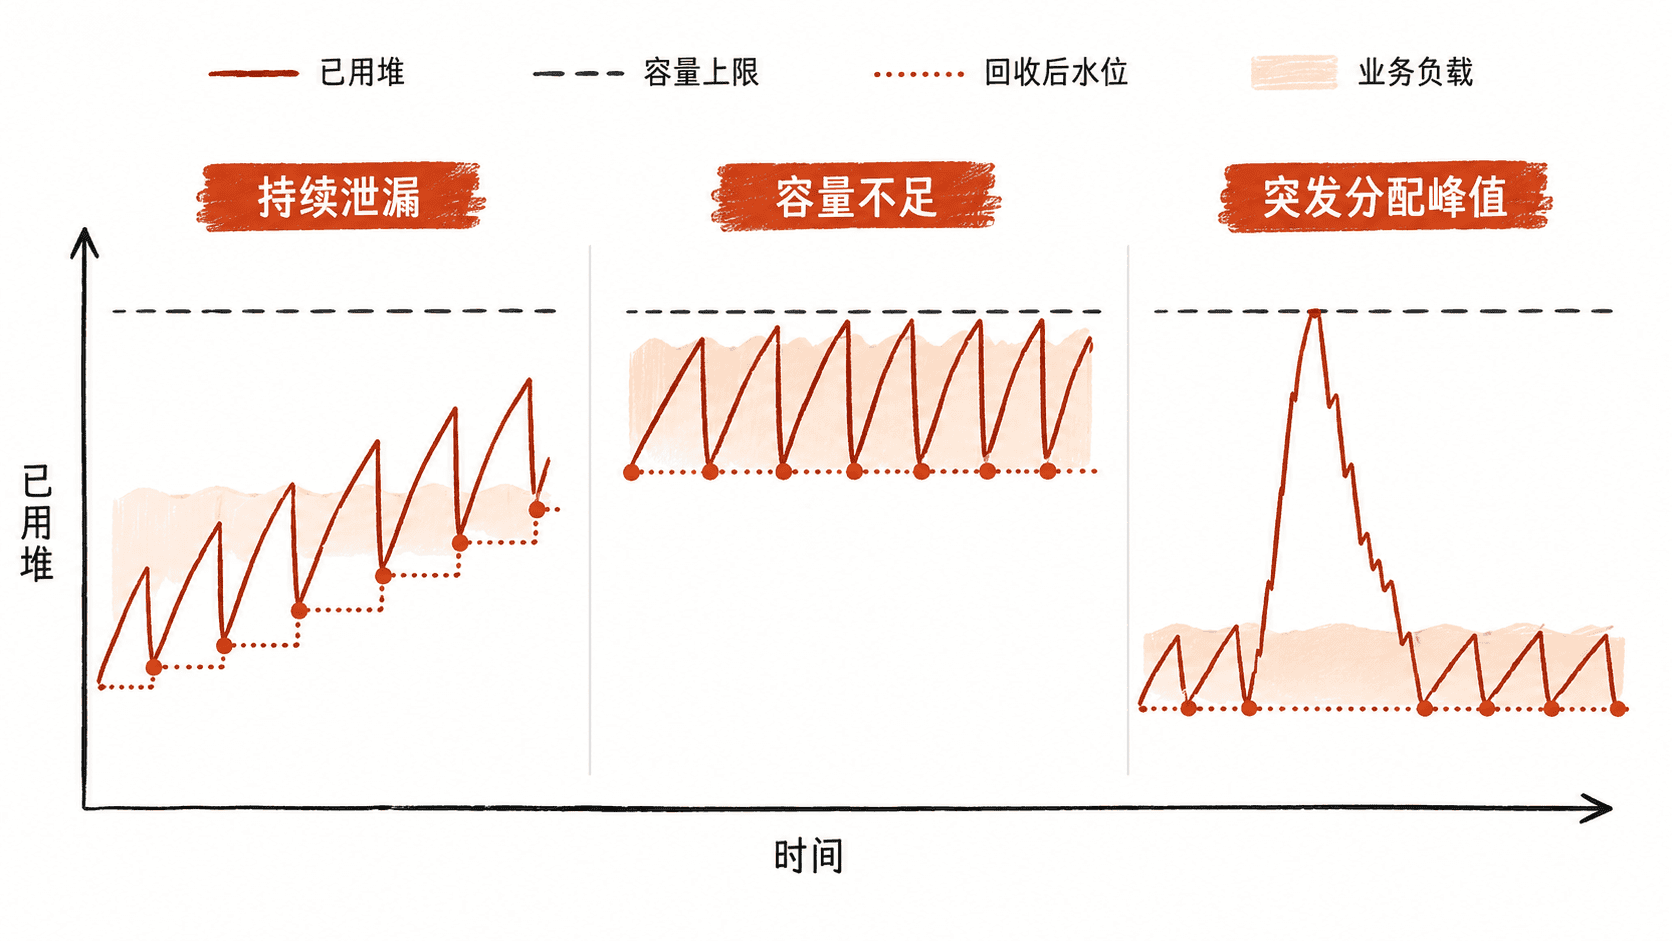
持续泄漏的关键特征是“活对象集合在增长”。在业务负载近似稳定时,多轮 GC 之后的最低水位仍持续上升,老对象越来越难被回收,GC 间隔往往也会缩短。此时增加 -Xmx 通常只会延后故障时间,下一步应采集 Heap Dump 并比较异常对象的 Retained Size 与 GC Root 路径。
正常容量不足更像“需要活着的对象本来就多”。高峰期回收后水位较高,但在相同负载下大致稳定;业务量下降后,水位也会回落。把占用除以在线用户数、队列长度或并发任务数后,如果单位负载的内存需求基本稳定,就更支持容量不足而非泄漏。
突发分配峰值表现为短时间内 Eden 或整个堆迅速上涨,随后又回到原来的回收后基线。常见来源包括批量反序列化、大结果集、一次性缓存预热或突发请求。它可能触发长 GC 甚至 OOM,但对象没有持续被引用,因此不能仅凭峰值判断泄漏。
避免被高占用和 Full GC 误导
“堆长期 80%”本身不能证明泄漏。缓存、连接会话、编译后的业务模型等都可能形成稳定且合理的存活集;相反,泄漏在堆足够大时也可能只占 30%,但回收后水位每天都在缓慢上升。
Full GC 次数同样只是压力信号。容量太小、晋升速度过快、显式 System.gc()、元空间压力等都可能引起 Full GC。判断时必须把 GC 后水位、负载和时间趋势放在一起,而不是用单个指标直接下结论。
还要确认故障真的是 Java 堆。如果进程 RSS 持续增长,但堆回收后水位稳定,或者报错是 direct buffer、metaspace、native thread 等非堆问题,就应转向直接内存、元空间、线程栈或 Native Memory Tracking,而不是继续分析 Java Heap。
按结论选择下一步
如果回收后水位在稳定负载下持续抬升,采集两个时间点的 Heap Dump,比对实例数和 Retained Size 的增长;如果水位稳定但高峰期接近上限,先量化“单位业务负载需要多少活对象”,再决定扩容、限流还是缩减缓存;如果只是短峰值,优先定位分配速率和大对象来源。
排查的核心不是回答“现在用了多少内存”,而是回答“GC 已经尽力回收之后,还留下多少对象,以及这个数字是否在相同负载下持续增长”。这个问题一旦回答清楚,泄漏、容量不足和突发峰值通常就能分开。