
Java / 系统课时
建立延迟与吞吐基线
建立延迟与吞吐基线
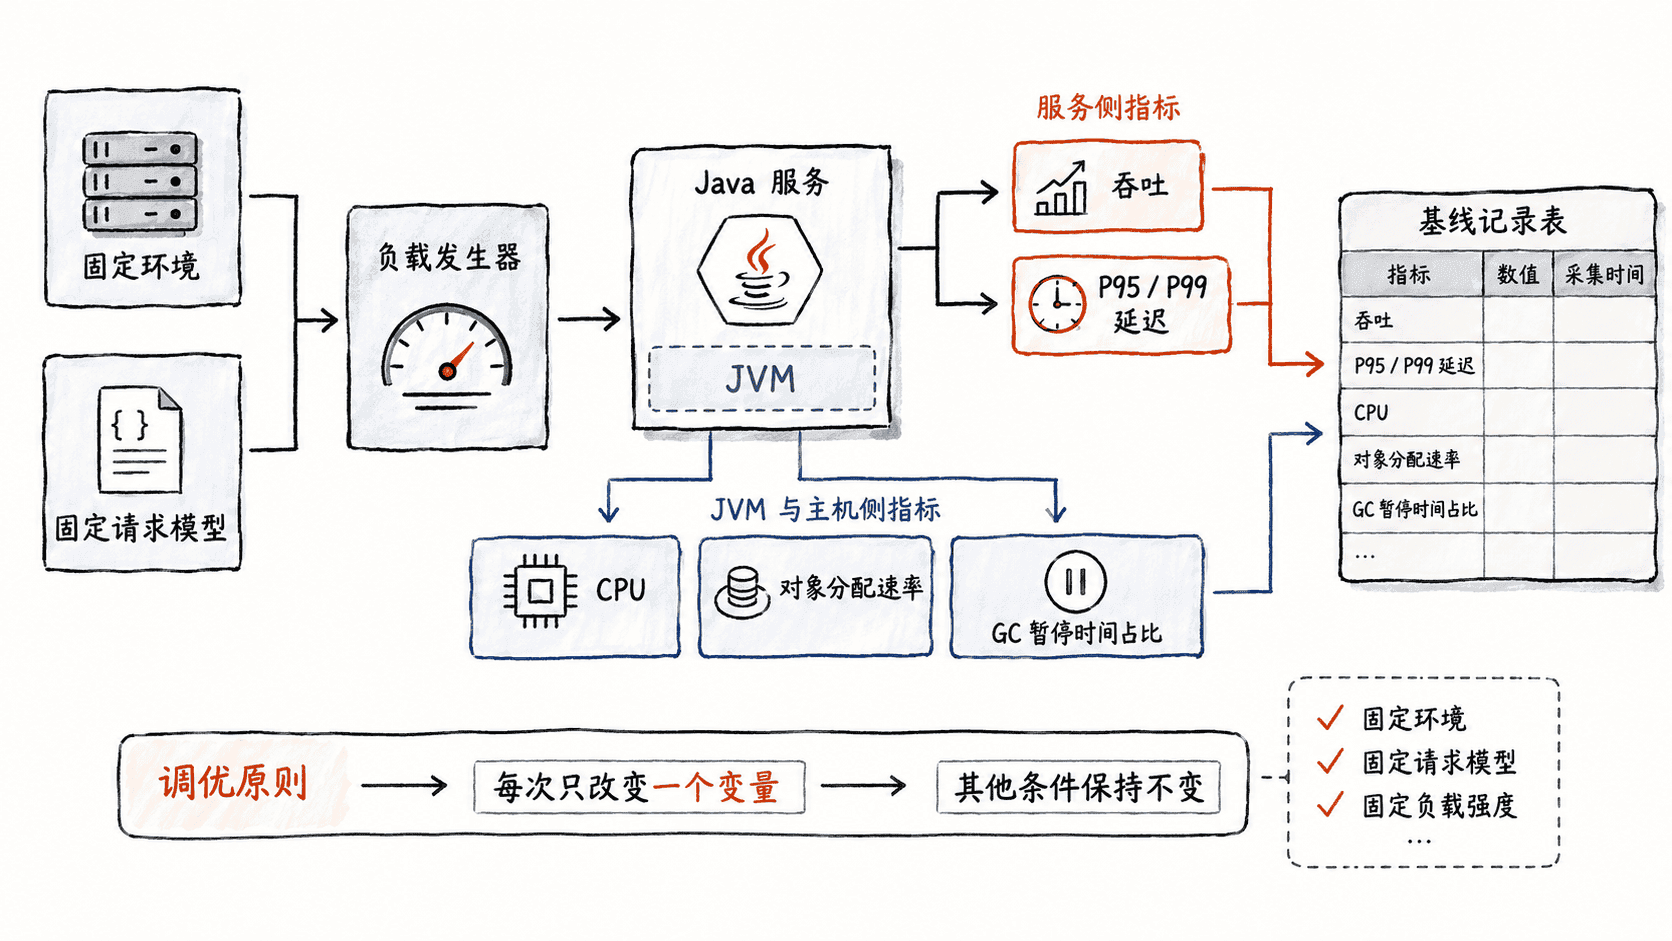
性能调优前先建立可重复的对照组。本课把请求速率、并发、数据集和运行时长固定下来,再同时记录吞吐、P95/P99、CPU、分配速率与 GC 时间占比,得到后续每次调参都能比较的基线。
学习目标
- 固定压测请求模型与运行条件,避免把环境波动误判为优化收益。
- 同时记录吞吐、尾延迟、CPU、对象分配和 GC 指标。
- 用多轮结果判断基线是否稳定,并形成可复测的记录。
先固定会影响结果的条件
一条基线不是“跑一次压测得到几个数字”,而是一组带前提的测量结果。至少固定 JVM 版本与参数、机器规格、容器 CPU/内存限制、应用版本、数据规模、缓存状态、请求比例、目标请求速率、测试时长和预热方式。后续只改变一个待验证变量,其余条件尽量保持不变。
对 HTTP 服务,推荐把“固定到达率”作为主请求模型:例如持续 500 req/s,而不是只固定并发数。这样即使服务变慢,压力发生器也不会因为每个请求等待更久而自动降低发压速度,更容易暴露排队和尾延迟问题。
用固定到达率生成请求
下面用 k6 的 constant-arrival-rate 固定 500 req/s,持续 2 分钟。示例假定服务存在 GET /api/orders/42,并通过环境变量传入地址;开始正式采样前,应先完成独立预热。
import http from 'k6/http';
import { check } from 'k6';

export const options = {
  scenarios: {
    baseline: {
      executor: 'constant-arrival-rate',
      rate: 500,
      timeUnit: '1s',
      duration: '2m',
      preAllocatedVUs: 64,
      maxVUs: 256,
    },
  },
};

export default function () {
  const baseUrl = __ENV.BASE_URL || 'http://127.0.0.1:8080';
  const res = http.get(`${baseUrl}/api/orders/42`);
  check(res, { 'status is 200': (r) => r.status === 200 });
}
运行时把端口替换成实际值:
BASE_URL=http://127.0.0.1:<PORT> k6 run baseline.js预期输出关注请求速率和尾延迟,实际数值会因机器与服务实现不同而变化:
http_req_duration ... p(95)=<VALUE>ms p(99)=<VALUE>ms
http_reqs .......... <VALUE> <VALUE>/s
checks ............. <VALUE>% <VALUE> out of <VALUE>
如果 dropped_iterations 明显大于 0,说明压测机或配置没有能力维持目标到达率;这时这轮结果不能直接作为服务性能基线,应先提高 preAllocatedVUs、检查压测机资源或降低目标速率。
同步记录 JVM 与 CPU 指标
压测窗口必须和 JVM 指标窗口对齐。吞吐和 P95/P99 由负载工具给出;CPU 记录进程或容器 CPU 使用率;对象分配速率记录每秒新分配字节数;GC 时间占比则明确口径后再比较。
如果应用已暴露 Micrometer Prometheus 指标,可用下面的查询作为片段示例。它依赖应用实际存在这些指标名,不能脱离监控系统单独运行:
rate(jvm_gc_memory_allocated_bytes_total{instance="<VALUE>"}[2m])

100 * sum(rate(jvm_gc_pause_seconds_sum{instance="<VALUE>"}[2m]))

100 * process_cpu_usage{instance="<VALUE>"}
其中 <VALUE> 替换为目标实例标签。第一行是近 2 分钟对象分配速率,单位为 byte/s;第二行汇总该实例不同 GC 标签后的暂停时间占比;第三行是进程 CPU 使用率。这里的 jvm_gc_pause_seconds_sum 只衡量暂停时间,不等于并发 GC 线程消耗的全部 CPU,因此记录表里应把指标名称写成“GC pause time %”,不要泛化成“GC 总成本”。
把结果写成可比较的基线
一次正式测试至少跑 3 轮,每轮使用相同预热、时长和请求模型。不要只保存平均值,尾延迟和资源消耗往往比平均响应时间更能解释 GC 调优是否有效。
| 指标 | 建议记录值 | 主要用途 |
|---|---|---|
| 吞吐 | req/s | 判断单位时间处理能力 |
| P95 / P99 | ms | 观察尾部请求是否被停顿或排队放大 |
| CPU | % | 区分“更快”是否只是消耗更多计算资源 |
| 分配速率 | MB/s 或 GB/s | 判断对象创建压力与年轻代回收需求 |
| GC pause time | % | 判断请求时间有多少被暂停直接占用 |
同时保存 JDK 版本、GC 类型、完整 JVM 参数、应用提交版本、机器规格、测试数据版本和 k6 脚本。没有这些上下文,即使两组 P99 都精确到毫秒,也不具备可比性。
判断这条基线能不能用
先看三轮结果是否聚集。如果吞吐、P95/P99 或 CPU 在相同条件下大幅漂移,应先找环境噪声,例如 CPU 争用、后台任务、JIT 尚未稳定、缓存冷热不一致或数据库状态变化,而不是立刻开始改堆大小。
真正可用的基线应能回答一个具体问题:在同样的请求模型下,调优后是否以相同或更低 CPU 获得更高吞吐、更低 P99、更低分配速率或更少 GC 暂停。只有把负载条件和指标口径一起固定,后续的 JVM 参数变化才有可验证的因果意义。