
智能制造与工业软件 / 系统课时
排查设备在线却没有新测点的故障
排查设备在线却没有新测点的故障
设备显示在线,但温度、压力或运行状态长时间不更新时,不应立即重启网关或修改采样配置。通过逐层检查协议连接、点位地址、采样质量、MQTT 消息和平台入库记录,可以找出数据首次中断的位置,并用时间戳、计数器和日志验证修复是否有效。
学习目标
- 区分设备在线、采集正常和测点持续更新三种不同状态。
- 按协议连接、点位地址、采样质量、消息订阅和平台入库的顺序定位故障。
- 使用 MQTT 订阅命令和逐层时间戳建立可复查的排障证据链。
从在线状态和测点时间确定排查范围
设备在线通常表示网关心跳正常、MQTT 会话仍然存在,或设备连接状态尚未过期。它不保证 Modbus 寄存器仍能读取,也不保证 OPC UA 订阅仍在产生有效数据。首先确认在线标志来自哪一层,再检查具体测点最后一次采样、发布和入库的时间。
以设备 m01 的温度测点为例,假设采样周期为 5 秒,当前时间为 10:01:00,观察到以下记录:
| 观测信号 | 示例时间 | 初步判断 |
|---|---|---|
| 网关最近心跳 | 10:00:55 | 在线状态仍在更新 |
| 测点最近采样 | 10:00:58 | 采样任务可能仍在运行 |
| 测点最近发布 | 09:56:01 | 边缘侧已停止发送新事件 |
| 平台最近入库 | 09:56:03 | 下游没有收到更新 |
该例应优先调查采样结果是否被质量过滤、变化死区或发送队列阻断,而不是直接认定设备离线。不过,最近采样时间更新也不能单独证明采集成功,还需要核对采样成功次数、错误计数以及原始值。
所有时间应统一时区,建议使用 UTC 存储。对照时必须限定相同的 deviceId 和 pointId,不能用网关心跳时间代替设备测点的事件时间。
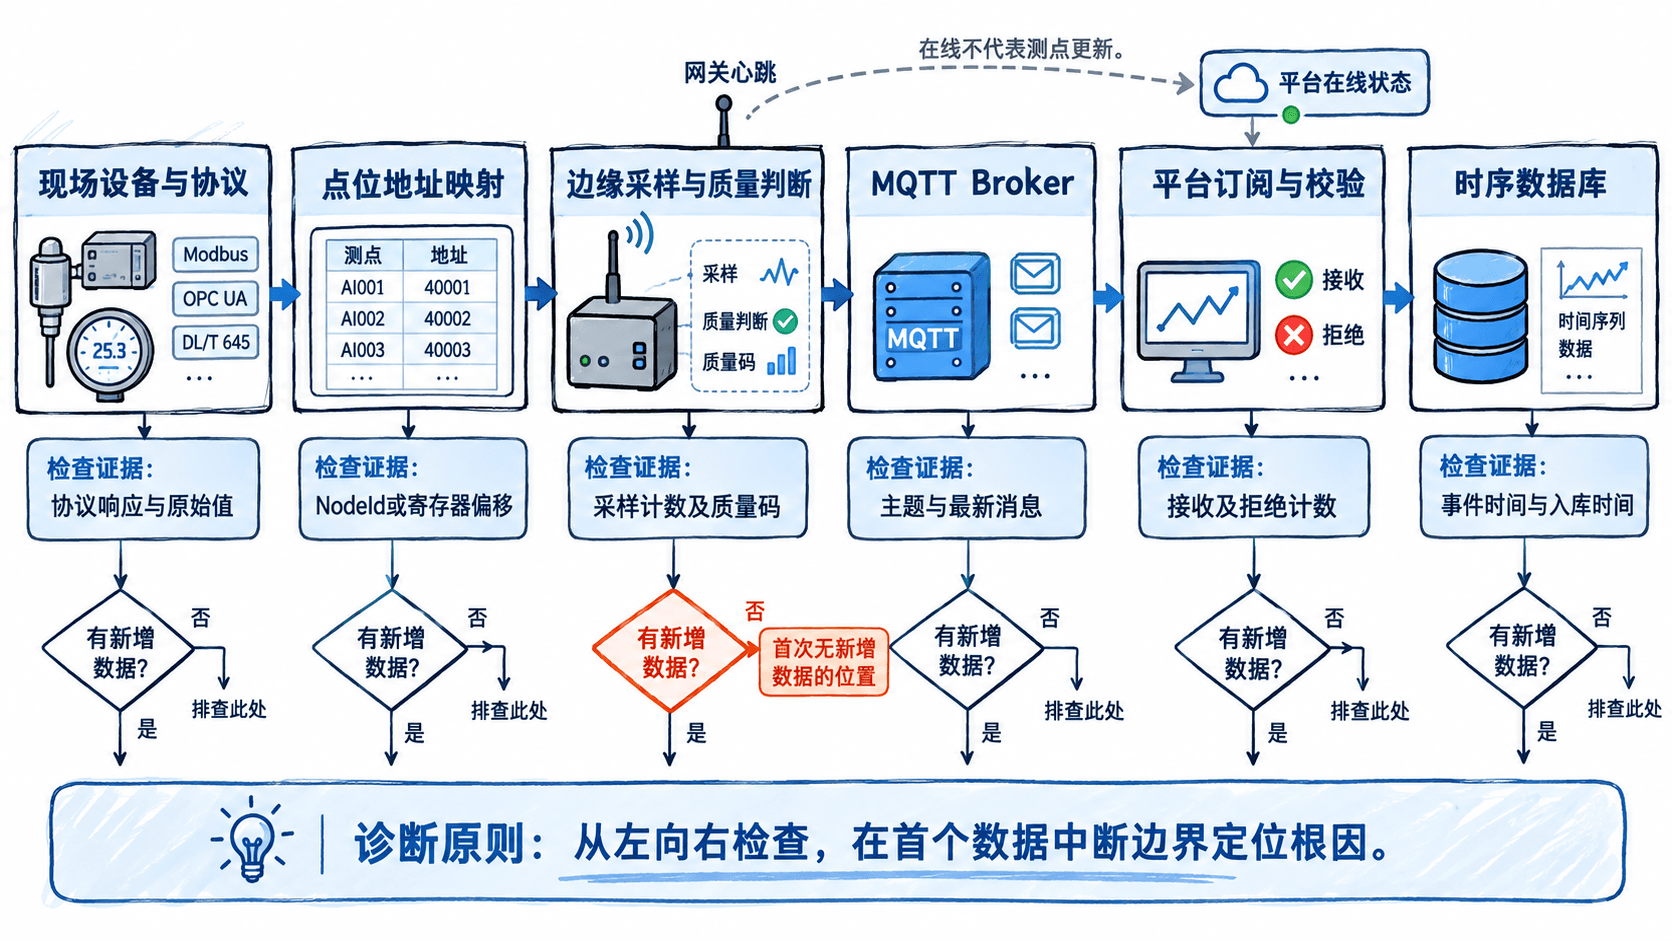
核实协议连接和测点源地址
先在授权的诊断客户端对故障测点执行只读操作。应使用与边缘采集器相同的设备端点、设备标识和点位地址,避免测试了另一个正常变量,却错误判断原测点没有问题。
对于 Modbus TCP,依次检查设备地址、TCP 端口、网关场景中的 Unit ID、功能码和寄存器偏移。Modbus TCP 常用端口为 502,但实际部署可能不同。保持寄存器使用 FC03,输入寄存器使用 FC04,两者不能混用。
例如,某设备手册采用从 1 开始的保持寄存器编号,并将温度放在 40001。对应的 Modbus PDU 起始地址是 0,但某些客户端会自动转换编号,必须查看软件的地址输入规则。假设读取原始值为 850,手册规定缩放系数为 0.1,则温度为 85.0°C。若返回非法数据地址异常,应优先检查编号基准、寄存器类型和数量,而不是反复重连。
对于 OPC UA,可以使用 UaExpert 等客户端浏览服务器地址空间,定位配置中的 NodeId,并检查变量的 Value、StatusCode 和 SourceTimestamp。重点确认读取的是实际生产变量,不是已经废弃的节点或缓存值。
- 连接失败:检查端点地址、端口、证书信任关系、用户权限和服务器会话状态。
- 连接成功但读取失败:核对
NodeId、访问权限及服务器返回的状态码。 - 读取成功但数据陈旧:比较源时间戳,并连续观察读取结果和采集器收到的通知。
检查采样周期、数据质量和边缘队列
源地址可以读取之后,应检查采集器为什么没有生成新事件。重点比较采样任务执行次数、成功读取次数、质量过滤次数、消息入队次数和成功发送次数。实际产品的计数器名称可能不同,但需要具备相同的观测能力。
假设边缘配置为每 5 秒采样一次,温度变化死区为 0.5°C。如果上次发布值为 23.0°C,之后连续采样得到 23.1°C、23.2°C、23.3°C,在仅按变化量发布的策略下,没有新消息可能是正常现象。不能直接将 15 秒无新消息解释为采集失败。
OPC UA 的 DataChangeFilter 也可能仅在数值或状态发生变化时通知客户端。STATUS_VALUE 触发模式不会单纯因为时间经过就不断产生数据变化通知。采样间隔、发布间隔和业务要求的定期心跳是不同的配置项,应分别检查。
建议按照以下顺序核对:
- 检查采集任务是否启用,实际采样间隔是否与配置相符。例如轮询采集设置 5 秒,应观察连续 3 次计划执行情况。
- 核对
Good、Uncertain、Bad等质量状态。Bad表示数据不可正常使用,不应擅自转换成数值零;检查是否被质量过滤器拒绝。 - 检查死区及定期刷新策略。若业务要求静态测点也证明存活,可配置独立的采集健康指标或周期刷新,例如 60 秒一次,并按实际能力实施。
- 检查边缘持久化队列中的待发送条数、最旧消息时间、重试次数与确认进度,判断消息是否已经采集却积压在网关。
如果原始值变化、质量正常、采样成功计数增加,但发布计数始终不变,应转向边缘事件生成、过滤和队列模块。若发布计数增加而平台仍无数据,则继续沿消息链路检查。
验证 MQTT Broker 是否收到实时消息
对于使用 MQTT 上传测点的链路,应从 Broker 侧确认指定主题是否存在新的发布事件,而不是仅查看客户端连接数。特别注意保留消息:刚订阅就收到上一次保存的状态,不代表设备此刻还在持续发布。
下面使用 Mosquitto 2.x 客户端进行只读订阅验证。示例假设本机测试 Broker 监听 127.0.0.1:1883,已有发布端向指定主题发送遥测消息,并且诊断客户端具有订阅权限。Linux 可预先安装发行版提供的 mosquitto-clients 软件包。
# 只观察实时消息,不向现场设备发送控制指令
mosquitto_sub -h 127.0.0.1 -p 1883 -t 'iiot/v1/f01/l02/m01/telemetry' -R -v -C 1 -W 15
预期结果:如果连接成功,并在 15 秒观察窗口内收到一条非保留的实时消息,输出形式如下。<PAYLOAD> 表示现场实际消息内容,并非固定值。
iiot/v1/f01/l02/m01/telemetry <PAYLOAD>参数 -R 用于不打印保留标志已设置的消息,-v 同时显示主题与载荷,-C 1 收到一条符合条件的消息后退出,-W 15 设置连接成功后的消息处理超时。若无新消息,命令将在超时后结束;连接或权限错误也可能导致提前失败,应区分这些情况。
生产环境必须替换为真实 Broker 地址、端口和主题,并使用既有 TLS、证书及身份认证配置,不能为了排障关闭认证或扩大订阅权限。具体参数可查阅 Mosquitto 官方命令手册。
当边缘日志显示已发布,但独立订阅端没有收到消息时,检查以下证据:
- 发布目标是否为当前 Broker,是否存在主备环境或命名空间混淆。
- 实际主题是否与平台订阅过滤器一致。例如
iiot/v1/f01/l02/+/telemetry可以匹配单层设备编号,而省略设备层级的过滤器不能匹配该主题。 - 发布是否获得对应 QoS 的协议确认,是否存在重连、ACL 拒绝或客户端会话失效。
追踪平台校验、入库与修复验收
如果 Broker 已出现实时测点消息,而平台页面仍显示旧值,就需要把平台订阅、消息校验、写入存储和查询展示拆开检查。不要直接以看板是否变化判断消息有没有进入数据库。
首先确认平台消费者使用的主题过滤器与消息格式一致,并按设备编号、测点编号和消息时间寻找对应的接收记录。建议同时检查接收数、接受数、拒收数、重试数和死信数,避免把格式错误或设备映射失败误判为网络故障。
| 已确认的现象 | 优先排查位置 |
|---|---|
| 源设备读取正常,边缘成功采样计数不增加 | 轮询任务、订阅状态或点位映射 |
| 采样正常,发送计数不增加 | 质量过滤、变化死区或边缘发送队列 |
| Broker 有新消息,平台接收计数不增加 | 主题订阅、ACL、消费者连接或消费积压 |
| 平台接收增加,但接受或入库计数不增加 | 载荷格式、设备资产映射、质量规则或写入失败 |
| 数据库有新记录,看板仍显示旧值 | 查询条件、时间范围、聚合窗口或缓存刷新 |
平台入库排查应同时查看事件时间 event_time 和入库时间 ingested_at,这两个名称是示例字段,实际以项目表结构为准。如果入库时间持续更新而事件时间始终停留在过去,可能正在消费历史补传数据;如果两者都不更新,则继续追踪消费者处理和数据库写入错误。
还要注意幂等去重:同一设备事件因 QoS 重投或断线补传再次到达时,平台可能正确地忽略重复记录。应通过事件唯一键或业务去重键确认,不可仅凭收到消息但新增行数为零就断定入库失败。
修复后按以下条件验收:
- 使用原故障测点完成只读核验,确认采样成功、质量有效,并观察至少 3 个预期采集周期。对于仅按变化推送的测点,选择自然变化的运行时段或等待已配置的周期刷新。
- 比较边缘发送记录和 Broker 实时消息,确认主题、测点标识与事件时间一致,不再持续积压新数据。
- 在平台查询同一测点最近 5 条实际记录,确认事件时间符合预期、入库时间合理,且没有异常重复或因设备时钟偏移造成的时间倒退。
- 确认看板能够展示最新有效值,同时记录故障起止时间、首次异常边界、修复配置及复测证据。
最终应能够明确回答三件事:现场是否产生了有效数据、数据在哪个组件首次停止前进、恢复后有没有真实的新事件完成入库。只有这三项都有证据,才能将故障判定为已修复。