
智能制造与工业软件 / 系统课时
为设备断连和采集超时设置状态
为设备断连和采集超时设置状态
边缘网关不能把一次读取超时直接判为设备离线,也不能把温度连续不变当成通信中断。本课为每秒采集一次的测点定义五态连接机、独立的数据有效性标记和重试阈值,再通过可运行脚本验证断连及恢复过程。
学习目标
- 依据连续通信失败次数,定义连接中、在线、疑似故障、离线和恢复中的迁移条件。
- 区分通信失败、测点质量异常与测量值保持不变。
- 用确定的事件序列检查离线、重试恢复及缓存过期的结果。
把连接状态和测点状态分开记录
连接状态回答“网关能否与设备完成协议交互”,测点状态回答“最近这条值能否被使用”。至少保留 connectionState、lastResponseAt、lastGoodSampleAt、lastValue 和 dataStatus,不能仅靠一个 online 布尔值判断两件事。
例如,Modbus TCP 每次读请求都收到正常响应、温度始终是 25.0℃,仍属于在线且数据在持续更新。OPC UA 订阅未收到变化通知时,也不能直接推定连接断开;应检查会话或订阅保活、显式读取等通信证据。
| 测点标记 | 判定规则 | 下游处理 |
|---|---|---|
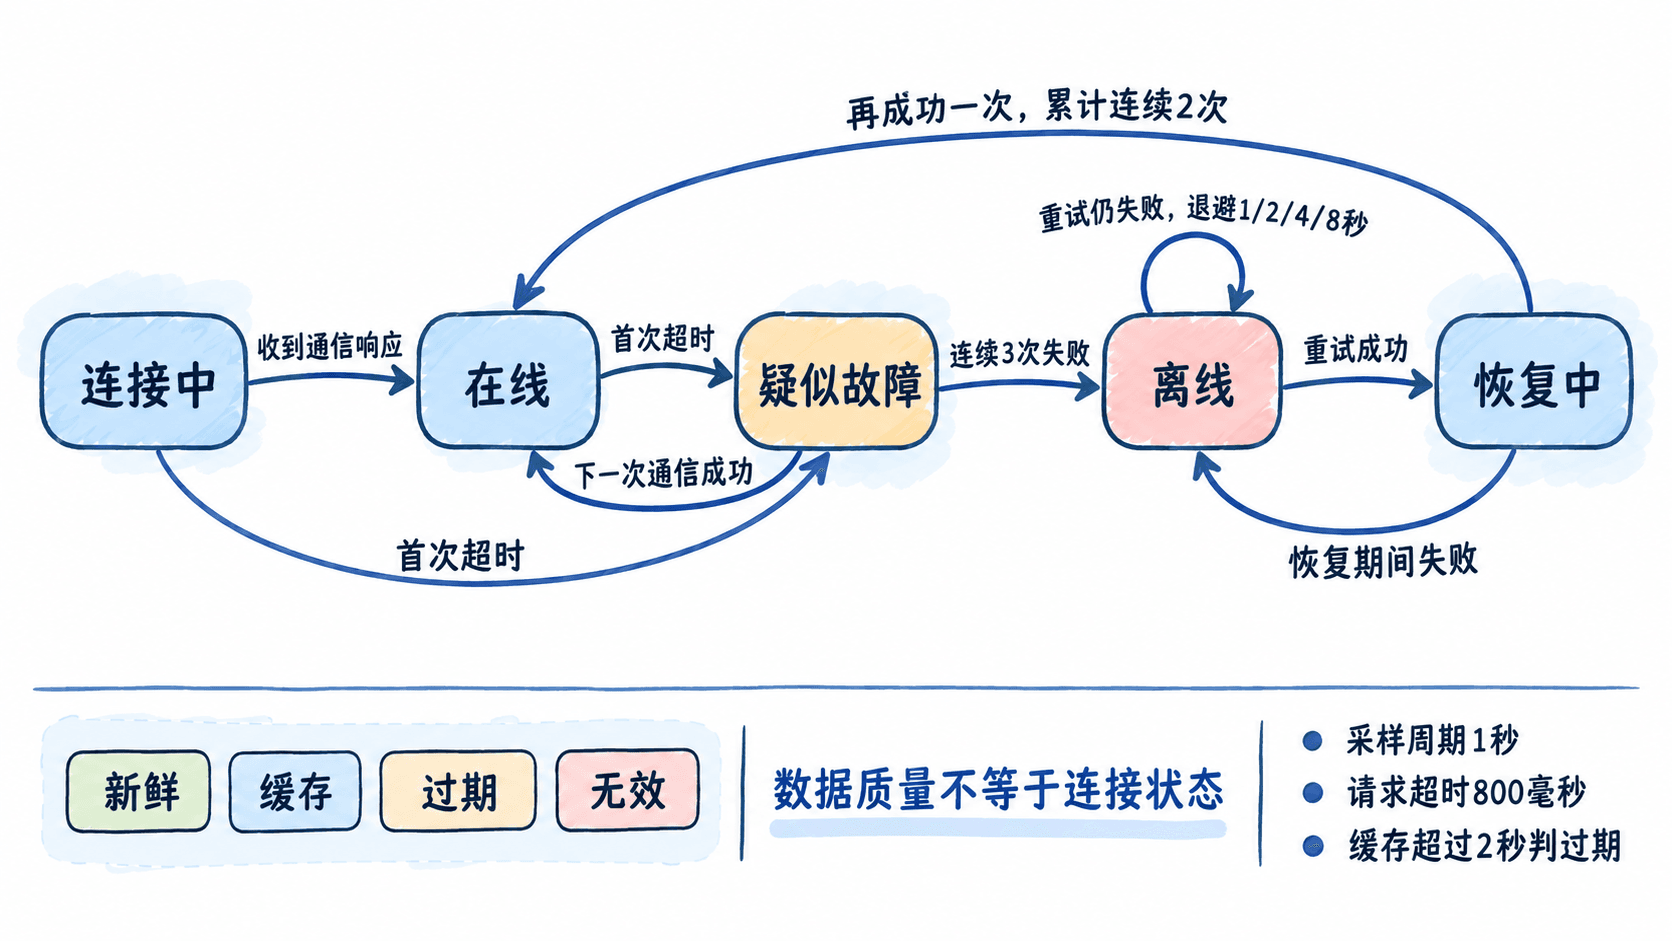
| 新鲜 | 本轮成功取得有效测点值 | 连接稳定在线时可以参与实时计算 |
| 缓存 | 本轮通信失败,但距上次有效采样不超过 2 秒 | 只展示旧值并标识缓存 |
| 过期 | 无有效样本,或旧样本年龄超过 2 秒 | 停止按实时值计算 |
| 无效 | 有通信响应,但质量码不良或数值校验失败 | 标记坏质量,不计作设备断连 |
这里的 2 秒是示例系统的业务阈值,不是 Modbus 或 OPC UA 规定的统一值。实际项目应结合采样频率、测点变化速度和告警需求确定;控制与联锁不能把“缓存”当成可信实时反馈。
定义五态迁移和重试门槛
以采样周期 1 秒、单次请求超时 800 毫秒的轮询点为例,只把超时、传输断开或协议会话失效计入通信失败。设备返回质量差的值或业务校验失败时,通信仍可算成功,但点位应记为无效。
| 当前状态 | 触发条件 | 下一状态 |
|---|---|---|
| 连接中 | 首次通信成功 / 首次失败 | 在线 / 疑似故障 |
| 在线 | 一次通信失败 | 疑似故障 |
| 疑似故障 | 通信成功 / 连续失败累计 3 次 | 在线 / 离线 |
| 离线 | 定时重试成功 | 恢复中 |
| 恢复中 | 再成功一次 / 任何一次失败 | 在线 / 离线 |
离线后使用 1、2、4、8 秒递增重试,之后以 8 秒为上限;每次失败才增加退避档位,通信恢复后复位。大批设备可对退避时间加入约 ±10% 随机扰动,以免重连瞬间集中。离线后的第一次成功仅进入恢复中,连续第二次成功才宣布在线,避免一次偶然成功造成状态闪烁。
用 Python 复现断连与恢复
下面是 Python 3.10 及以上版本可直接运行的最小状态判定器。输入代表一次采集尝试结束时的结果,不会真正连接工业设备;网络请求定时、800 毫秒超时和退避调度应由网关采集任务实现。comm_ok 代表通信有响应,point_ok 代表值通过质量和解析校验。
from dataclasses import dataclass

@dataclass
class Collector:
    connection: str = "连接中"
    failures: int = 0
    recovery_successes: int = 0
    last_response_t: int | None = None
    last_good_t: int | None = None
    last_value: float | None = None

    def observe(self, t: int, comm_ok: bool,
                point_ok: bool, value: float | None) -> str:
        # 通信可达性与测点有效性分别更新
        if comm_ok:
            self.last_response_t = t
            self.failures = 0
            if self.connection == "离线":
                self.connection, self.recovery_successes = "恢复中", 1
            elif self.connection == "恢复中":
                self.recovery_successes += 1
                if self.recovery_successes >= 2:
                    self.connection = "在线"
            else:
                self.connection, self.recovery_successes = "在线", 0
        else:
            self.recovery_successes = 0
            if self.connection == "恢复中":
                self.failures, self.connection = 3, "离线"
            else:
                self.failures += 1
                self.connection = "离线" if self.failures >= 3 else "疑似故障"

        # 相同读数仍刷新样本时间;失败时只能使用旧值
        if comm_ok and point_ok and value is not None:
            self.last_good_t, self.last_value = t, value
            data = "新鲜"
        elif comm_ok:
            data = "无效"
        elif self.last_good_t is not None and t - self.last_good_t <= 2:
            data = "缓存"
        else:
            data = "过期"
        return f"t={t} 连接={self.connection} 数据={data} 值={self.last_value}"

events = [
    (0, True, True, 25.0),
    (1, True, True, 25.0),
    (2, False, False, None),
    (3, False, False, None),
    (4, False, False, None),
    (5, True, True, 25.0),
    (6, False, False, None),
    (7, True, True, 25.0),
    (8, True, True, 25.0),
    (9, True, False, None),
]
collector = Collector()
for event in events:
    print(collector.observe(*event))
预期输出:
t=0 连接=在线 数据=新鲜 值=25.0
t=1 连接=在线 数据=新鲜 值=25.0
t=2 连接=疑似故障 数据=缓存 值=25.0
t=3 连接=疑似故障 数据=缓存 值=25.0
t=4 连接=离线 数据=过期 值=25.0
t=5 连接=恢复中 数据=新鲜 值=25.0
t=6 连接=离线 数据=缓存 值=25.0
t=7 连接=恢复中 数据=新鲜 值=25.0
t=8 连接=在线 数据=新鲜 值=25.0
t=9 连接=在线 数据=无效 值=25.0
t=1 数值未变但采集成功;t=4 连续第三次失败转离线,且旧值已超过 2 秒;t=6 恢复期间再次失败,退回离线;t=9 收到响应但点位无效,连接仍保持在线。
将状态输出接入告警与恢复检查
每条采集记录至少携带设备标识、测点标识、连接状态、数据状态、采集完成时间及最后有效采样时间。状态变化事件应只在状态真正发生迁移时发送,避免每秒重复触发离线告警;采集指标则可以每轮上报超时次数与成功率。
上线前至少回放四组输入:连续 3 次超时、单次超时后成功、离线恢复时再失败、通信成功但质量码异常。逐项核对告警触发和清除、缓存是否被标成旧值,以及离线期间是否仍有消费端错误地把 25.0 当成最新温度。