
智能制造与工业软件 / 系统课时
为上报选择 QoS 和会话过期策略
为上报选择 QoS 和会话过期策略
设备每秒上报温度,也会产生停机、过温等事件。若全部使用 QoS 2,确认交互与离线积压会增加;若一律使用 QoS 0,关键事件可能丢失。下面以边缘网关上报到 MQTT Broker 为例,选定交付级别、会话保留期、重连缓存和应用层去重规则。
学习目标
- 根据数据丢失容忍度,正确选择 MQTT QoS 0、1、2。
- 为 MQTT 5 客户端设置
Clean Start、Session Expiry Interval并处理重连。 - 估算断网积压,验证 QoS 1 确认和事件幂等入库。
按业务价值选择 QoS
| 级别 | MQTT 交付语义 | 适合的工业数据 | 需要接受的代价 |
|---|---|---|---|
| QoS 0 | 最多一次;没有 MQTT 层确认 | 每秒一条温度采样,后续新值可弥补缺口 | 断链或丢包时可能丢样本 |
| QoS 1 | 至少一次;以 PUBACK 确认 |
停机、过温告警、重要状态变化 | 重试后可能收到重复事件 |
| QoS 2 | MQTT 单段链路的恰好一次交付流程 | 少量对协议层重复投递极敏感的消息 | 四步握手、更多状态与交互 |
QoS 0 仅发送 PUBLISH;QoS 1 使用 PUBLISH → PUBACK;QoS 2 使用 PUBLISH → PUBREC → PUBREL → PUBCOMP。图中将三种往返关系并列,便于对照确认开销。
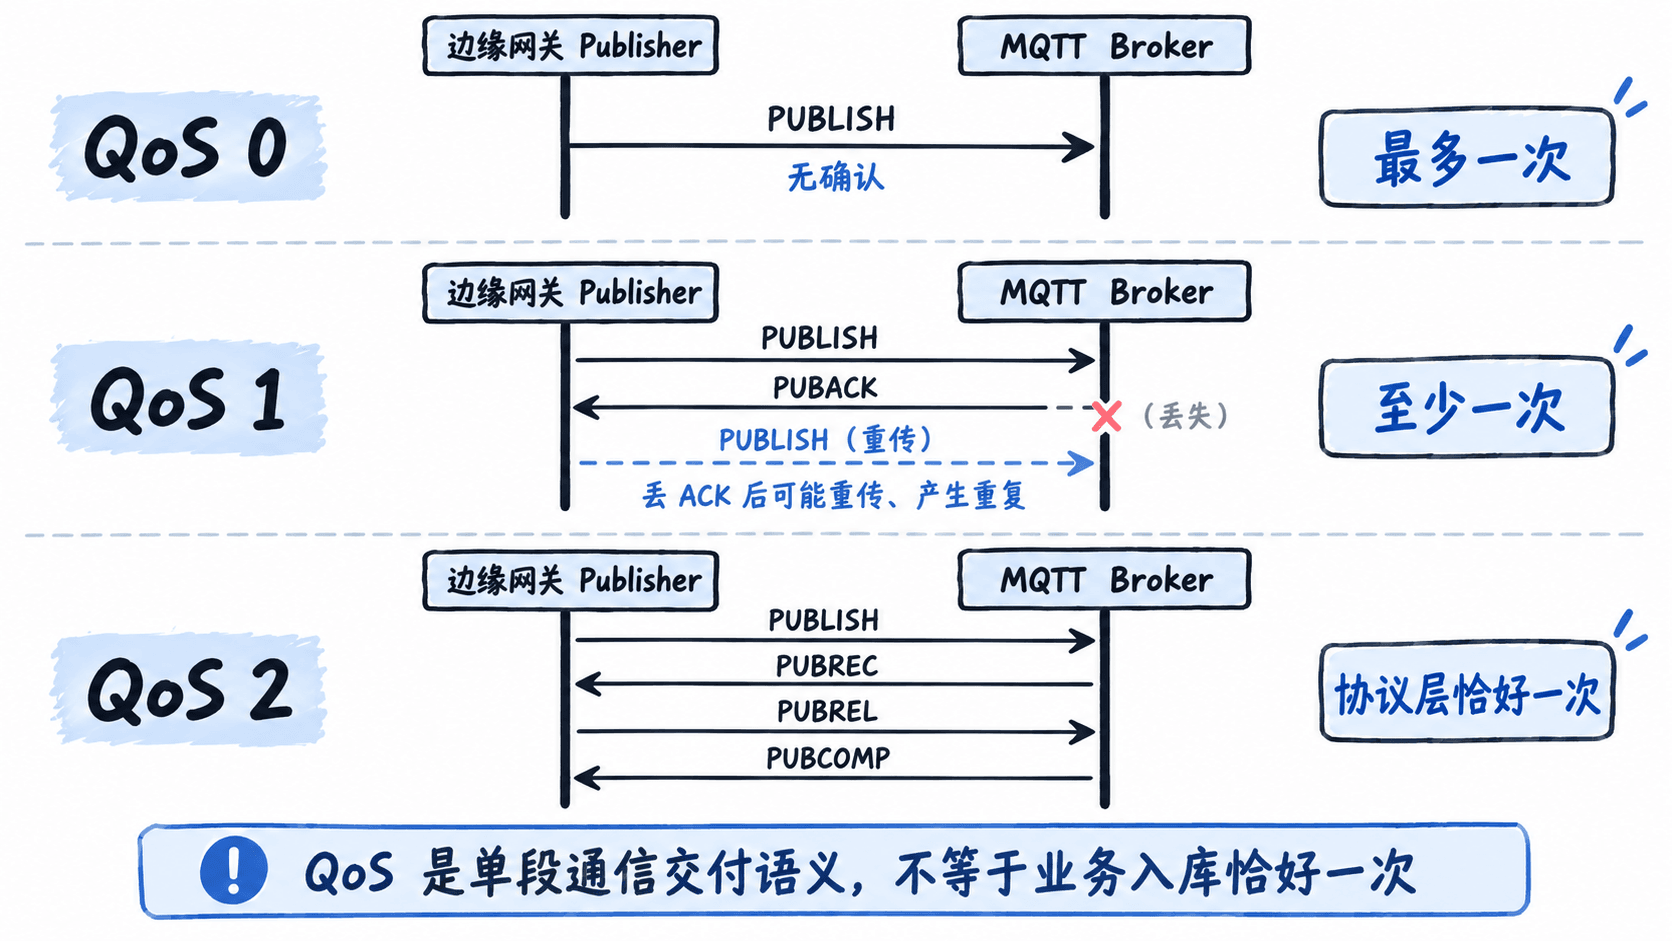
同一消息经过网关到 Broker、Broker 到平台两个交付段时,分别受发布 QoS 与订阅 QoS 约束。比如网关以 QoS 1 发布,而平台只以 QoS 0 订阅,平台这一段并不具备 QoS 1 确认保障。重要事件应让两段都支持至少 QoS 1。
为重连设置会话过期
MQTT 5 将“是否从旧会话开始”和“断线后保留多久”分开配置。需要恢复会话的固定网关可选 Clean Start = false、Session Expiry Interval = 7200(秒),并保持同一 Client ID。这允许在 Broker 实际保留会话且断线未超过两小时的前提下恢复状态;首次连接没有旧会话也会创建新会话。省略该过期属性时 MQTT 5 默认值为 0,即断线后不保留会话。
| 连接或断线情况 | 结果及客户端动作 |
|---|---|
Clean Start = true |
丢弃已有会话,重新开始 |
Clean Start = false 且 Session Present = 1 |
旧会话恢复;已有订阅通常无需重订 |
Session Present = 0 |
旧会话不存在;订阅客户端必须重新订阅 |
断线超过 Session Expiry Interval |
旧会话及其中积压的消息被清除 |
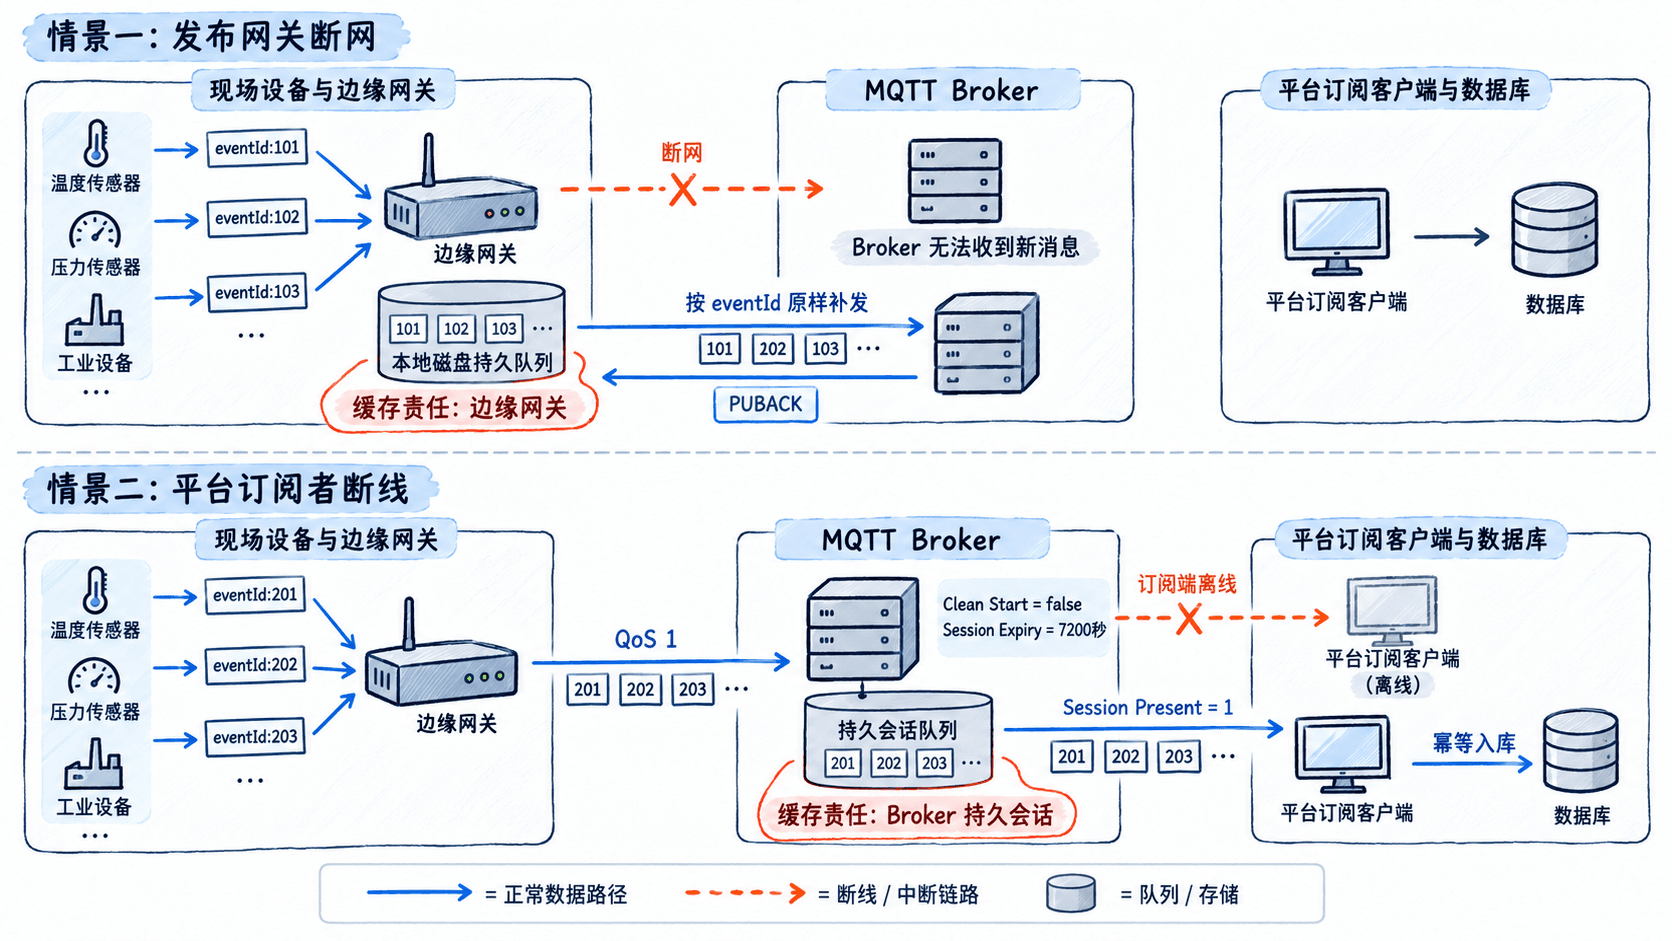
如果平台只关心最近 5 分钟的实时遥测,可另给 MQTT 5 消息设置 Message Expiry Interval = 300 秒,以防恢复后消费过时样本;它与 Session Expiry Interval 是两个独立参数。关键停机事件不应直接套用这个短消息寿命。
运行一次 QoS 1 上报
准备支持 MQTT 5 的本地 Broker,监听 127.0.0.1:1883,并安装 Python paho-mqtt 2.x(例如运行 python -m pip install "paho-mqtt>=2,<3")。以下程序显式设置两小时会话过期,等待 Broker 完成 QoS 1 确认后才报告发送完成;实验端口为 1883,真实部署可能不同。
import json
from threading import Event
from uuid import uuid4

from paho.mqtt import client as mqtt
from paho.mqtt.packettypes import PacketTypes
from paho.mqtt.properties import Properties

connected = Event()

def on_connect(client, userdata, flags, reason_code, properties):
    # 等待 CONNACK,避免在未确认连接时直接发布。
    if not reason_code.is_failure:
        connected.set()

client = mqtt.Client(
    mqtt.CallbackAPIVersion.VERSION2,
    client_id="edge-gw-machine01",
    protocol=mqtt.MQTTv5,
)
client.on_connect = on_connect
properties = Properties(PacketTypes.CONNECT)
properties.SessionExpiryInterval = 7200

event_id = str(uuid4())
payload = {
    "eventId": event_id,
    "deviceId": "machine01",
    "kind": "temperature_high",
    "value": 91.2,
}
client.connect("127.0.0.1", 1883, keepalive=60,
               clean_start=False, properties=properties)
client.loop_start()
try:
    if not connected.wait(5):
        raise TimeoutError("未收到成功的 CONNACK")
    # QoS 1 的完成表示发布握手结束,不表示数据库已经写入。
    info = client.publish(
        "factory/machine01/events", json.dumps(payload), qos=1
    )
    info.wait_for_publish(timeout=10)
    if not info.is_published():
        raise TimeoutError("10 秒内未完成 PUBACK 确认")
    print(f"QoS 1 已确认: {event_id}")
finally:
    client.disconnect()
    client.loop_stop()
预期输出(在 Broker 正常接收并确认发布的情况下,<ID> 是每次新生成的事件 UUID):
QoS 1 已确认: <ID>这里固定 client_id 用于恢复会话,但每次执行都会创建一个新事件。生产中若同一事件因超时需要重试,必须复用已经落盘的原始 eventId 和载荷;进程重启后不能依赖 Python 进程内存保存尚未确认的消息。还应检查 MQTT 5 的 PUBACK Reason Code,区分正常确认与服务端拒绝消息。
估算积压并验证去重
假设网关每秒产生 2 条重要事件、每条 JSON 载荷约 250 B,断网 45 分钟就有 2 × 45 × 60 = 5400 条,裸载荷约 1.35 MB,还不包括队列索引与磁盘日志。可给本地重要事件队列预留至少 6000 条的容量;按 2 条/秒计算,仅能覆盖约 50 分钟,超过上限必须触发告警并启用独立的高优先级告警保留策略。补发速率若限制在 20 条/秒,恢复时仍持续产生 2 条/秒,追平 5400 条旧积压约需 5400 ÷ (20 − 2) = 300 秒。
验收时依次检查:先让平台以 QoS 1 订阅并建立持久会话,断开平台客户端后继续发布,再在 7200 秒内以原 Client ID、Clean Start = false 重连,观察 Session Present = 1 并消费允许保留的积压;然后断开发布网关,确认新事件只进入本地队列,联网后按原 eventId 补发。最后对同一个 eventId 主动投递两次,在平台数据库设置唯一键 (device_id, event_id),要求两次 MQTT 投递只形成一条业务记录。
可对照 MQTT 5.0 官方规范 与 Paho Python 2.x API 文档 核查会话属性和发布确认行为。