
智能制造与工业软件 / 系统课时
用落盘队列恢复断网期间的数据
用落盘队列恢复断网期间的数据
边缘网关与平台断连时,采集数据不能只保存在内存中,也不能把发送成功当成已经入库。本课使用 SQLite 构建持久化队列,演示断网写入、进程重启恢复、按序补传、确认后清理和容量限制,并验证确认丢失时不会产生重复的云端记录。
学习目标
- 理解落盘队列的持久化边界、顺序标识和确认后删除机制。
- 使用 Python 与 SQLite 完成断网缓存、重启恢复和幂等补传实验。
- 根据采集速率和断网窗口计算缓存容量,制定限额、告警与溢出策略。
确定入队、补传和清理的边界
工业网关通常需要持续读取 PLC、传感器或 OPC UA 服务器中的测点。如果上游采集正常,但云端 MQTT Broker 或数据接收接口暂时不可达,直接发送会导致数据丢失;只放在内存列表中,又无法抵御网关进程崩溃或设备重启。
采用持久化 Outbox 队列后,每条事件依次经历以下步骤:
- 采集器生成标准化事件,包含设备标识、顺序号、事件时间、数值和质量标志。
- 将事件写入本地数据库,并等待事务成功提交。
- 上传器读取尚未确认的事件,通过网络发送到平台。
- 平台依据事件唯一标识完成幂等写入,成功提交后返回应用层确认。
- 网关收到对应确认后,才从本地队列删除事件并提交删除事务。
断网时停止第 3 步之后的网络交互,但采集器仍可在容量允许时持续入队。网络恢复后,上传器扫描未确认的数据,从最早的事件开始补传。
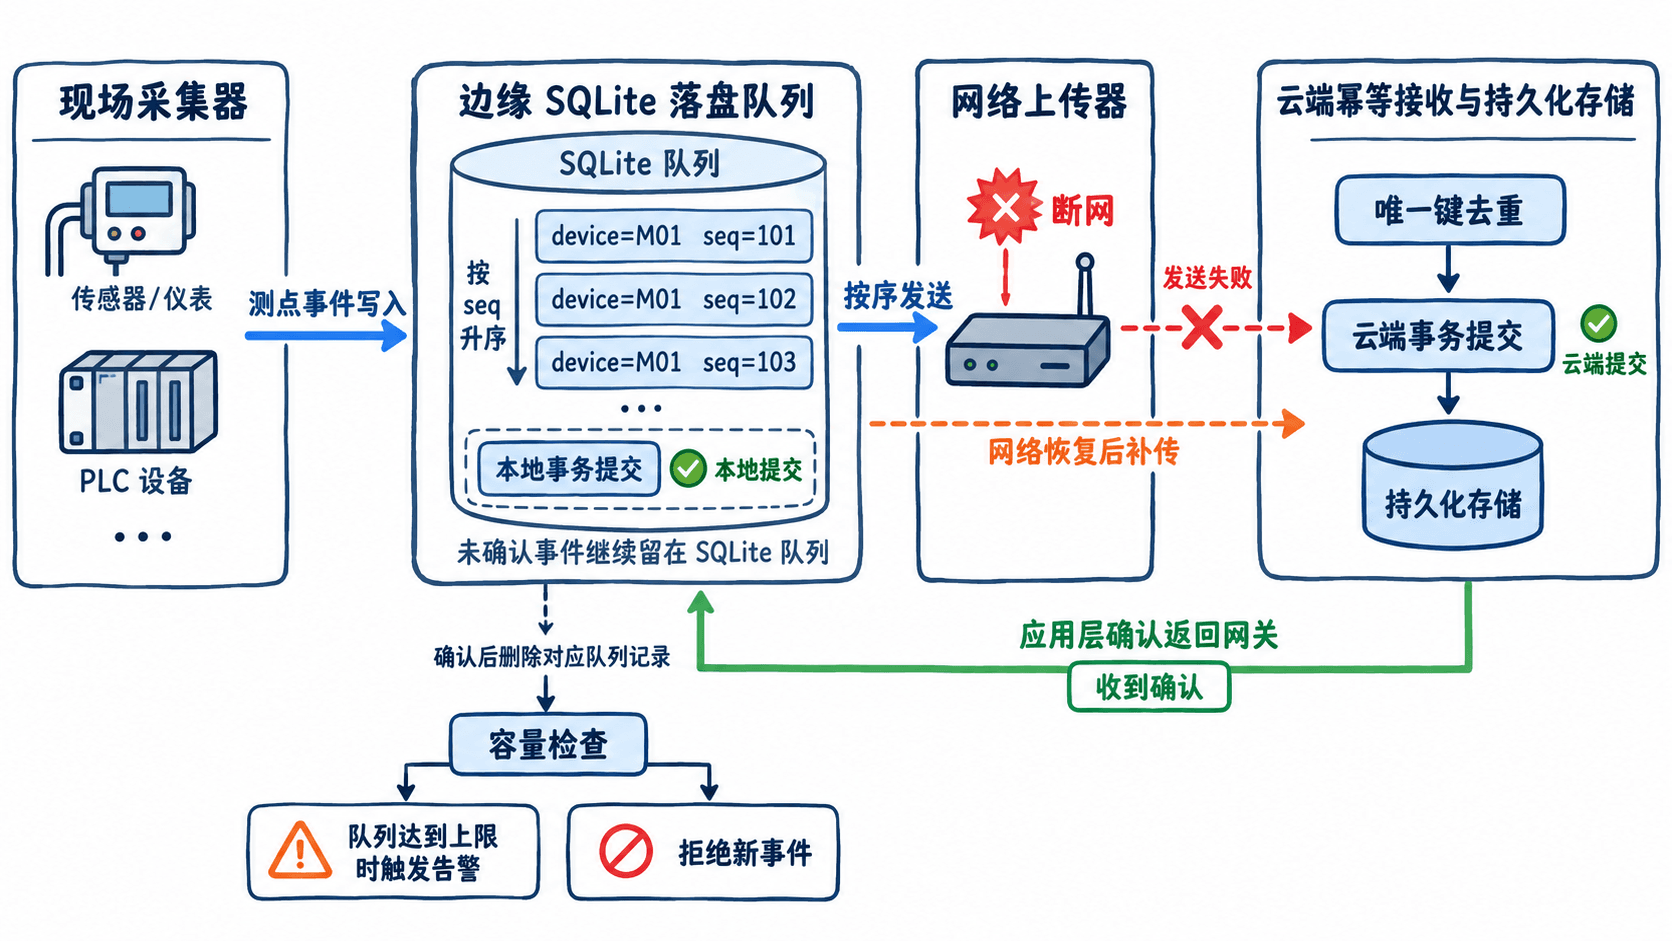
这里必须区分三种成功状态:本地事务已提交、网络协议已确认、平台业务数据已持久化。它们不是同一个事件。例如 MQTT QoS 1 的 PUBACK 不能直接证明后端时序数据库已经写入成功。如果系统要求端到端落库确认,需要接收服务在持久化完成后另外提供具有明确语义的应用层 ACK。
每条事件使用 deviceId + seq 作为幂等标识。seq 在设备维度单调递增,网关重启后不能重新从 1 开始分配已经使用过的序号。生产实现应将序号分配状态持久化,并尽可能在同一数据库事务中完成序号分配与事件入队。
使用 SQLite 实现可恢复的 Outbox
下面使用 Python 3.10 及以上版本的标准库 sqlite3 构建最小实验,不依赖真实工业设备和外部消息服务。
实验采用两个独立的 SQLite 文件:edge.db 模拟网关本地队列,cloud.db 模拟平台持久化存储。设置队列最多容纳 3 条未确认记录,连续采集序号 101~104,随后模拟网关进程重启、云端确认丢失及网络恢复。
数据库使用 PRAGMA journal_mode=WAL 和 PRAGMA synchronous=FULL。WAL 支持日志式事务提交,FULL 模式提高已提交事务在故障后的持久性保障,但仍依赖底层存储正确执行同步写入。生产环境应使用可靠的持久化磁盘或数据卷,而不是随容器销毁的临时文件系统。
将下面代码保存为 outbox_demo.py,使用 python outbox_demo.py 运行:
import sqlite3
from pathlib import Path
from tempfile import TemporaryDirectory


def connect(path):
    db = sqlite3.connect(path)
    db.execute("PRAGMA journal_mode=WAL")
    db.execute("PRAGMA synchronous=FULL")
    return db


def enqueue(db, device, seq, temperature, limit=3):
    # 写锁保护容量检查与插入,避免并发越过条数上限
    db.execute("BEGIN IMMEDIATE")
    try:
        count = db.execute("SELECT COUNT(*) FROM outbox").fetchone()[0]
        if count >= limit:
            db.rollback()
            return False
        db.execute(
            "INSERT INTO outbox VALUES (?, ?, ?)",
            (device, seq, temperature),
        )
        db.commit()
        return True
    except Exception:
        db.rollback()
        raise


def pending(db):
    return db.execute("SELECT COUNT(*) FROM outbox").fetchone()[0]


def replay(edge, cloud, lose_ack=False):
    while True:
        row = edge.execute(
            "SELECT device, seq, temperature FROM outbox ORDER BY seq LIMIT 1"
        ).fetchone()
        if row is None:
            break

        # 云端使用复合主键去重,提交成功才具备确认条件
        cloud.execute("INSERT OR IGNORE INTO received VALUES (?, ?, ?)", row)
        cloud.commit()
        if lose_ack:
            print(f"模拟确认丢失: {row[1]}")
            return

        # 只有取得应用层确认,才能清除对应的本地事件
        edge.execute("DELETE FROM outbox WHERE device=? AND seq=?", row[:2])
        edge.commit()


with TemporaryDirectory() as folder:
    edge_path = Path(folder) / "edge.db"
    cloud_path = Path(folder) / "cloud.db"
    edge, cloud = connect(edge_path), connect(cloud_path)
    edge.execute(
        "CREATE TABLE outbox (device TEXT, seq INTEGER, temperature REAL, "
        "PRIMARY KEY (device, seq))"
    )
    cloud.execute(
        "CREATE TABLE received (device TEXT, seq INTEGER, temperature REAL, "
        "PRIMARY KEY (device, seq))"
    )
    edge.commit()
    cloud.commit()

    for seq, temp in [(101, 45.1), (102, 45.2), (103, 45.3), (104, 45.4)]:
        accepted = enqueue(edge, "M01", seq, temp)
        print(f"离线写入 {seq}: {'已入队' if accepted else '队列已满'}")

    edge.close()
    edge = connect(edge_path)  # 重新打开文件,模拟网关进程重启
    print("网关重启后待发:", pending(edge))
    replay(edge, cloud, lose_ack=True)
    print("首次补传后待发:", pending(edge))
    replay(edge, cloud)
    print("恢复后待发:", pending(edge))
    print(
        "云端顺序:",
        [row[0] for row in cloud.execute("SELECT seq FROM received ORDER BY seq")],
    )
    edge.close()
    cloud.close()
预期输出:
离线写入 101: 已入队
离线写入 102: 已入队
离线写入 103: 已入队
离线写入 104: 队列已满
网关重启后待发: 3
模拟确认丢失: 101
首次补传后待发: 3
恢复后待发: 0
云端顺序: [101, 102, 103]
运行结果说明四件事。首先,网关重新打开数据库后仍能读取 3 条未确认事件,证明它们不是只保存在进程内存中。其次,序号 101 已经写入云端,但确认丢失,因此它仍保留在本地队列。再次,第二轮补传成功清理了所有已确认事件。最后,云端对重复的 101 进行了幂等处理,没有生成第二条记录。
示例使用 TemporaryDirectory() 创建实验文件,脚本结束后会自动清理。临时目录的实际路径因操作系统而异。正式部署时应改用持久化数据目录,并保留数据库文件、WAL 文件及必要的存储空间。示例的 3 条限制是记录数限制,不等于真实磁盘容量限制。
保证补传顺序和重复投递安全
落盘队列通常提供的是至少一次投递语义,而不是天然的端到端恰好一次交付。只要云端已经提交数据、网关尚未收到确认,网关重试时就可能再次发送同一事件。
因此,平台接收端必须根据不可变的事件标识进行去重。示例中的 PRIMARY KEY (device, seq) 就是这个约束:对设备 M01 而言,序号 101 无论提交几次,云端最终都只保留一条对应记录。
生产实现应遵守以下具体规则:
- 同一设备按
seq升序补传;如果多个设备共用队列,应使用设备维度的顺序游标,而不是把不同设备的序号解释成同一个全局顺序。 - 重试时保持原始事件标识、事件时间、质量标志和数值不变,不要重新生成时间戳或分配新的事件序号。
- 只有收到可验证的应用层确认,才能删除对应事件。超时、连接中断或确认丢失都不构成删除依据。
- 云端重复事件的标识相同但载荷不同,应识别为数据冲突并记录告警,而不是无条件忽略差异。
- 上传器应设置有限的批量大小和发送速率,例如每批 100 条、每秒最多 500 条,并在平台限流时降低补传速度。
示例使用 INSERT OR IGNORE 展示重复事件的基本去重行为。实际接收服务还应检查载荷一致性,并在数据库事务成功提交后返回确认。多个设备并发发送时,需要明确各自的顺序范围和确认边界。
按断网窗口计算容量上限
持久化队列只能解决有限时间内的断网问题。如果平台连续数小时不可用,而网关持续采样,队列一定会不断增长。容量规划必须从采集频率、每条事件的实际磁盘占用和要求覆盖的断网时长开始。
假设网关连接 100 个测点,每个测点每秒产生 1 条事件,编码后的平均事件大小为 200 字节,要求覆盖最长 6 小时断网。
| 计算项 | 数值 |
|---|---|
| 测点数 | 100 |
| 每点采集频率 | 1 Hz |
| 每秒事件数 | 100 条 |
| 单条估算大小 | 200 B |
| 每秒原始数据量 | 20 KB |
| 6 小时事件数 | 2,160,000 条 |
| 6 小时原始数据量 | 432 MB |
| 增加 30% 估算开销 | 约 562 MB |
200 B 是用于演算的假设,不代表 SQLite 中每条记录的真实磁盘占用。实际容量还受表索引、数据库页、WAL、事务频率及其他元数据影响。应使用真实采集样本压测后重新测量。
在这个算例中,可以为队列分配独立的 1 GiB 存储预算,并制定以下运行阈值:
- 达到 70%:发送容量预警,检查断网持续时间和待补传条数。
- 达到 90%:发送严重告警,对允许降采样的低优先级测点执行限流或聚合。
- 达到硬上限:拒绝继续写入超额事件,记录明确的溢出计数和丢失范围,禁止静默覆盖关键事件。
这些百分比是项目策略示例,不是 SQLite 自动提供的阈值。实际硬限制需要结合独立分区、文件系统配额或存储服务的容量控制实施,并预留数据库事务及 WAL 继续写入所需空间。只限制队列行数无法保证数据库文件大小绝不增长。
用故障注入验证恢复路径
完成代码运行后,还需要验证不同故障位置对应的恢复行为。最有价值的测试并非只断开网络,而是故意让故障出现在本地提交、云端提交和确认返回之间。
| 测试场景 | 操作方式 | 验收条件 |
|---|---|---|
| 网络断开 | 停止上传,连续写入 3 条事件 | 本地未确认数为 3,云端尚无新增记录 |
| 网关重启 | 关闭并重新打开队列数据库 | 已提交事件仍能按原序号读取 |
| 确认丢失 | 云端提交序号 101 后不返回确认 | 本地仍保留 101,重传后云端只有一条 101 |
| 容量耗尽 | 在上限为 3 时写入第 4 条 | 写入被拒绝,不覆盖原有 3 条 |
| 网络恢复 | 再次执行补传并接收全部确认 | 队列未确认数为 0,云端事件数为 3 |
示例通过关闭数据库连接模拟进程重启,并不能替代真实断电实验。上线前还应分别在本地事务提交前后、云端提交前后中断进程,检查恢复结果;特别要确认突然断电后已提交数据的保留情况以及数据库能否正常重新打开。
建议网关持续采集并上报 pending_count、oldest_event_age_seconds、disk_usage_bytes、retry_count、overflow_count 和 last_ack_seq 等运行指标。这些名称是建议的业务监控字段,并非 SQLite 内置字段。事件积压量、最老事件年龄和已确认序号应与业务数据分开监控。
生产验收至少要达到:已确认事件不再重复占用队列、未确认事件重启后可恢复、重复发送不会产生重复业务记录、达到容量上限时触发明确的保护动作。这样才能将短时断网从不可控的数据丢失,转化为可计算、可补传、可审计的积压过程。