
智能制造与工业软件 / 系统课时
将阈值和状态变化转成告警事件
将阈值和状态变化转成告警事件
只保存温度曲线和设备运行位,值班人员仍要持续盯屏。本课用一秒采样的产线设备演示:把连续超温和生产中意外停机转换为有唯一身份的告警事件,处理重复消息与恢复条件,并明确平台告警不能替代现场安全联锁。
学习目标
- 为阈值越限和状态异常设置触发持续时间、回差与恢复持续时间。
- 用可运行判定器产出
OPEN和CLEAR事件,并验证事件时间与去重身份。 - 区分监测告警、人工确认和 PLC/SIS 安全联锁。
把业务条件写成明确规则
假设资产为 f01/l02/m01,每秒取得一次温度 temp_c、运行位 running 和生产任务位 production,且质量标志为 GOOD。只有处于生产任务中的停机才按异常处理;检修时的计划停机不告警。
| 规则 ID | 触发条件 | 恢复条件 | 业务级别 |
|---|---|---|---|
temp_high |
温度 ≥85°C 连续 10 秒 | 温度 ≤80°C 连续 5 秒 | P2 |
unexpected_stop |
production=true 且 running=false 连续 3 秒 |
running=true 连续 2 秒 |
P1 |
这些值是教学场景参数,现场设定必须依据设备限值、采样误差与工艺要求审核。超温采用 5°C 回差:告警发出后,即使温度降到 82°C,也不能立即恢复。生产任务取消后是否关闭停机告警属于业务决策,本例要求设备重新运行才恢复。
用四个状态避免抖动和误恢复
规则从正常进入触发待确认,条件一直成立到持续时间届满才发 OPEN 并进入活动告警。恢复条件开始满足时进入恢复待确认,满足恢复持续时间才发 CLEAR 并回到正常;任一待确认阶段条件中断,计时从头开始。
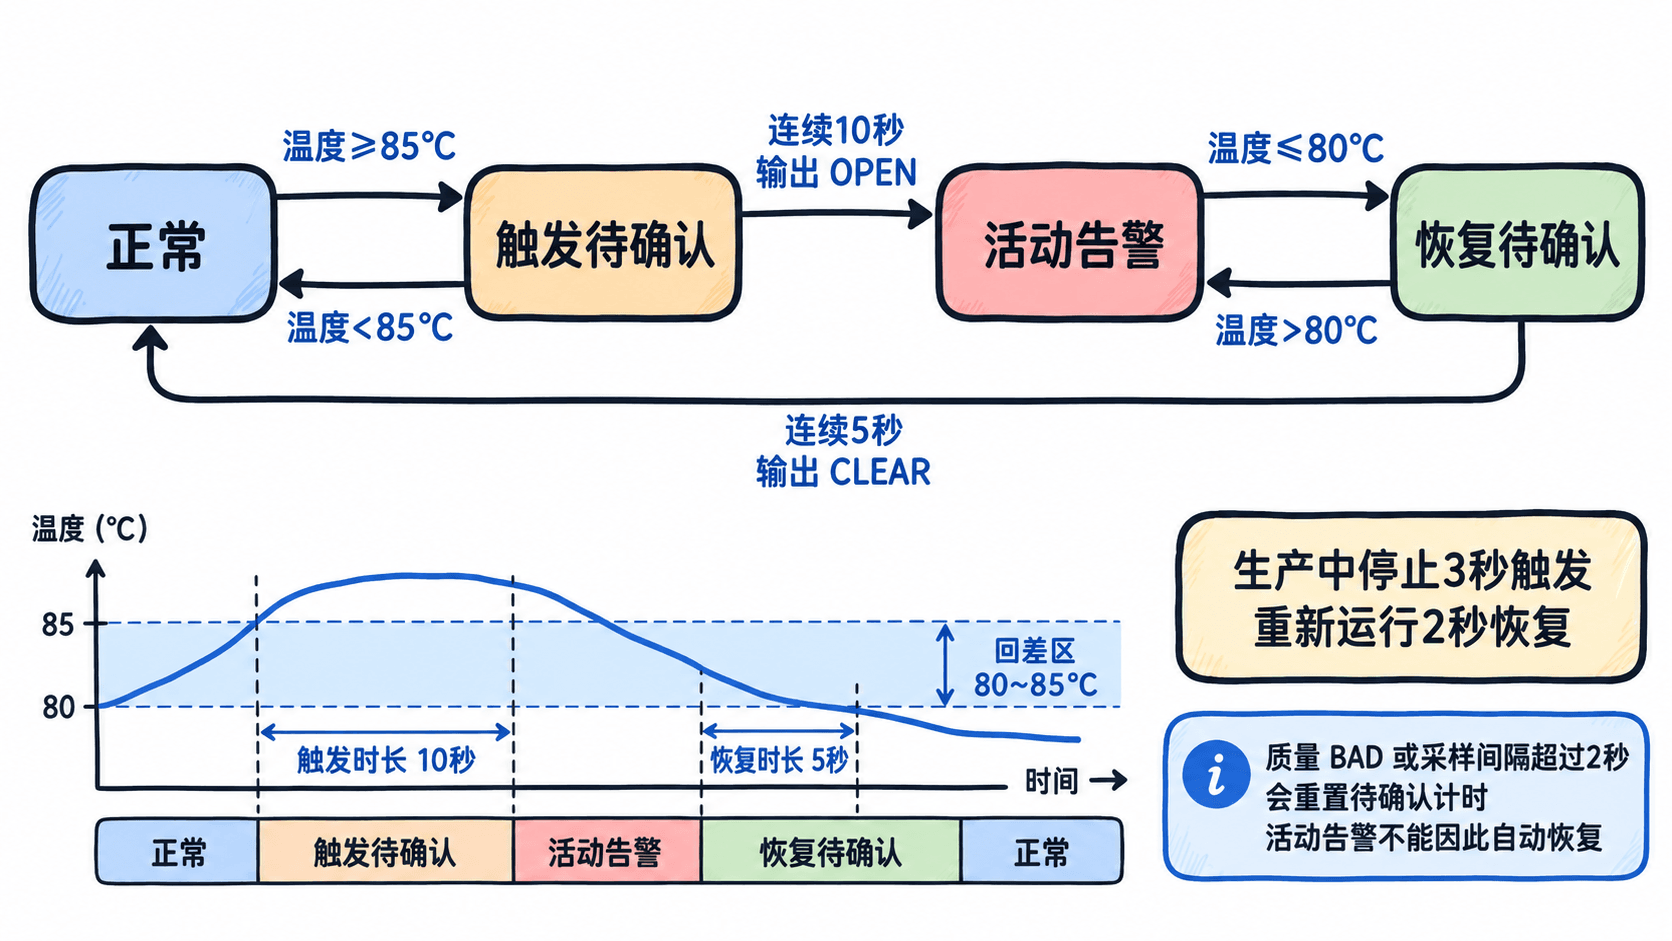
计时应依据有效样本的事件时间,而不是消息抵达云端的时间。若质量不是 GOOD 或相邻样本间隔超过 2 秒,本例清零待确认计时,但绝不因数据缺失自动关闭活动告警;数据中断应由单独的通信或质量规则报告。
运行两条告警判定规则
下面使用 Python 3 标准库,无第三方依赖。episode_id 由资产、规则和首次异常秒数组成,同一轮告警的 OPEN 与 CLEAR 共用这个 ID。示例输入按事件时间递增;实际接入时要先按设备序列号去重,并处理乱序数据。
from dataclasses import dataclass

@dataclass
class Sample:
    t: int
    temp_c: float
    running: bool
    production: bool = True
    quality: str = "GOOD"

class AlarmRule:
    def __init__(self, code, trigger, recover, on_seconds, off_seconds):
        self.code = code
        self.trigger = trigger
        self.recover = recover
        self.on_seconds = on_seconds
        self.off_seconds = off_seconds
        self.active = False
        self.raise_since = None
        self.clear_since = None
        self.episode_id = None
        self.last_t = None

    def feed(self, s):
        if self.last_t is not None and s.t <= self.last_t:
            raise ValueError("时间戳必须递增")
        gap = self.last_t is not None and s.t - self.last_t > 2
        self.last_t = s.t
        # 无效质量或过大的采样空档不能累计持续时间。
        if s.quality != "GOOD" or gap:
            self.raise_since = None
            self.clear_since = None
            return None

        if not self.active:
            if self.trigger(s):
                if self.raise_since is None:
                    self.raise_since = s.t
                if s.t - self.raise_since >= self.on_seconds:
                    self.active = True
                    # OPEN 与 CLEAR 共享本轮告警的稳定 ID。
                    self.episode_id = f"f01/l02/m01:{self.code}:{self.raise_since}"
                    self.raise_since = None
                    return "OPEN"
            else:
                self.raise_since = None
        else:
            if self.recover(s):
                if self.clear_since is None:
                    self.clear_since = s.t
                if s.t - self.clear_since >= self.off_seconds:
                    self.active = False
                    self.clear_since = None
                    return "CLEAR"
            else:
                self.clear_since = None
        return None

rules = [
    AlarmRule("temp_high", lambda s: s.temp_c >= 85,
              lambda s: s.temp_c <= 80, 10, 5),
    AlarmRule("unexpected_stop", lambda s: s.production and not s.running,
              lambda s: s.running, 3, 2),
]
# 每秒一帧:2~17 秒超温,5~16 秒意外停机。
for t in range(30):
    sample = Sample(t, 90 if 2 <= t <= 17 else 76,
                    not (5 <= t <= 16))
    for rule in rules:
        event = rule.feed(sample)
        if event:
            print(f"{t}s {event} {rule.episode_id}")
预期输出:
8s OPEN f01/l02/m01:unexpected_stop:5
12s OPEN f01/l02/m01:temp_high:2
19s CLEAR f01/l02/m01:unexpected_stop:5
23s CLEAR f01/l02/m01:temp_high:2
例如温度从第 2 秒开始超限,第 12 秒才满足连续 10 秒;第 18 秒降至 76°C,第 23 秒才恢复。输出中的秒数是模拟时间,正式事件须使用带时区约定的真实时间戳。
去重入库并保留告警生命周期
每条事件至少存储 asset_id、point_id、rule_id、rule_version、episode_id、event_type、event_time、first_seen_time、value、quality 和 severity。event_time 是确认触发或恢复的时刻;first_seen_time 保留异常首次出现时刻,便于追查持续时间。
在事件表上为 (episode_id, event_type) 设置唯一约束:消息重投时,同一轮告警的第二条 OPEN 不会生成第二个工单,但后续 CLEAR 仍可入库。查询当前活动告警时,以每个 episode_id 是否存在有效 CLEAR 为准。判定器还要持久化活动状态、待确认起点和最近样本时间,避免服务重启后重复开单。
人工 ACK 仅表示有人知悉,应另存确认人和确认时间;它不等于 CLEAR,也不能改写测点的真实恢复时间。
验收异常输入与安全边界
手工修改模拟时间线并检查:温度短暂冲到 86°C 但不足 10 秒时没有 OPEN;活动告警只降到 82°C 时没有 CLEAR;插入质量为 BAD 的样本或超过 2 秒的采样空档,不得靠缺失数据关闭告警。对 running=false 还应核对当时 production 是否为真,防止计划停机误报。
合格的事件链应能够重建每轮告警的首次异常、确认触发、人工确认和条件恢复四种不同时间与含义,且补传消息不会制造重复告警。