
智能制造与工业软件 / 系统课时
选择时序字段、分区与保留期限
选择时序字段、分区与保留期限
同一台设备持续上报温度后,既要能按事件发生时间查询曲线,也要避免原始记录无限增长。下面以 PostgreSQL 16 为例,设计时间列、测点键、按日分区和分钟聚合,并算出可检查的保留容量。
学习目标
- 区分事件发生、网关接收和平台入库时间,选定查询与分区口径。
- 建立可运行的原始时序表、分区与索引,并验证设备测点查询。
- 计算原始数据与分钟聚合的占用量,安排迟到数据和过期分区的处理。
先确定三种时间和一条记录的身份
| 字段 | 含义 | 具体用途 |
|---|---|---|
event_time |
设备测量发生的时间 | 曲线横轴、时间范围查询、分区键 |
gateway_received_at |
网关收到该测点的时间 | 定位现场传输延迟与设备时钟偏差 |
ingested_at |
数据库接纳记录的时间 | 追踪积压补传和平台写入延迟 |
device_id、point_key |
设备和测点的稳定标识 | 过滤 Machine01 的 temperature |
sample_seq、quality |
样本序号和质量标志 | 重传去重、排除异常值参与均值 |
三种时间均使用 timestamptz,接入时传入带偏移的时间,示例统一使用 UTC。假设设备在 00:00:05 测温,网关在 00:00:06 收到,断网后直到 00:10:00 才写入:历史曲线仍应落在 00:00:05,不能用入库时间替换。设备时钟明显漂移或缺少可信时间时,应先隔离并标注时间质量,不能悄悄修正原始事件时间。
用事件时间建立日分区和查询索引
以下 SQL 可在空白的 PostgreSQL 16 数据库执行。主键包含分区键 event_time,满足 PostgreSQL 分区表的唯一约束要求;sample_seq 由同一设备测点的采集端提供。
CREATE TABLE telemetry_raw (
  event_time timestamptz NOT NULL,
  gateway_received_at timestamptz NOT NULL,
  ingested_at timestamptz NOT NULL DEFAULT now(),
  device_id text NOT NULL,
  point_key text NOT NULL,
  sample_seq bigint NOT NULL,
  value_num double precision NOT NULL,
  quality text NOT NULL CHECK (quality IN ('GOOD', 'UNCERTAIN', 'BAD')),
  PRIMARY KEY (event_time, device_id, point_key, sample_seq)
) PARTITION BY RANGE (event_time);

-- 每个 UTC 自然日一个分区,右边界不包含在内
CREATE TABLE telemetry_raw_20261012 PARTITION OF telemetry_raw
FOR VALUES FROM ('2026-10-12 00:00:00+00')
           TO ('2026-10-13 00:00:00+00');

CREATE INDEX telemetry_raw_lookup_idx
ON telemetry_raw (device_id, point_key, event_time DESC);

-- 相同事件时间和序号的重传不会重复入库
INSERT INTO telemetry_raw
(event_time, gateway_received_at, device_id, point_key, sample_seq, value_num, quality)
VALUES
('2026-10-12 00:00:05+00','2026-10-12 00:00:06+00','Machine01','temperature',1,23.5,'GOOD'),
('2026-10-12 00:00:45+00','2026-10-12 00:00:46+00','Machine01','temperature',2,24.5,'GOOD'),
('2026-10-12 00:01:05+00','2026-10-12 00:01:06+00','Machine01','temperature',3,23.8,'GOOD'),
('2026-10-12 00:01:15+00','2026-10-12 00:01:16+00','Machine01','temperature',4,99.0,'BAD')
ON CONFLICT (event_time, device_id, point_key, sample_seq) DO NOTHING;

SELECT count(*) AS good_n,
       round(avg(value_num)::numeric, 2) AS mean_c
FROM telemetry_raw
WHERE device_id = 'Machine01'
  AND point_key = 'temperature'
  AND quality = 'GOOD'
  AND event_time >= '2026-10-12 00:00:00+00'
  AND event_time <  '2026-10-13 00:00:00+00';
预期输出(只展示最后的查询结果):
 good_n | mean_c
--------+--------
      3 |  23.93
(1 row)
时间范围使用左闭右开,便于连续时间窗无重叠。查询同时约束 event_time 和设备、测点,前者让数据库裁剪无关日期的分区,后者利用复合索引。分区必须提前创建;收到落在未创建日期分区的迟到记录时,插入会报错,接入层应按保留边界补建合法分区或将过期事件转入隔离队列。
将原始样本汇总成分钟记录
长期趋势无需逐个保留每五秒的测量值。聚合表按 bucket_start 分区,保存总样本数、有效样本数和有效值总和;再次汇总时使用总和除以计数,不要直接平均各分钟的均值。
下面是依赖上一段 telemetry_raw 表及四条测试数据的片段示例。在同一个数据库继续执行:
CREATE TABLE telemetry_1m (
  bucket_start timestamptz NOT NULL,
  device_id text NOT NULL,
  point_key text NOT NULL,
  total_count bigint NOT NULL,
  good_count bigint NOT NULL,
  sum_good double precision NOT NULL,
  PRIMARY KEY (bucket_start, device_id, point_key)
) PARTITION BY RANGE (bucket_start);

CREATE TABLE telemetry_1m_202610 PARTITION OF telemetry_1m
FOR VALUES FROM ('2026-10-01 00:00:00+00')
           TO ('2026-11-01 00:00:00+00');

-- 重新计算窗口并覆盖聚合,避免补传时重复累加
INSERT INTO telemetry_1m
(bucket_start, device_id, point_key, total_count, good_count, sum_good)
SELECT date_bin('1 minute', event_time, TIMESTAMPTZ '2000-01-01 00:00:00+00'),
       device_id, point_key, count(*),
       count(*) FILTER (WHERE quality = 'GOOD'),
       coalesce(sum(value_num) FILTER (WHERE quality = 'GOOD'), 0)
FROM telemetry_raw
WHERE event_time >= '2026-10-12 00:00:00+00'
  AND event_time <  '2026-10-13 00:00:00+00'
GROUP BY 1, 2, 3
ON CONFLICT (bucket_start, device_id, point_key)
DO UPDATE SET total_count = EXCLUDED.total_count,
              good_count = EXCLUDED.good_count,
              sum_good = EXCLUDED.sum_good;

SELECT to_char(bucket_start AT TIME ZONE 'UTC', 'HH24:MI') AS minute_utc,
       total_count, good_count,
       round((sum_good / nullif(good_count, 0))::numeric, 2) AS mean_c
FROM telemetry_1m
ORDER BY bucket_start;
预期输出:
 minute_utc | total_count | good_count | mean_c
------------+-------------+------------+-------
 00:00      |           2 |          2 | 24.00
 00:01      |           2 |          1 | 23.80
(2 rows)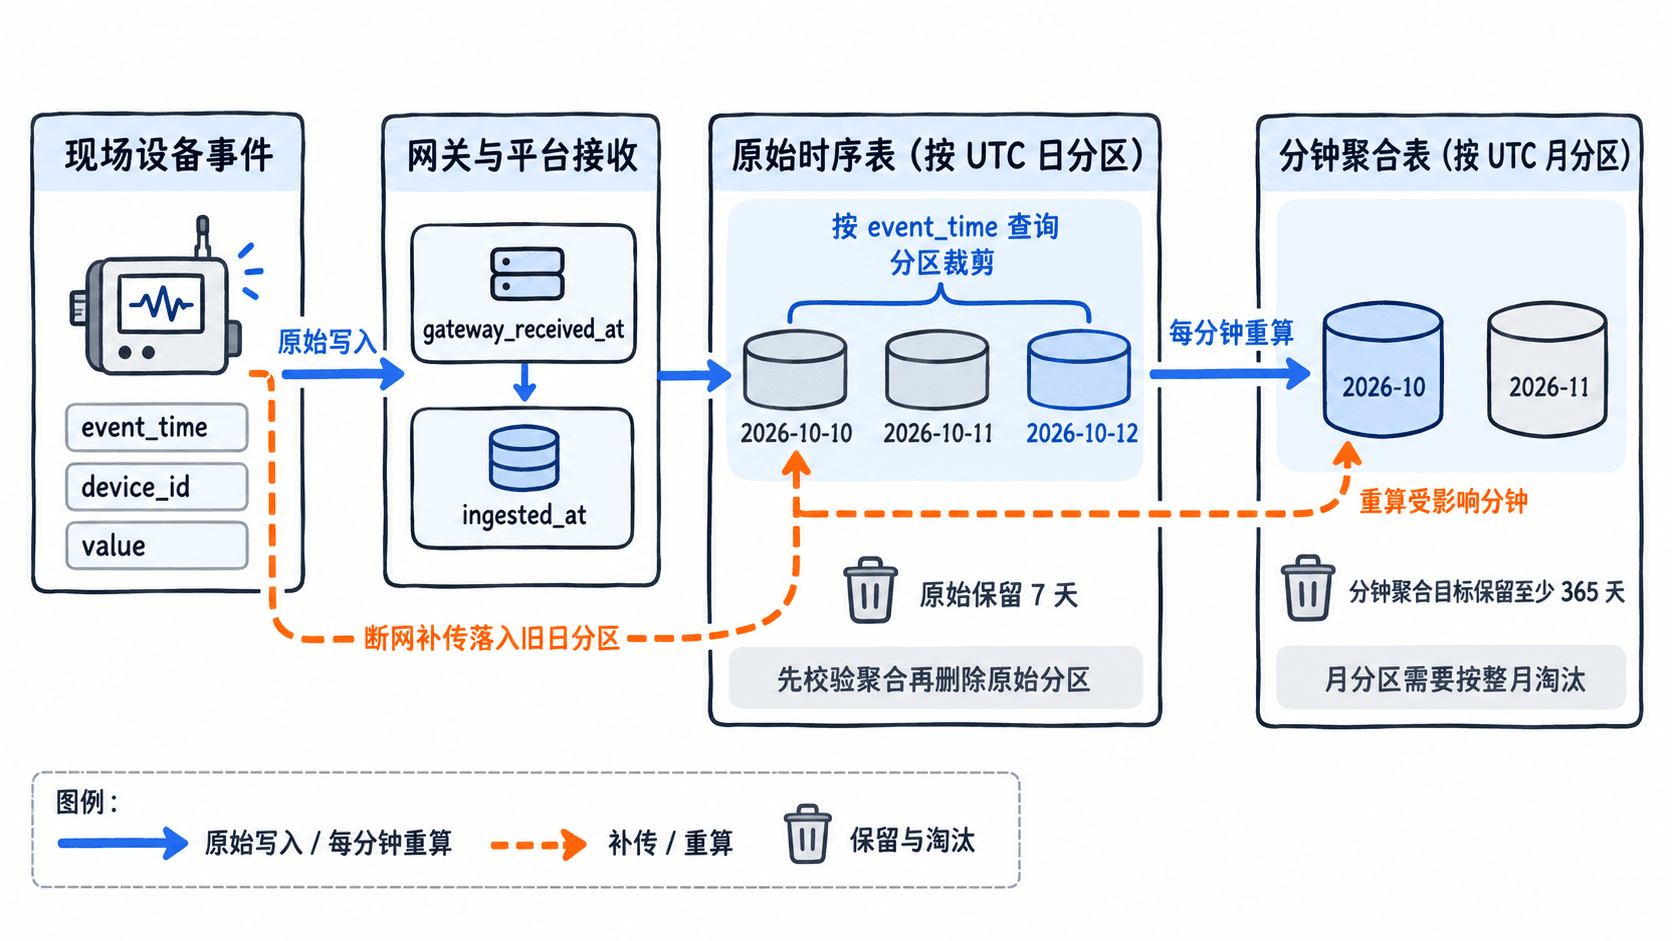
分钟聚合可以按月分区,减少长期保留时的分区数量。但整月删除无法精确实现滚动 365 天的保留边界:若规定至少保留 365 天,实际还会额外保存不足一个月的数据。若法规要求精确按日删除,应改用日分区或配套行级清理策略。
用采样规模反推保留期限
以 100 台设备、每台 10 个测点、每 5 秒一条原始记录为例,共 1000 条测点序列。假设原始行连同索引均摊 120 B、分钟聚合行连同索引均摊 160 B;这些是预算假设,不含 WAL、备份、副本和空间碎片,投产后应以实际分区的物理大小校准。
| 数据层 | 每日记录数 | 日容量估算 | 保留目标 | 对应容量估算 |
|---|---|---|---|---|
| 原始数据,每 5 秒一条 | 17,280,000 | 2.07 GB | 7 天 | 14.52 GB |
| 每分钟一条聚合 | 1,440,000 | 0.23 GB | 至少 365 天 | 84.10 GB(按 365 天计算) |
计算依据为每天 86,400 秒,按十进制 GB 计。若将原始数据也留 365 天,仅按同样行宽估算就约 756.86 GB。上述两层的 365 天基准合计约 98.6 GB;若分钟聚合因月分区边界多保留约 31 天,还需约 7.14 GB。实际预算还要预留维护、备份及索引增长空间。
分钟聚合不能恢复秒级尖峰,故故障回放所需的原始保留期应由排障时效和合规要求决定。真实数据库的分区占用量可以使用 PostgreSQL 的 pg_total_relation_size 函数测量,它会计入指定分区的表、索引和 TOAST 存储。
当 UTC 时间到达 2026-10-20 00:00,且确认 10 月 12 日的数据已完整聚合、补传宽限已结束,可在维护窗口执行以下清理命令。此片段示例依赖前面创建的原始日分区;它会删除当天整个分区,不能恢复其中单条记录。
DROP TABLE telemetry_raw_20261012;预期输出:
DROP TABLE生产中应先滚动创建未来分区、校验原始与聚合的行数和时间范围,再删除过期分区;删除可能短暂持有强锁,需避开写入高峰。若最大补传延迟可能达到 48 小时,7 天原始保留期内必须为迟到数据保留重算窗口;超过已删除分区的旧事件应走明确的拒收或归档策略,而不是改写为当前时间入库。