
Go / 系统课时
按分隔符完成拆包
按分隔符完成拆包
TCP 只提供连续字节流,不会替应用保存“消息边界”。本节用换行符作为协议分隔符,通过缓冲读取把任意大小的网络片段重新拼成完整消息,并同时处理缺失分隔符和超长输入,避免粘包、半包与无界内存增长。
学习目标
- 理解为什么一次
Read不能直接当成一条完整消息。 - 使用
bufio.Reader按分隔符稳定拆出文本消息。 - 为超长消息和 EOF 前残缺消息建立明确的拒绝规则。
为什么一次 Read 不能等于一条消息
发送端连续写入 HELLO\nWORLD\n 时,接收端可能一次读到两条消息,也可能先读到 HEL,下一次才拿到剩余字节。TCP 保证字节顺序,不保证每次读写调用一一对应,因此业务层必须自己定义并恢复边界。
按分隔符协议的核心是保留未完成数据:持续把字节放进缓冲区,找到 \n 后只取出分隔符之前的内容作为一条消息,分隔符之后的字节继续留给下一次拆包。
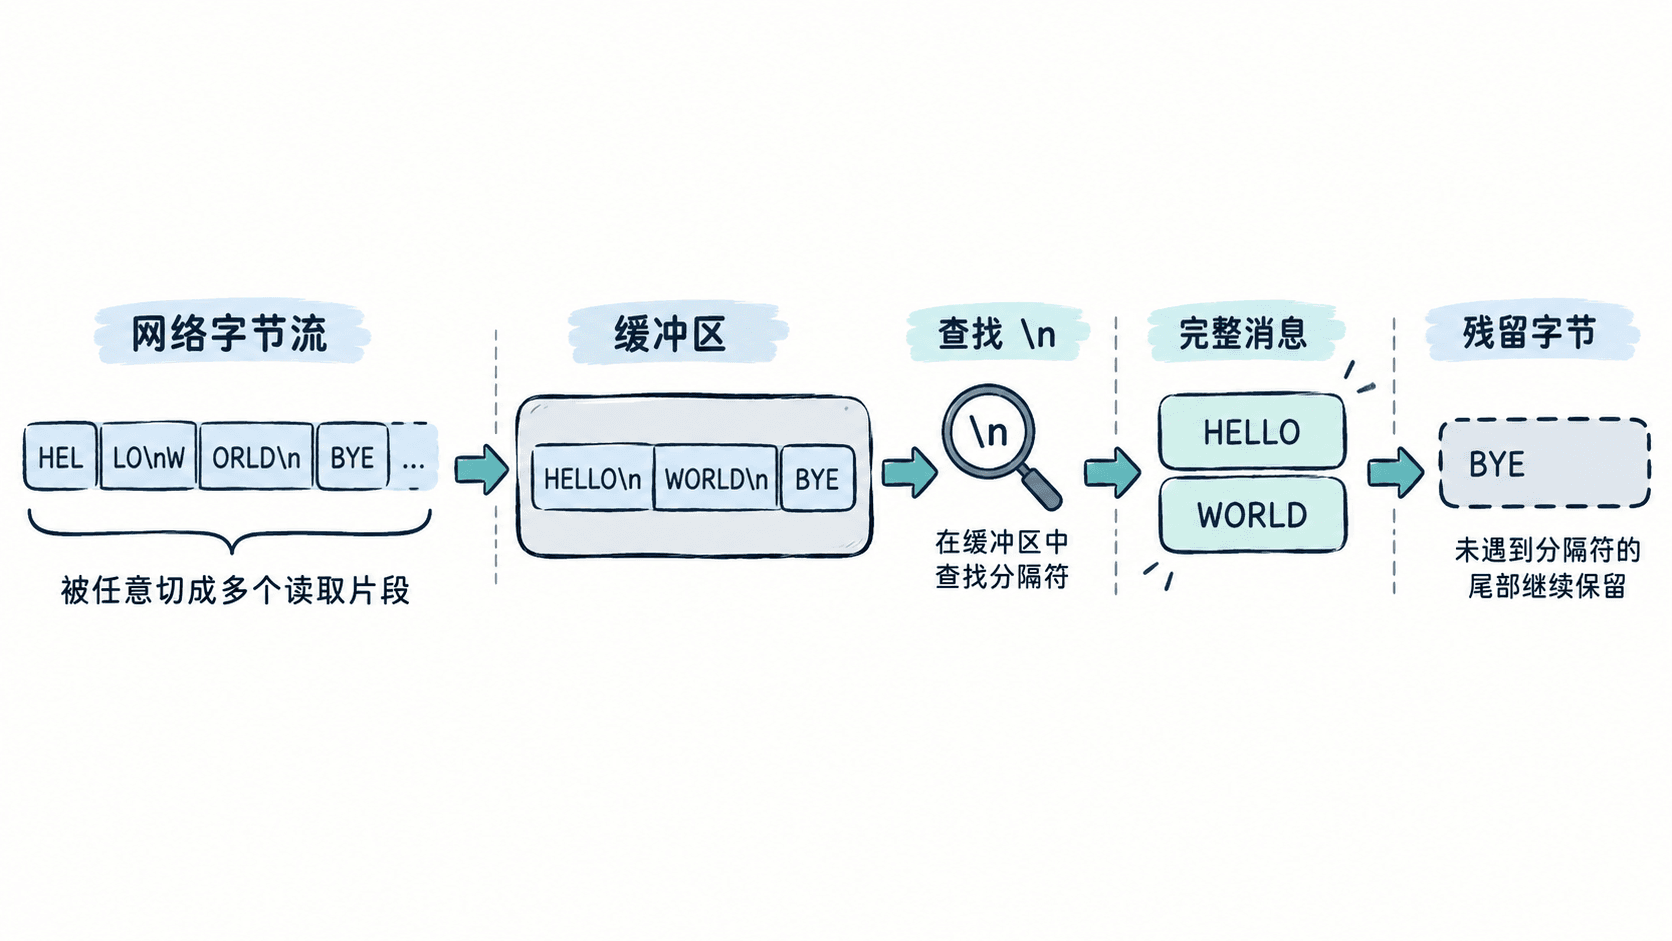
这意味着“拆包”发生在应用协议层,而不是调用更多次 Read 就自然解决。只要协议双方约定同一个分隔符,读取逻辑就应该围绕“是否已经找到完整分隔符”做判断。
用缓冲读取实现严格分隔符协议
下面的程序使用 ReadSlice 查找换行符。bufio.ErrBufferFull 表示当前缓冲区还没找到分隔符,需要继续累计;正常 EOF 且缓冲区为空表示流结束;EOF 前仍有残留字节则判为不完整消息。示例还限制单条消息最多 24 字节,防止对端一直不发送分隔符导致内存持续增长。
package main

import (
	"bufio"
	"errors"
	"fmt"
	"io"
	"strings"
)

var (
	errFrameTooLarge = errors.New("frame too large")
	errIncomplete    = errors.New("incomplete frame")
)

func readFrame(r *bufio.Reader, delim byte, maxPayload int) ([]byte, error) {
	frame := make([]byte, 0, maxPayload)

	for {
		part, err := r.ReadSlice(delim)

		// 分隔符不计入业务消息长度;没有分隔符时,收到的全是负载。
		payloadBytes := len(frame) + len(part)
		if err == nil && len(part) > 0 && part[len(part)-1] == delim {
			payloadBytes--
		}
		if payloadBytes > maxPayload {
			return nil, errFrameTooLarge
		}

		frame = append(frame, part...)

		switch {
		case err == nil:
			return frame[:len(frame)-1], nil
		case errors.Is(err, bufio.ErrBufferFull):
			continue
		case errors.Is(err, io.EOF):
			if len(frame) == 0 {
				return nil, io.EOF
			}
			return nil, errIncomplete
		default:
			return nil, err
		}
	}
}

func consume(name, input string) {
	r := bufio.NewReaderSize(strings.NewReader(input), 16)

	for {
		msg, err := readFrame(r, '\n', 24)
		if err == nil {
			fmt.Printf("%s message=%q\n", name, msg)
			continue
		}

		switch {
		case errors.Is(err, io.EOF):
			fmt.Printf("%s done\n", name)
		case errors.Is(err, errFrameTooLarge):
			fmt.Printf("%s rejected: too large\n", name)
		case errors.Is(err, errIncomplete):
			fmt.Printf("%s rejected: missing delimiter\n", name)
		default:
			fmt.Printf("%s rejected: %v\n", name, err)
		}
		return
	}
}

func main() {
	consume("ok", "ABCDEFGHIJKLMNOPQRST\nWORLD\n")
	consume("oversize", "1234567890123456789012345\n")
	consume("incomplete", "TAIL")
}
预期输出
ok message="ABCDEFGHIJKLMNOPQRST"
ok message="WORLD"
ok done
oversize rejected: too large
incomplete rejected: missing delimiter
示例中的缓冲区大小不等于消息上限。缓冲区可以较小并多次填充,而 maxPayload 才是协议允许的单条消息长度;两者分开,才能既控制内存,又允许消息跨越多个底层读取片段。
异常输入要在协议层定规则
缺失分隔符不能简单当成一条有效尾消息,否则同一份字节流在“连接仍存活”和“连接已经结束”两种时机会得到不同语义。若协议规定每条消息必须以换行结束,那么 EOF 前的残留数据就应视为协议错误。
超长消息也应尽早拒绝。生产服务通常在读循环中设置单帧上限,并在触发上限后记录原因、终止当前连接或进入协议约定的错误处理流程,而不是继续无界累积。
什么时候适合分隔符协议
分隔符协议适合日志流、命令行式协议和简单文本消息:消息本身易读,边界规则直观,抓包时也容易定位。选择分隔符前要确保正文能转义该字符,或明确规定正文不能出现它。
如果消息是任意二进制数据、正文频繁包含分隔符,或者需要高效传输大块内容,长度前缀通常更合适。关键不是“多读几次”,而是让接收端始终能根据协议规则唯一判断一条消息何时结束。