
Go / 系统课时
加入日志指标与性能采样
加入日志指标与性能采样
网络服务能正常响应还不够,部署后必须能回答“谁在请求、服务是否过载、CPU 或内存耗在哪里”。本节在同一个 Go 服务中接入结构化请求日志、运行指标和 pprof,并把诊断入口与业务端口隔离,形成最小可用的可观测能力。
学习目标
- 为 HTTP 请求记录方法、路径、状态码和耗时,并控制日志字段的一致性。
- 暴露请求量、并发量、错误量和耗时累计指标,知道如何验证指标是否变化。
- 在独立的本地诊断端口启用 pprof,并用标准工具确认采样入口可用。
把三类信号分开
请求日志适合回答“某一次请求发生了什么”,指标适合观察一段时间内的趋势,pprof 则用于解释 CPU、内存、阻塞等性能问题。三者用途不同,不应把高频指标塞进日志,也不应长期靠 pprof 代替监控。
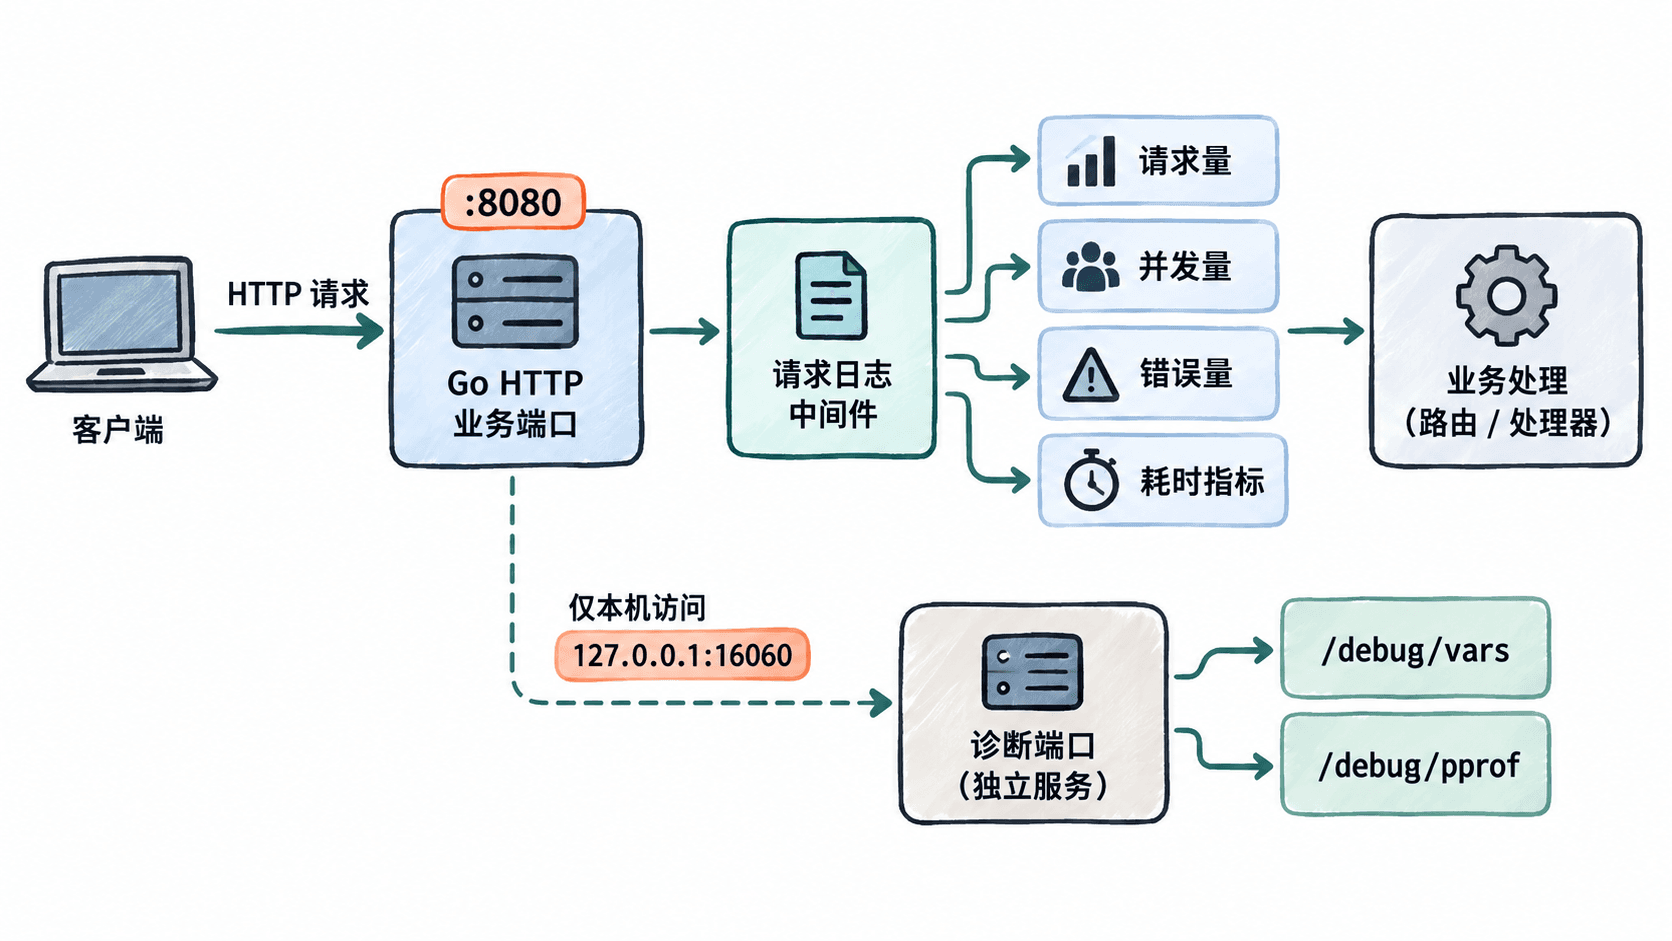
一个可部署的最小方案可以把业务端口绑定到 :18080,把诊断端口只绑定到 127.0.0.1:16060。这样线上反向代理只暴露业务端口,运维人员再通过主机、容器或受控隧道访问诊断端口。
接入结构化日志和指标
下面的完整程序只使用标准库。业务请求走自建 ServeMux;expvar 与 net/http/pprof 注册到默认 ServeMux,因此可以由另一个本地监听端口单独承载。
package main

import (
    "expvar"
    "fmt"
    "log/slog"
    "net/http"
    _ "net/http/pprof"
    "os"
    "time"
)

var (
    requestsTotal = expvar.NewInt("requests_total")
    inflight      = expvar.NewInt("inflight_requests")
    serverErrors  = expvar.NewInt("server_errors_total")
    latencyTotal  = expvar.NewInt("latency_ms_total")
)

type statusRecorder struct {
    http.ResponseWriter
    status int
}

func (w *statusRecorder) WriteHeader(code int) {
    w.status = code
    w.ResponseWriter.WriteHeader(code)
}

func accessLog(logger *slog.Logger, next http.Handler) http.Handler {
    return http.HandlerFunc(func(w http.ResponseWriter, r *http.Request) {
        start := time.Now()
        requestsTotal.Add(1)
        inflight.Add(1)
        defer inflight.Add(-1)

        rec := &statusRecorder{ResponseWriter: w, status: http.StatusOK}
        next.ServeHTTP(rec, r)

        elapsed := time.Since(start)
        latencyTotal.Add(elapsed.Milliseconds())
        if rec.status >= 500 {
            serverErrors.Add(1)
        }

        logger.Info("request",
            "method", r.Method,
            "path", r.URL.Path,
            "status", rec.status,
            "duration_ms", elapsed.Milliseconds(),
        )
    })
}

func main() {
    logger := slog.New(slog.NewJSONHandler(os.Stdout, nil))

    appMux := http.NewServeMux()
    appMux.HandleFunc("/hello", func(w http.ResponseWriter, r *http.Request) {
        fmt.Fprintln(w, "hello")
    })

    go func() {
        diag := &http.Server{
            Addr:              "127.0.0.1:16060",
            Handler:           http.DefaultServeMux,
            ReadHeaderTimeout: 5 * time.Second,
        }
        if err := diag.ListenAndServe(); err != nil && err != http.ErrServerClosed {
            logger.Error("diagnostics server stopped", "error", err)
        }
    }()

    server := &http.Server{
        Addr:              ":18080",
        Handler:           accessLog(logger, appMux),
        ReadHeaderTimeout: 5 * time.Second,
    }
    logger.Info("server started", "app", ":18080", "diagnostics", "127.0.0.1:16060")
    if err := server.ListenAndServe(); err != nil && err != http.ErrServerClosed {
        logger.Error("server stopped", "error", err)
        os.Exit(1)
    }
}
在第一个终端运行服务:
go run main.go预期输出
{"time":"<TIME>","level":"INFO","msg":"server started","app":":18080","diagnostics":"127.0.0.1:16060"}<TIME> 会随运行时间变化。随后在第二个终端发送一次业务请求:
curl -s http://127.0.0.1:18080/hello预期输出
hello第一个终端还会新增一条请求日志,其中 time 与 duration_ms 属于动态值:
{"time":"<TIME>","level":"INFO","msg":"request","method":"GET","path":"/hello","status":200,"duration_ms":<DURATION_MS>}验证指标是否随请求变化
expvar 会在 /debug/vars 暴露自定义变量,并附带 Go 运行时的 memstats 等信息。与其人工翻整份 JSON,更可靠的做法是只抽取本节关心的四个字段。
curl -s http://127.0.0.1:16060/debug/vars | python3 -c 'import json,sys; d=json.load(sys.stdin); print({k:d[k] for k in ["requests_total","inflight_requests","server_errors_total","latency_ms_total"]})'预期输出
{'requests_total': 1, 'inflight_requests': 0, 'server_errors_total': 0, 'latency_ms_total': <LATENCY_MS_TOTAL>}<LATENCY_MS_TOTAL> 取决于实际机器和请求耗时。继续请求 /hello 后,requests_total 应持续增加;请求结束后 inflight_requests 应回到 0。如果这些关系不成立,优先检查中间件是否包在真实业务 Handler 外层。
验证 pprof 入口
导入 net/http/pprof 后,标准 pprof 路由会注册到默认 ServeMux。先确认入口能访问,再在出现 CPU、内存或阻塞异常时采样,避免无目的地抓 profile。
curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:16060/debug/pprof/预期输出
200需要查看堆内存热点时,可以直接让 go tool pprof 拉取 profile:
go tool pprof -top http://127.0.0.1:16060/debug/pprof/heap预期结果
Fetching profile over HTTP from http://127.0.0.1:16060/debug/pprof/heap
Saved profile in <PATH>
...
<PATH> 和后续热点函数会随环境变化。生产环境不要把诊断端口 16060 直接暴露到公网;pprof 和运行指标可能泄露程序结构、命令行参数或运行状态,应放在内网、回环地址或经过认证的运维入口之后。
上线时保留可验证的最小集合
日志至少要有请求方法、路径、状态码和耗时,并避免记录令牌、密码、完整 Cookie 等敏感值。指标先保留请求量、并发量、服务端错误量和耗时,再根据真实故障增加队列、连接池或业务指标。pprof 则按需启用采样,不把采样结果当成长期时序监控。
这套组合的关键不是“接了三个工具”,而是形成证据闭环:日志定位单次请求,指标确认问题是否持续扩大,pprof 在性能异常时继续下钻到具体函数和资源占用。