
Go / 系统课时
演练端口与连接故障排查
演练端口与连接故障排查
网络故障最容易被一句“连不上”掩盖,但端口占用、连接拒绝、读写超时和连接暴增发生在完全不同的阶段。本节用一个可重复的本地实验复现四类现象,再按监听状态、TCP 建连、应用读写和连接数量逐层取证。
学习目标
- 根据错误发生阶段区分端口绑定失败、连接拒绝和应用层超时。
- 使用
ss、进程日志和最小探测程序建立排障证据链。 - 模拟连接暴增并判断是监听、握手、应用处理还是资源上限出现压力。
先按网络阶段定位
排障顺序应该从本机事实开始,而不是先猜防火墙或代码 bug。服务端先确认“目标端口是否监听、谁在监听”,客户端再确认“TCP 是否建立”,连接建立后才继续看“读写是否在截止时间内完成”。
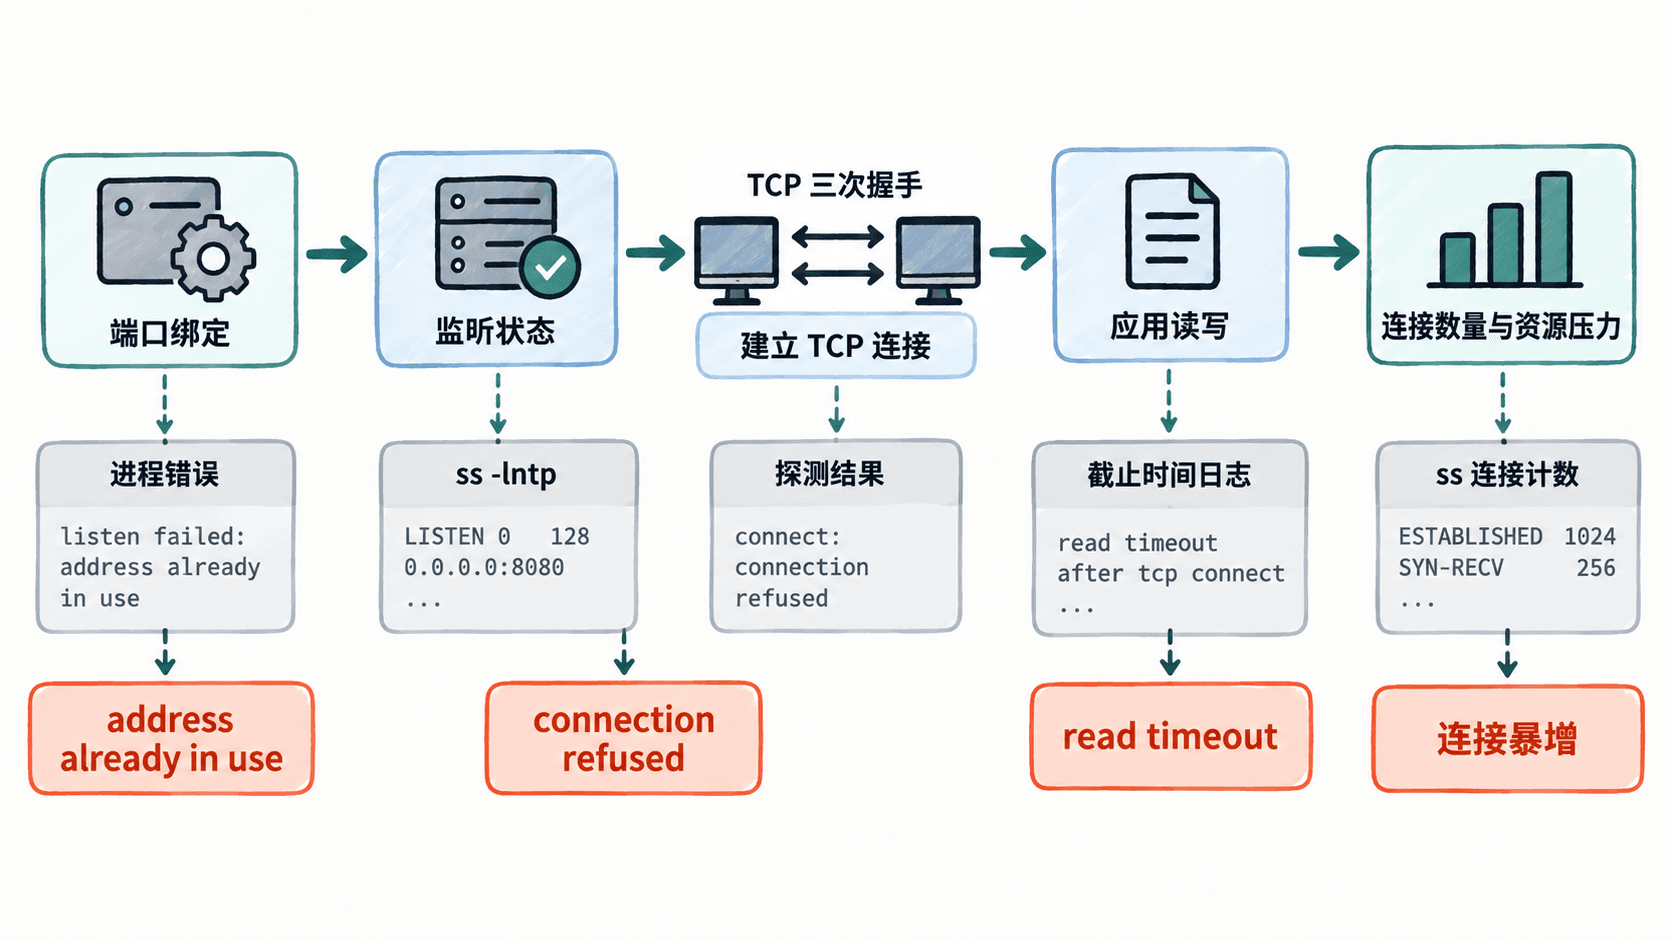
以下命令按 Linux 环境演练。这条顺序能避免常见误判:connection refused 说明目标主机已经明确拒绝这次连接,通常比“超时”更靠前;而读超时说明 TCP 往往已经建立,只是应用没有在截止时间前返回数据。
建一个可重复的故障实验
下面的程序提供三个模式:server 监听端口但故意不回复数据,probe 建连后等待响应并设置读超时,burst 一次建立多条连接并保持 10 秒。一个文件就能复现本节需要的关键现象。
package main

import (
    "fmt"
    "net"
    "os"
    "strconv"
    "time"
)

func runServer(addr string) {
    ln, err := net.Listen("tcp", addr)
    if err != nil {
        fmt.Fprintf(os.Stderr, "listen failed: %v\n", err)
        os.Exit(1)
    }
    defer ln.Close()
    fmt.Printf("listening on %s\n", addr)

    for {
        conn, err := ln.Accept()
        if err != nil {
            fmt.Fprintf(os.Stderr, "accept failed: %v\n", err)
            continue
        }
        go func(c net.Conn) {
            defer c.Close()
            time.Sleep(30 * time.Second)
        }(conn)
    }
}

func runProbe(addr string) {
    conn, err := net.DialTimeout("tcp", addr, 2*time.Second)
    if err != nil {
        fmt.Printf("connect failed: %v\n", err)
        return
    }
    defer conn.Close()

    // TCP 已建立后再验证应用层是否能在截止时间内返回数据。
    if err := conn.SetReadDeadline(time.Now().Add(2 * time.Second)); err != nil {
        fmt.Printf("set deadline failed: %v\n", err)
        return
    }
    if _, err := conn.Write([]byte("ping\n")); err != nil {
        fmt.Printf("write failed: %v\n", err)
        return
    }

    buf := make([]byte, 1)
    if _, err := conn.Read(buf); err != nil {
        if ne, ok := err.(net.Error); ok && ne.Timeout() {
            fmt.Println("read timeout after tcp connect")
            return
        }
        fmt.Printf("read failed: %v\n", err)
        return
    }
    fmt.Println("received application data")
}

func runBurst(addr string, n int) {
    conns := make([]net.Conn, 0, n)
    for i := 0; i < n; i++ {
        conn, err := net.DialTimeout("tcp", addr, 500*time.Millisecond)
        if err == nil {
            conns = append(conns, conn)
        }
    }
    fmt.Printf("opened=%d requested=%d; holding 10s\n", len(conns), n)
    time.Sleep(10 * time.Second)
    for _, conn := range conns {
        conn.Close()
    }
}

func main() {
    if len(os.Args) < 3 {
        fmt.Println("usage: go run netlab.go <server|probe|burst> <addr> [count]")
        os.Exit(2)
    }

    switch os.Args[1] {
    case "server":
        runServer(os.Args[2])
    case "probe":
        runProbe(os.Args[2])
    case "burst":
        count := 100
        if len(os.Args) >= 4 {
            v, err := strconv.Atoi(os.Args[3])
            if err != nil || v <= 0 {
                fmt.Println("count must be a positive integer")
                os.Exit(2)
            }
            count = v
        }
        runBurst(os.Args[2], count)
    default:
        fmt.Println("unknown mode:", os.Args[1])
        os.Exit(2)
    }
}
启动实验服务:
go run netlab.go server 127.0.0.1:19080预期输出
listening on 127.0.0.1:19080区分端口占用、拒绝和超时
保持第一个服务运行,再开一个终端重复监听同一地址:
go run netlab.go server 127.0.0.1:19080预期输出
listen failed: listen tcp 127.0.0.1:19080: bind: address already in use
exit status 1
这类错误发生在服务启动的绑定阶段。先查监听者,不要修改客户端重试参数:
ss -H -lntp 'sport = :19080'预期结果
LISTEN 0 <BACKLOG> 127.0.0.1:19080 0.0.0.0:* users:(("<PROCESS>",pid=<ID>,fd=<FD>))<BACKLOG>、<PROCESS>、<ID> 和 <FD> 会因环境不同而变化。确认进程身份后再决定停止旧进程、修改端口,或修正重复启动逻辑。
确认本机 19081 没有服务监听后,连接这个端口可以观察“连接被拒绝”:
go run netlab.go probe 127.0.0.1:19081预期输出
connect failed: dial tcp 127.0.0.1:19081: connect: connection refused而连接正在运行的 19080 时,TCP 能建立,但实验服务故意不返回应用数据,因此触发的是读超时:
go run netlab.go probe 127.0.0.1:19080预期输出
read timeout after tcp connect观察连接暴增
保持服务端运行,在另一个终端一次建立 200 条连接并保持 10 秒:
go run netlab.go burst 127.0.0.1:19080 200预期输出
opened=<OPENED> requested=200; holding 10s正常的本地实验里 <OPENED> 通常接近 200;如果明显偏小,说明连接建立阶段已经出现失败,需要同时观察客户端错误、监听队列和系统资源。保持这 10 秒窗口,在第三个终端查看连接:
ss -H -tan state established | grep ':19080'预期结果
0 0 127.0.0.1:<PORT> 127.0.0.1:19080
...
实际地址、端口和状态会随系统变化,该命令已经过滤为已建立连接,重点看与 19080 相关的行数是否骤增。线上遇到连接数突然增加时,还要继续核对文件描述符上限、监听队列、goroutine 数量、下游耗时和超时回收是否同步恶化。
用证据链收敛根因
端口占用看的是“谁已经绑定”;连接拒绝看的是“目标地址是否有可接受连接的监听者”;读写超时看的是“连接建立后哪一步没有在截止时间内完成”;连接暴增则要把连接状态与进程资源一起看。只要按这个顺序保留命令输出、错误类型和时间点,就能把模糊的“网络不通”收敛到具体阶段,再决定是改配置、修代码还是处理容量问题。