
Go / 系统课时
统计连接与请求指标
统计连接与请求指标
并发服务一旦只剩日志,就很难回答“现在有多少连接、请求是否变慢、错误是否在上升”。本节用 Go 标准库给 TCP 服务补上最小指标面,覆盖连接数、请求量、错误率、延迟和活跃任务,并给出可直接验证的方法。
学习目标
- 区分 Gauge、Counter 和延迟观测值,知道每类指标该在什么事件上更新。
- 在连接生命周期和请求处理路径中正确埋点,避免重复计数或漏减。
- 通过指标端点验证请求量、错误率、延迟与活跃任务是否符合预期。
把指标放到正确的生命周期
连接数和活跃任务是“当前状态”,适合用 Gauge 思维:连接建立时加一、关闭时减一;任务开始时加一、结束时减一。请求量和错误量只增不减,适合 Counter。延迟则需要对每次请求的耗时做观测,生产环境通常使用直方图或分位数聚合。
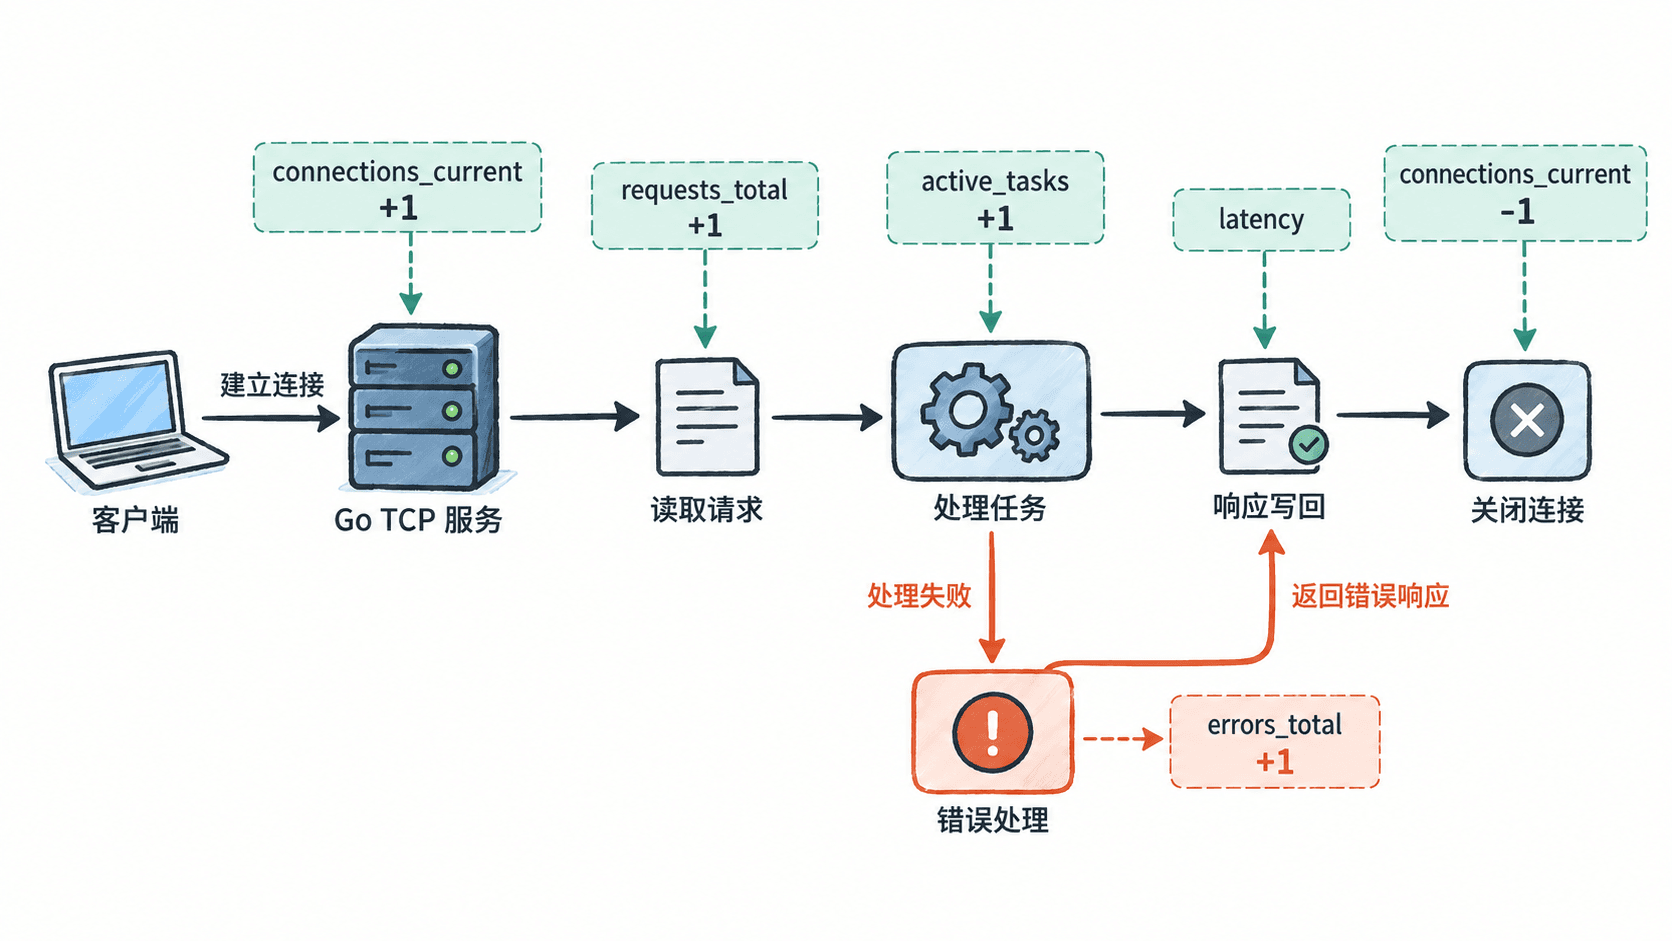
最容易出错的是把“当前值”和“累计值”混在一起。例如连接数如果只在 Accept 后加一却不在连接结束时减一,曲线会永久上升;错误率也不应单独计数,而应由 errors_total / requests_total 在展示或查询时派生;连接建立失败等传输层错误应使用另一组指标,不能混进请求错误率。
在服务路径中埋点
下面的完整程序启动一个 TCP 服务和一个只读指标端点。它用 sync/atomic 避免多个 goroutine 同时更新计数时产生数据竞争,并把平均延迟作为最小示例暴露出来。
package main

import (
	"bufio"
	"encoding/json"
	"fmt"
	"net"
	"net/http"
	"strings"
	"sync/atomic"
	"time"
)

type Metrics struct {
	connections atomic.Int64
	requests    atomic.Uint64
	errors      atomic.Uint64
	activeTasks atomic.Int64
	latencyN    atomic.Uint64
	latencyNs   atomic.Uint64
}

func (m *Metrics) observeLatency(d time.Duration) {
	m.latencyN.Add(1)
	m.latencyNs.Add(uint64(d))
}

func (m *Metrics) snapshot() map[string]any {
	req := m.requests.Load()
	errs := m.errors.Load()
	n := m.latencyN.Load()
	var errorRate, avgMs float64

	if req > 0 {
		errorRate = float64(errs) / float64(req)
	}
	if n > 0 {
		avgMs = float64(m.latencyNs.Load()) / float64(n) / 1e6
	}

	return map[string]any{
		"connections_current": m.connections.Load(),
		"requests_total":      req,
		"errors_total":        errs,
		"error_rate":          errorRate,
		"latency_avg_ms":      avgMs,
		"active_tasks":        m.activeTasks.Load(),
	}
}

func handleConn(conn net.Conn, m *Metrics) {
	m.connections.Add(1)
	defer func() {
		m.connections.Add(-1)
		_ = conn.Close()
	}()

	scanner := bufio.NewScanner(conn)
	if !scanner.Scan() {
		return
	}

	start := time.Now()
	m.requests.Add(1)
	m.activeTasks.Add(1)

	line := strings.TrimSpace(scanner.Text())
	failed := line == ""
	var writeErr error
	if failed {
		_, writeErr = fmt.Fprintln(conn, "ERR empty request")
	} else {
		_, writeErr = fmt.Fprintf(conn, "OK %s\n", line)
	}
	if writeErr != nil {
		failed = true
	}
	if failed {
		m.errors.Add(1)
	}

	m.activeTasks.Add(-1)
	m.observeLatency(time.Since(start))
}

func main() {
	var metrics Metrics

	http.HandleFunc("/metrics", func(w http.ResponseWriter, r *http.Request) {
		w.Header().Set("Content-Type", "application/json")
		_ = json.NewEncoder(w).Encode(metrics.snapshot())
	})

	fmt.Println("service=:9000")
	fmt.Println("metrics=:9100")

	go func() {
		if err := http.ListenAndServe(":9100", nil); err != nil {
			panic(err)
		}
	}()

	ln, err := net.Listen("tcp", ":9000")
	if err != nil {
		panic(err)
	}
	defer ln.Close()

	for {
		conn, err := ln.Accept()
		if err != nil {
			continue
		}
		go handleConn(conn, &metrics)
	}
}
预期输出
service=:9000
metrics=:9100
这里的平均延迟只用于说明“在哪里观测”。真实高并发服务应优先记录延迟分布,而不是只看平均值,因为少量慢请求可能被均值掩盖。
用一次请求验证指标
服务启动后,可以发送一条请求,再读取指标端点。若本机没有 nc,可使用系统中等价的 TCP 客户端。
printf 'hello\n' | nc 127.0.0.1 9000
curl -s http://127.0.0.1:9100/metrics
预期输出
OK hello
{"active_tasks":0,"connections_current":0,"error_rate":0,"errors_total":0,"latency_avg_ms":<LATENCY_MS>,"requests_total":1}
<LATENCY_MS> 会随机器负载变化。这里应重点核对请求完成后 active_tasks 和 connections_current 回到 0,requests_total 增加为 1,错误数保持不变。
生产环境还要守住这些边界
指标名应稳定且语义单一,不要把用户 ID、连接 ID、完整 URL 等高基数字段直接做标签,否则时序数量会迅速膨胀。错误率要明确分母,例如“请求失败率”与“连接失败率”不是同一个指标。
连接处理如果存在多个提前返回分支,递减操作要放在 defer 或统一清理路径中。任务计数同样要保证开始和结束成对出现。只有当这些生命周期埋点准确,后续告警和容量判断才有可信基础。