
Go / 系统课时
先看吞吐还是延迟
先看吞吐还是延迟
性能分析最常见的误区,是看到一个 QPS 或平均耗时就直接下结论。吞吐回答“单位时间完成多少工作”,延迟回答“单个请求等多久”;只有把二者放在同一负载下观察,才能知道服务是在稳定处理,还是已经接近饱和。
学习目标
- 能根据服务类型选择吞吐、分位延迟和错误率指标
- 能解释平均值、P95、P99 与峰值分别反映什么
- 能用同一轮压测数据识别容量拐点而不是比较孤立数字
先按服务目标决定主指标
用户同步等待的 API,通常先约束延迟目标,再看满足该目标时能承受多少吞吐;批处理、队列消费者或离线任务更关心单位时间处理量,但仍要监控积压和单任务耗时。容量测试则不能在吞吐和延迟之间二选一,而要找“延迟开始失控前的最大稳定吞吐”。
| 场景 | 先盯什么 | 同时必须看 |
|---|---|---|
| 在线 API | P95/P99 延迟 | 吞吐、错误率 |
| 网关/代理 | 吞吐与尾延迟 | 连接数、错误率 |
| 批处理 | 完成吞吐 | 单任务耗时、积压 |
| 容量压测 | 吞吐上限 | 延迟拐点、资源饱和 |
吞吐可以写成 ,其中 是观察窗口内完成的请求数, 是窗口时长。窗口必须固定,否则“每秒 500 请求”和“1 分钟平均 500 QPS”可能掩盖完全不同的峰值。
平均值不能代表尾部体验
平均延迟会被大量快速请求稀释。假设 20 个请求中大多数在 8~40 ms,只有少量请求达到 120 ms 和 500 ms,平均值仍可能看起来不高,但最慢的一批用户已经明显受影响。
P95 表示 95% 的请求延迟不高于该值,P99 更靠近尾部。分位数必须说明统计窗口和样本量;样本很少时,P99 往往只是最大值附近的一个样本,不能当作稳定趋势。
下面的 Go 程序用固定样本同时计算平均值、P95、P99 和最大值,并按 2 秒窗口计算吞吐。
package main

import (
	"fmt"
	"math"
	"sort"
)

func percentile(values []int, p float64) int {
	// 复制后排序,避免改变调用方持有的原始样本顺序。
	cp := append([]int(nil), values...)
	sort.Ints(cp)
	// 使用 nearest-rank:ceil(p*n),下标需要减 1。
	index := int(math.Ceil(p*float64(len(cp)))) - 1
	if index < 0 {
		index = 0
	}
	return cp[index]
}

func main() {
	latencyMs := []int{8, 9, 9, 10, 10, 10, 11, 11, 12, 12, 13, 14, 15, 16, 18, 20, 25, 40, 120, 500}
	total := 0
	max := 0

	for _, v := range latencyMs {
		total += v
		if v > max {
			max = v
		}
	}

	avg := float64(total) / float64(len(latencyMs))
	// 固定 2 秒观察窗口,吞吐等于完成请求数除以窗口时长。
	qps := float64(len(latencyMs)) / 2.0

	fmt.Printf("qps=%.1f avg=%.2fms p95=%dms p99=%dms max=%dms\n",
		qps, avg, percentile(latencyMs, 0.95), percentile(latencyMs, 0.99), max)
}
预期输出:
qps=10.0 avg=44.15ms p95=120ms p99=500ms max=500ms这个结果说明平均值 44.15 ms 并不能代表尾部:P95 已到 120 ms,而 P99 和最大值达到 500 ms。实际监控系统可能采用不同的分位数算法,因此对比数据前要确认聚合方式一致。
峰值会暴露容量拐点
随着并发提高,服务通常先表现为吞吐近似线性增长、延迟变化不大;接近 CPU、连接、锁或下游容量上限后,吞吐增幅变小,而 P95/P99 会快速上升。继续增加并发时,排队和超时会让吞吐甚至下降。
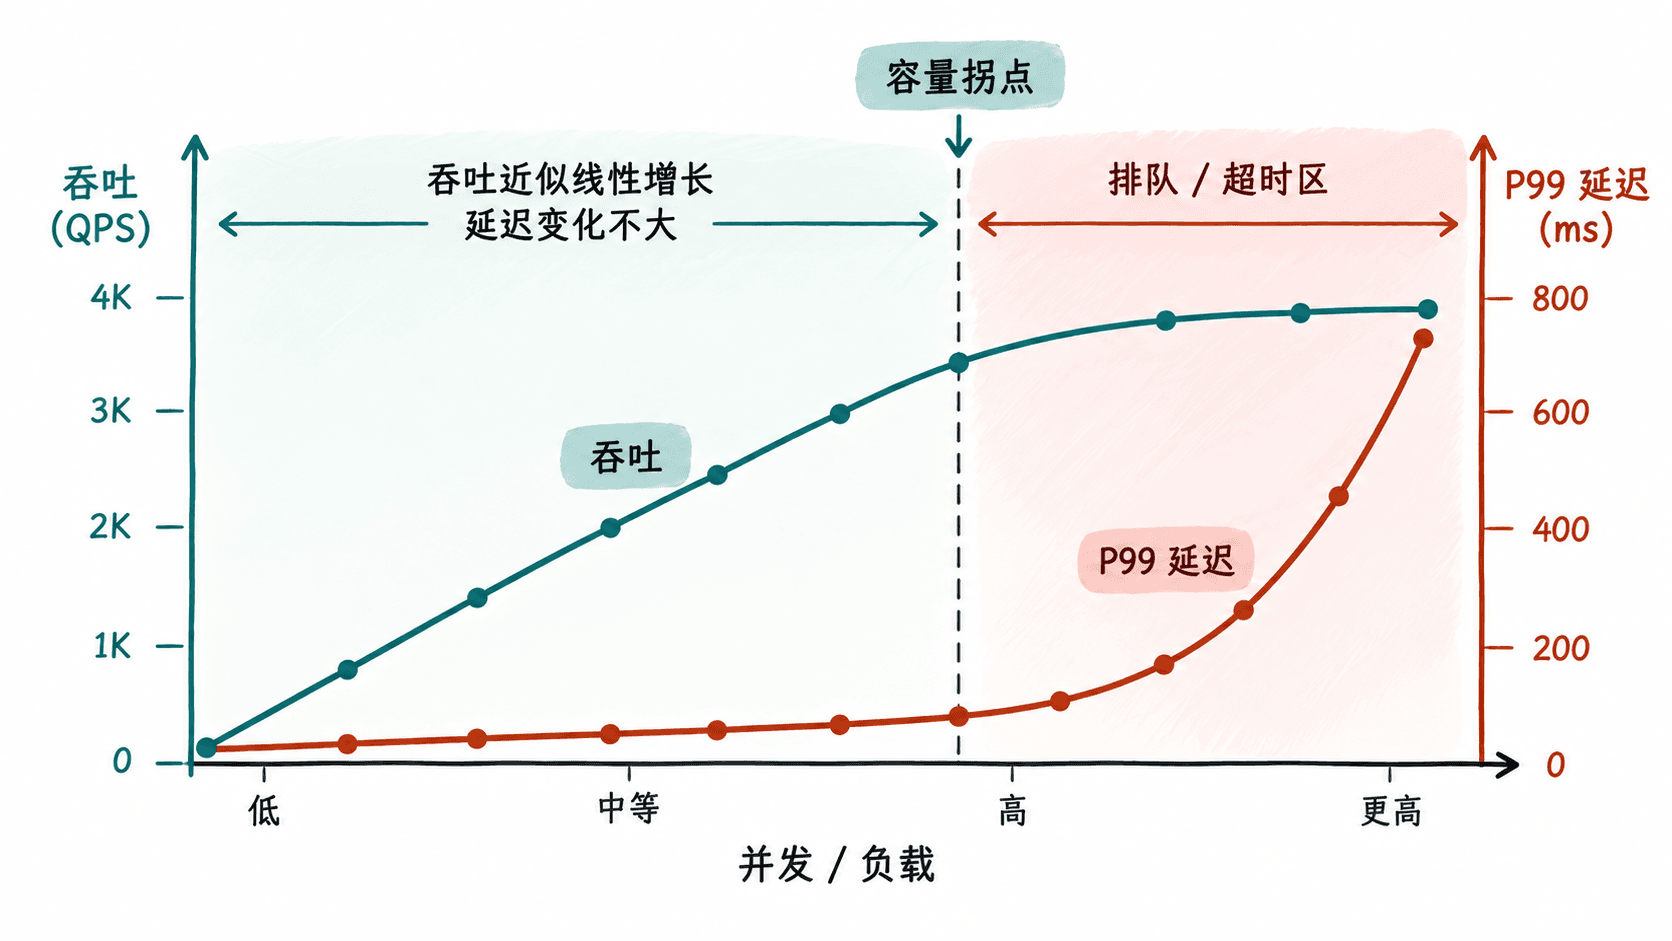
因此比较两次压测时,必须在相近的并发、请求模型、响应大小和错误率下比较。只说“优化后 QPS 更高”而不说明 P99 是否恶化,或者只说“延迟更低”却把吞吐降了一半,都不足以证明服务能力真的提升。
用同一轮压测建立判断顺序
一次有效的性能观察可以按这个顺序进行:
- 先确认错误率和超时率,避免把失败请求带来的“低延迟”误当成性能提升。
- 再看吞吐是否随负载增长,并记录当前并发或到达率。
- 同时看 P50、P95、P99,而不是只看平均值。
- 对照 CPU、内存、连接数、队列长度和下游耗时,寻找吞吐平台与尾延迟陡升对应的资源。
- 用多个连续窗口验证,而不是用单个峰值或瞬时低点下结论。
对在线服务,最有用的容量结论通常不是“最高跑到多少 QPS”,而是“在错误率可接受且 P95/P99 满足目标时,能稳定维持多少吞吐”。这个边界才适合用于容量规划、告警阈值和后续优化验证。