
Go / 系统课时
实现连接处理与消息分发
实现连接处理与消息分发
一个可用的 TCP 服务不能只做到“收一条、回一条”,还要明确谁负责解码、谁执行业务、谁写回,以及并发上限在哪里。本课把连接读循环与固定大小的 Worker 池组合起来:单连接保持有序,全局业务处理保持有界并发。
学习目标
- 组织“读取帧 → 解码 → 业务处理 → 编码写回”的连接处理链路
- 用固定 Worker 池限制全局业务并发,避免请求量直接膨胀为 Goroutine 数量
- 理解单连接串行模型的顺序保证、背压位置和适用边界
将单连接顺序和全局并发分开
最容易失控的做法,是每读到一条消息就直接 go handle(msg)。这样单个连接可以无限制造 Goroutine,响应还可能乱序。更稳妥的基础模型是:每个连接只有一个读循环;解码后把任务提交到全局有界队列;Worker 完成业务后,连接 Goroutine 再负责写回。
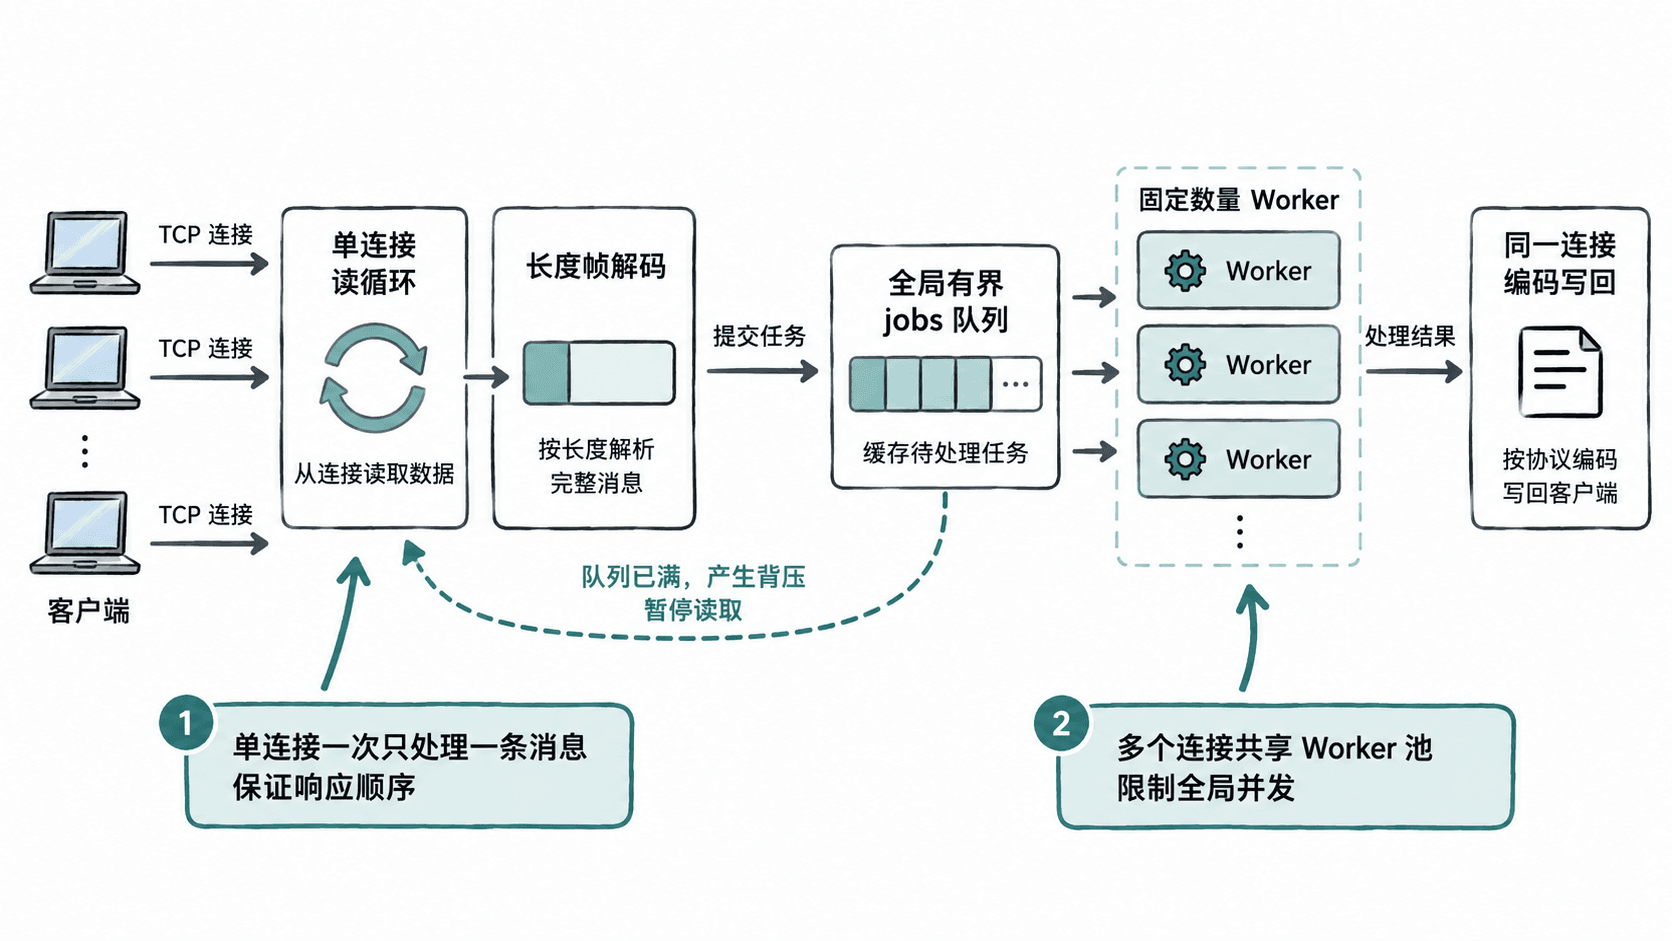
这个模型把“连接数”和“业务并发数”解耦。即使同时存在很多连接,真正并行执行的业务任务仍由 Worker 数量决定;队列满时,提交动作会阻塞,自然把压力传回连接读循环。
实现有界消息分发
下面的可运行示例使用 4 字节大端长度头定义消息帧,并用 net.Pipe 在一个进程内模拟客户端与服务端。Worker 池大小固定为 2,而每个连接在拿到当前消息结果后才继续读取下一帧,因此不会出现同连接响应乱序。
package main

import (
	"bufio"
	"encoding/binary"
	"fmt"
	"io"
	"net"
	"strings"
	"sync"
)

type job struct {
	payload []byte
	result  chan []byte
}

type workerPool struct {
	jobs chan job
	wg   sync.WaitGroup
}

func newWorkerPool(n int) *workerPool {
	p := &workerPool{jobs: make(chan job, n)}
	for i := 0; i < n; i++ {
		p.wg.Add(1)
		go func() {
			defer p.wg.Done()
			for j := range p.jobs {
				j.result <- handle(j.payload)
			}
		}()
	}
	return p
}

func (p *workerPool) Close() {
	close(p.jobs)
	p.wg.Wait()
}

func handle(payload []byte) []byte {
	if string(payload) == "ping" {
		return []byte("PONG")
	}
	return []byte(strings.ToUpper(string(payload)))
}

func serveConn(conn net.Conn, pool *workerPool) {
	defer conn.Close()
	reader := bufio.NewReader(conn)

	for {
		payload, err := readFrame(reader)
		if err != nil {
			if err != io.EOF {
				fmt.Println("server read:", err)
			}
			return
		}

		// 缓冲 1 个结果,避免 Worker 因连接切换时机而被无意义阻塞。
		result := make(chan []byte, 1)
		pool.jobs <- job{payload: payload, result: result}

		// 等待当前消息完成再写回,保留单连接请求与响应顺序。
		if err := writeFrame(conn, <-result); err != nil {
			fmt.Println("server write:", err)
			return
		}
	}
}

func readFrame(r io.Reader) ([]byte, error) {
	var header [4]byte
	if _, err := io.ReadFull(r, header[:]); err != nil {
		return nil, err
	}

	n := binary.BigEndian.Uint32(header[:])
	if n > 1024 {
		return nil, fmt.Errorf("frame too large: %d", n)
	}

	payload := make([]byte, n)
	_, err := io.ReadFull(r, payload)
	return payload, err
}

func writeFrame(w io.Writer, payload []byte) error {
	var header [4]byte
	binary.BigEndian.PutUint32(header[:], uint32(len(payload)))

	if _, err := w.Write(header[:]); err != nil {
		return err
	}
	_, err := w.Write(payload)
	return err
}

func main() {
	pool := newWorkerPool(2)
	defer pool.Close()

	serverSide, clientSide := net.Pipe()
	go serveConn(serverSide, pool)

	if err := writeFrame(clientSide, []byte("ping")); err != nil {
		panic(err)
	}

	reply, err := readFrame(clientSide)
	if err != nil {
		panic(err)
	}
	fmt.Println("client:", string(reply))
	clientSide.Close()
}
预期输出:
client: PONG这里的 1024 字节是示例的单帧上限。生产服务应按协议设置合理的最大帧长,否则攻击者可以伪造超大长度字段,诱导进程申请大量内存。
识别背压和顺序边界
固定 Worker 数只限制“正在执行业务”的并发,不等于系统永远不会堆积。jobs 的容量决定短时突发能缓冲多少任务;当队列写满,pool.jobs <- job{...} 阻塞,当前连接停止继续读,这就是最直接的背压点。
该实现还刻意让单连接一次只保留一个在途请求,因此顺序最容易推理。代价是某个慢业务会阻塞该连接后续消息。如果协议允许多路复用或乱序响应,就需要给消息增加请求 ID,并把“读”和“写”拆成独立协程,再用有界写队列统一串行写 socket。
什么时候需要更复杂的调度
当业务处理很快、协议要求按序响应时,“单连接串行 + 全局 Worker 池”通常足够稳健。若出现长任务、优先级请求或单连接高吞吐需求,应先明确是否允许乱序,再决定是否增加每连接并发、独立写队列或分级 Worker 池。
无论模型怎样扩展,都应保留三个硬边界:最大帧长、全局业务并发上限和有界队列容量。只要这三个边界可观测且可配置,连接数上升时就更容易判断瓶颈究竟在读取、排队、业务还是写回阶段。