
Go / 系统课时
排查 goroutine 与连接泄漏
排查 goroutine 与连接泄漏
网络服务出现内存缓慢上涨、连接数不降或 goroutine 持续增长时,真正的问题通常不是“并发太高”,而是资源生命周期没有闭合。本节用运行时指标、goroutine 堆栈和资源计数建立一条可重复的定位路径。
学习目标
- 区分流量峰值造成的暂时增长与持续性资源泄漏。
- 用 goroutine、活动连接和缓冲区占用三组信号缩小根因范围。
- 修复连接、阻塞 I/O 与缓冲池的生命周期,并验证指标能够回落。
先确认增长是否会回落
泄漏的关键不是“数值大”,而是负载结束后资源仍持续增长或无法回到稳定区间。先固定一个观察窗口,同时记录请求速率、runtime.NumGoroutine()、活动连接数以及缓冲区在用数量,不要只盯某一个瞬时值。
| 现象 | 更值得优先检查的方向 |
|---|---|
| goroutine、连接、缓冲区一起增长 | 每连接 goroutine 阻塞在读写,退出路径没有触发 |
| goroutine 增长,连接基本稳定 | goroutine 卡在 channel、锁、定时器或下游调用 |
| 连接增长,goroutine 已回落 | 连接被注册表、缓存或其他对象继续持有,没有关闭 |
| 缓冲区增长,连接已回落 | sync.Pool 外还有引用,或 Get 后没有对应 Put |
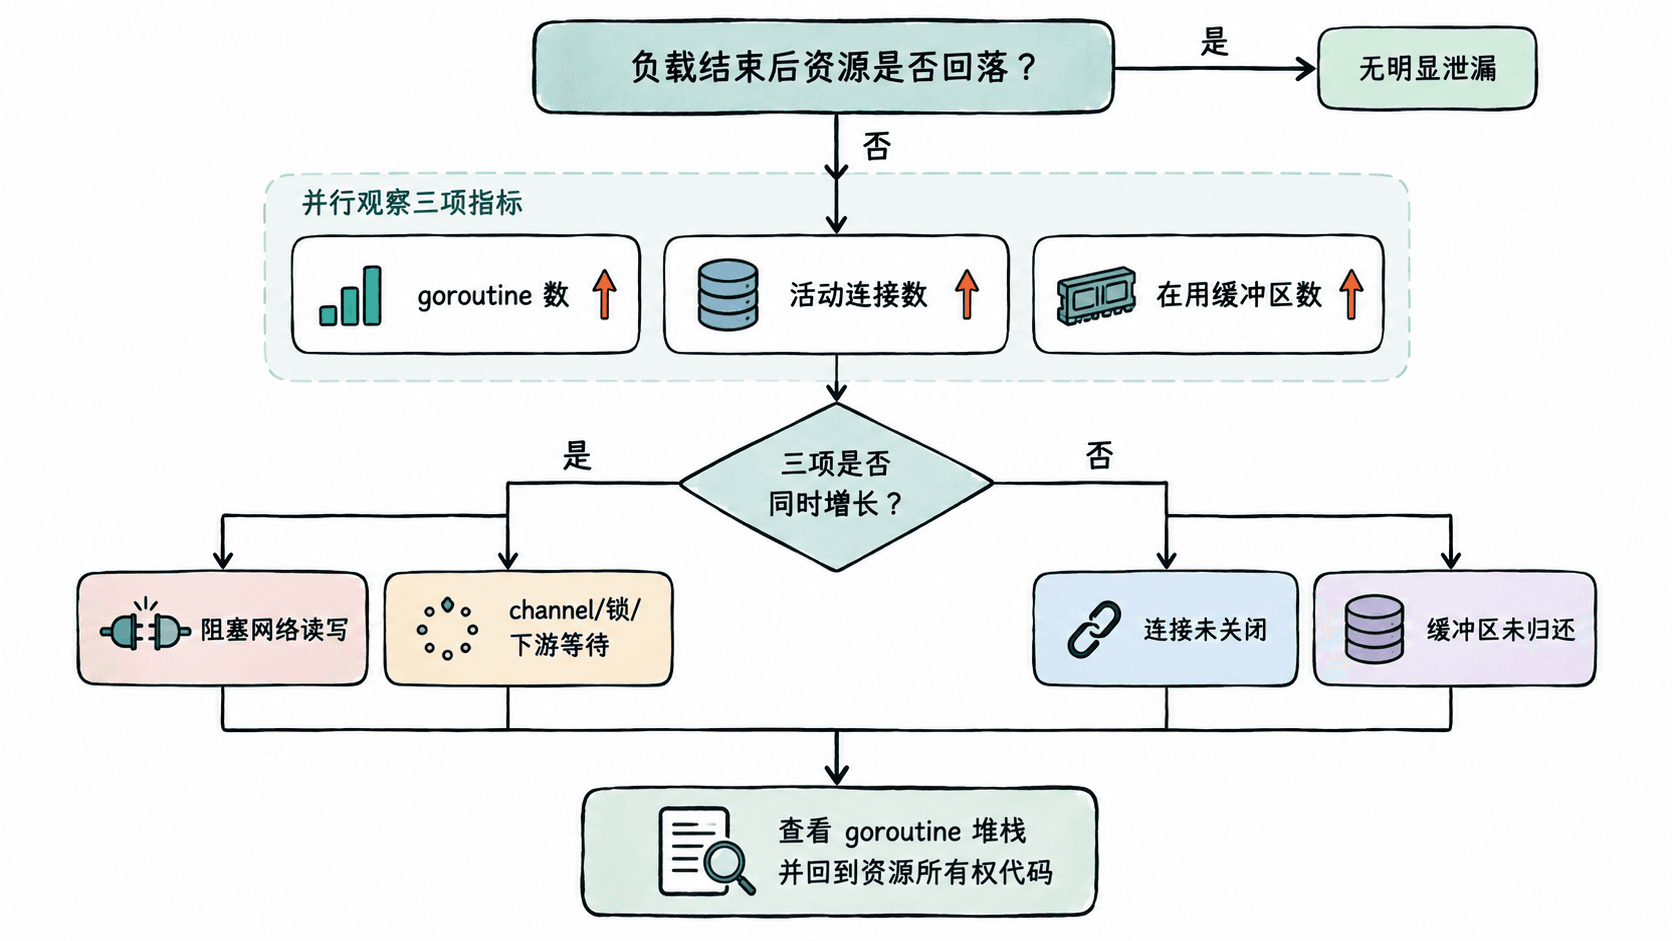
这三组指标必须来自同一个生命周期口径。连接在 Accept 或建连成功后加一,在最终关闭路径减一;缓冲区在借出时加一,在归还时减一。否则指标本身就可能制造“假泄漏”。
给资源生命周期做成对计数
下面的完整程序用 net.Pipe 模拟一条连接。处理 goroutine 持有连接和 4 KiB 缓冲区时,两个业务计数都为 1;对端关闭后,defer 负责归还缓冲区、关闭连接并减少计数。
package main

import (
	"fmt"
	"net"
	"runtime"
	"sync"
	"sync/atomic"
	"time"
)

var activeConns atomic.Int64
var inUseBuffers atomic.Int64

var bufPool = sync.Pool{
	New: func() any {
		return make([]byte, 4*1024)
	},
}

func handle(conn net.Conn, ready chan<- struct{}, done chan<- struct{}) {
	defer close(done)

	activeConns.Add(1)
	defer activeConns.Add(-1)
	defer conn.Close()

	buf := bufPool.Get().([]byte)
	inUseBuffers.Add(1)
	defer func() {
		inUseBuffers.Add(-1)
		bufPool.Put(buf)
	}()

	// 给阻塞读取一个退出边界,避免对端永远沉默时 goroutine 永久挂住。
	_ = conn.SetReadDeadline(time.Now().Add(5 * time.Second))
	close(ready)

	_, _ = conn.Read(buf)
}

func main() {
	serverSide, clientSide := net.Pipe()
	ready := make(chan struct{})
	done := make(chan struct{})

	go handle(serverSide, ready, done)
	<-ready

	fmt.Printf(
		"during active_conns=%d in_use_buffers=%d goroutines=%d\n",
		activeConns.Load(),
		inUseBuffers.Load(),
		runtime.NumGoroutine(),
	)

	_ = clientSide.Close()
	<-done

	fmt.Printf(
		"after active_conns=%d in_use_buffers=%d goroutines=%d\n",
		activeConns.Load(),
		inUseBuffers.Load(),
		runtime.NumGoroutine(),
	)
}
预期输出
during active_conns=1 in_use_buffers=1 goroutines=<GOROUTINES_DURING>
after active_conns=0 in_use_buffers=0 goroutines=<GOROUTINES_AFTER>
goroutine 总数会受 Go 版本和运行环境影响,因此 <GOROUTINES_DURING> 与 <GOROUTINES_AFTER> 的实际值可能不同;本例真正要验证的是连接与缓冲区计数最终都回到 0。
用 goroutine 堆栈找到共同阻塞点
如果服务已经启用标准库 net/http/pprof,可以先确认 goroutine profile 是否持续增长。下面是命令模板,将 <PORT> 替换成只在受控诊断网络中开放的实际端口。
curl -s "http://127.0.0.1:<PORT>/debug/pprof/goroutine?debug=1" | head -n 1预期输出
goroutine profile: total <N>总量只是入口,真正有价值的是完整 profile 里大量重复的堆栈。若许多 goroutine 停在 net.(*netFD).Read 或底层 poll 等待,优先检查读超时和关闭路径;若集中在 channel receive、互斥锁或下游客户端,则连接泄漏可能只是结果,不是根因。
从堆栈回到资源所有权
修复时不要只“杀 goroutine”,而要明确谁拥有资源、谁负责结束它。接受连接后通常由处理函数负责最终 Close;每个可能长期阻塞的读写都要有 deadline 或可触发的关闭路径;从缓冲池借出的对象应在同一作用域用 defer 归还。
还要检查循环退出条件。收到 io.EOF、超时、连接重置或服务关闭信号后,如果代码只是记录错误然后继续下一轮 Read,goroutine 仍可能长期存活。额外启动的后台 goroutine 若依赖某条连接,也必须有停止信号,不能比连接活得更久。
验证修复是否真的生效
复现同一批连接压力后,先停止新流量,再观察一个完整的超时周期。活动连接应随关闭逐步下降,缓冲区在用数量应回到稳定基线,goroutine 总数也应停止单调增长。若 goroutine 已回落而堆内存仍较高,还要区分 Go 堆保留、sync.Pool 缓存与真正的对象引用泄漏,不要仅凭 RSS 较高就下结论。
能稳定复现“增长”、从堆栈找到共同等待点,再用资源计数证明“释放”,才算把泄漏问题闭环。