
Go / 系统课时
按长度字段完成拆包
按长度字段完成拆包
长度前缀协议把每条消息编码成“固定长度头部 + 负载”,接收端先读出长度,再判断缓存中是否已有完整帧。本节实现一个 4 字节大端长度字段的解码器,重点处理半包、一次到达多帧以及末尾残留字节。
学习目标
- 设计并解析 4 字节长度前缀消息格式
- 用缓存跨越多次
Read保存不完整数据 - 连续提取完整消息,同时保留下一帧的残留字节
定义长度前缀格式
这里约定每帧前 4 字节是无符号整数,使用大端序表示负载长度,后面紧跟负载本身。例如负载 go 长度为 2,完整帧占 6 字节。
这种格式的关键不是“每次读够一帧”,而是让解码器面对任意切分的输入都能工作:缓存不足 4 字节时等待更多数据;头部完整但负载不足时继续等待;缓存中有多帧时循环提取,直到剩余数据不足一帧。
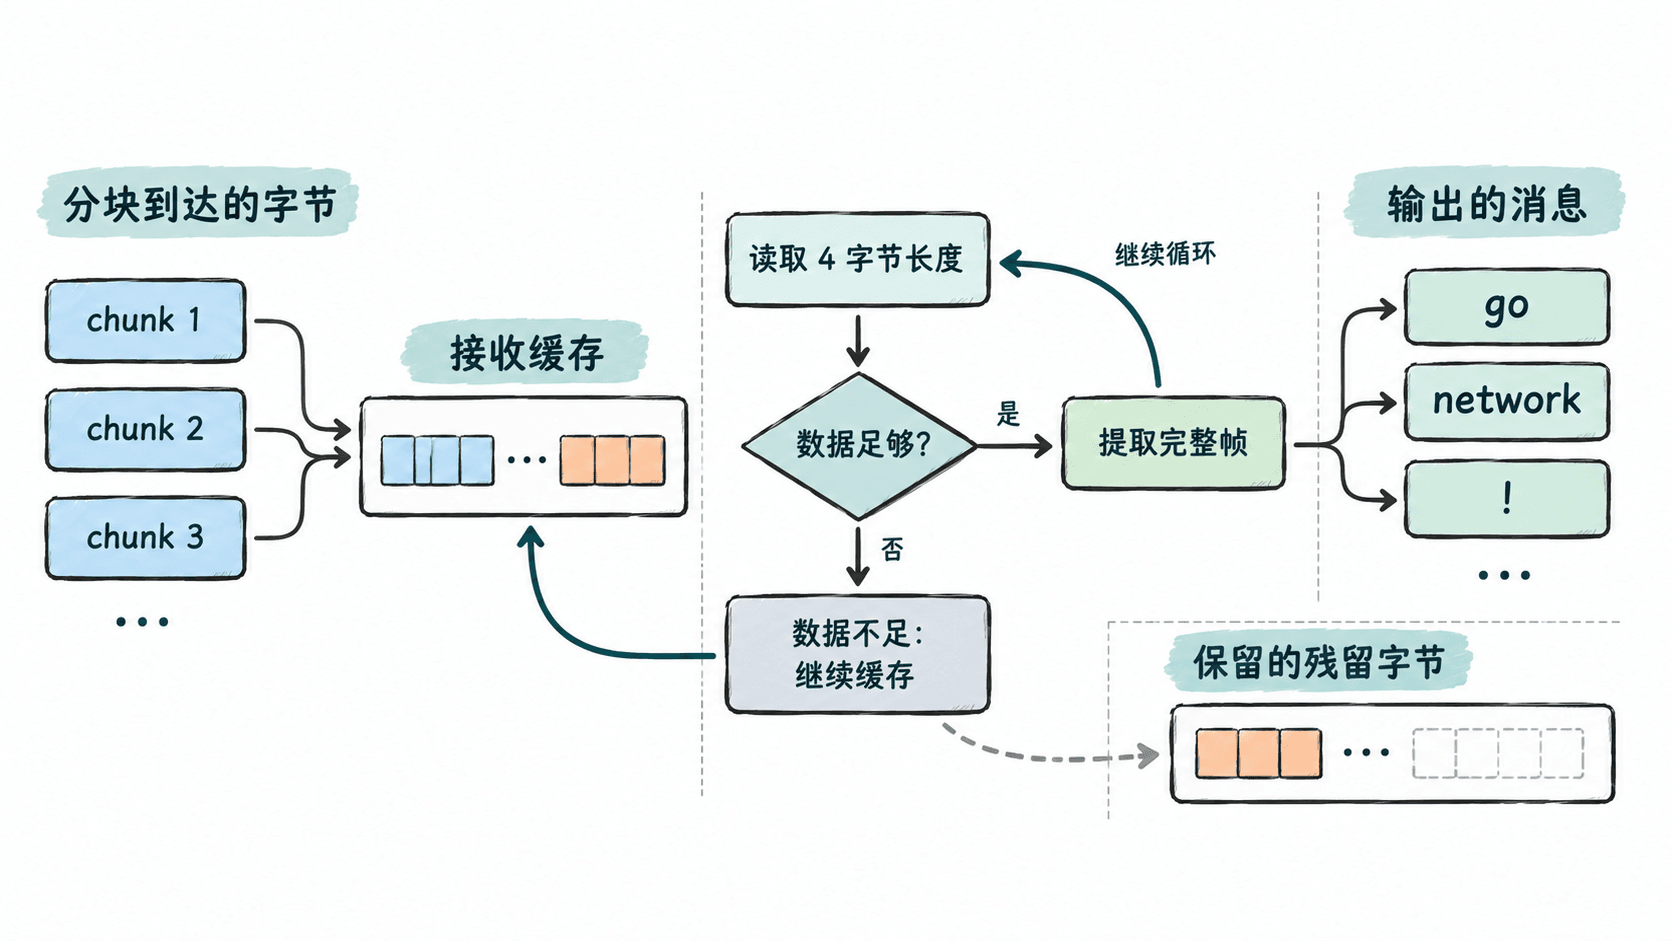
用缓存循环提取完整帧
下面的 Decoder 每次接收一段任意长度的字节。Feed 先把新数据追加到内部缓存,再循环检查是否存在完整帧。示例还设置 1 MiB 的最大负载长度,避免恶意长度字段导致协议层接受异常大消息。
go
package main

import (
    "encoding/binary"
    "fmt"
)

const maxFrameSize = 1 << 20

type Decoder struct {
    buf []byte
}

func (d *Decoder) Feed(chunk []byte) ([]string, error) {
    d.buf = append(d.buf, chunk...)
    var messages []string

    for {
        // 头部都不完整时,必须保留现有字节等待下一批数据。
        if len(d.buf) < 4 {
            break
        }

        payloadLen := binary.BigEndian.Uint32(d.buf[:4])
        if payloadLen > maxFrameSize {
            return nil, fmt.Errorf("frame too large: %d", payloadLen)
        }

        frameLen := 4 + int(payloadLen)
        if len(d.buf) < frameLen {
            break
        }

        // 复制负载后再移动缓存起点,避免结果依赖后续缓存内容。
        payload := append([]byte(nil), d.buf[4:frameLen]...)
        messages = append(messages, string(payload))
        d.buf = d.buf[frameLen:]
    }

    return messages, nil
}

func encode(payload string) []byte {
    frame := make([]byte, 4+len(payload))
    binary.BigEndian.PutUint32(frame[:4], uint32(len(payload)))
    copy(frame[4:], payload)
    return frame
}

func main() {
    stream := append(encode("go"), encode("network")...)
    stream = append(stream, encode("!")...)

    decoder := &Decoder{}
    chunkSizes := []int{3, 5, 4, 10}
    offset := 0

    for _, size := range chunkSizes {
        chunk := stream[offset : offset+size]
        offset += size

        messages, err := decoder.Feed(chunk)
        if err != nil {
            panic(err)
        }
        fmt.Printf("feed %d bytes -> %v\n", size, messages)
    }
}
预期输出
text
feed 3 bytes -> []
feed 5 bytes -> [go]
feed 4 bytes -> []
feed 10 bytes -> [network !]
第一批只有 3 字节,连长度字段都不完整;第二批到达后可以提取 go,但会留下下一帧的部分头部;最后一批则一次补齐并提取两帧。输入如何切分不会改变最终消息序列。
处理残留字节与边界条件
拆包器最容易出错的地方是“提取一帧后清空整个缓存”。正确做法是只消费当前帧的字节,把后续残留留给下一轮。代码中的 d.buf = d.buf[frameLen:] 正是在移动已消费边界,而不是丢弃全部数据。
长度字段还必须有上限检查。若协议允许的单帧最大值是 1 MiB,就应在分配大块内存或等待超长负载之前拒绝异常长度。长期连接如果反复处理很大的帧,还可以在合适时机把残留复制到新的较小切片,避免底层大数组长期被引用。
按自己的节奏,确认真正理解。