
Go / 系统课时
给协议加入版本兼容
给协议加入版本兼容
协议升级最危险的不是“版本号变了”,而是新旧两端对同一串字节产生不同解释。本节用主版本号和可跳过字段设计一个最小兼容方案,让旧客户端忽略新增字段,新客户端也能读取缺少可选字段的旧消息。
学习目标
- 区分兼容新增与破坏性变更,并决定何时需要提升主版本。
- 用“字段 ID + 长度 + 值”让未知字段可以安全跳过。
- 用旧解码器和新解码器同时验证协议的双向兼容性。
把兼容性拆成两类
新增一个可选字段通常不值得让旧客户端立刻失效。更稳妥的规则是:主版本只表示无法兼容解析的结构变化;在同一主版本内,新字段必须可跳过,缺失的可选字段必须有明确默认语义。
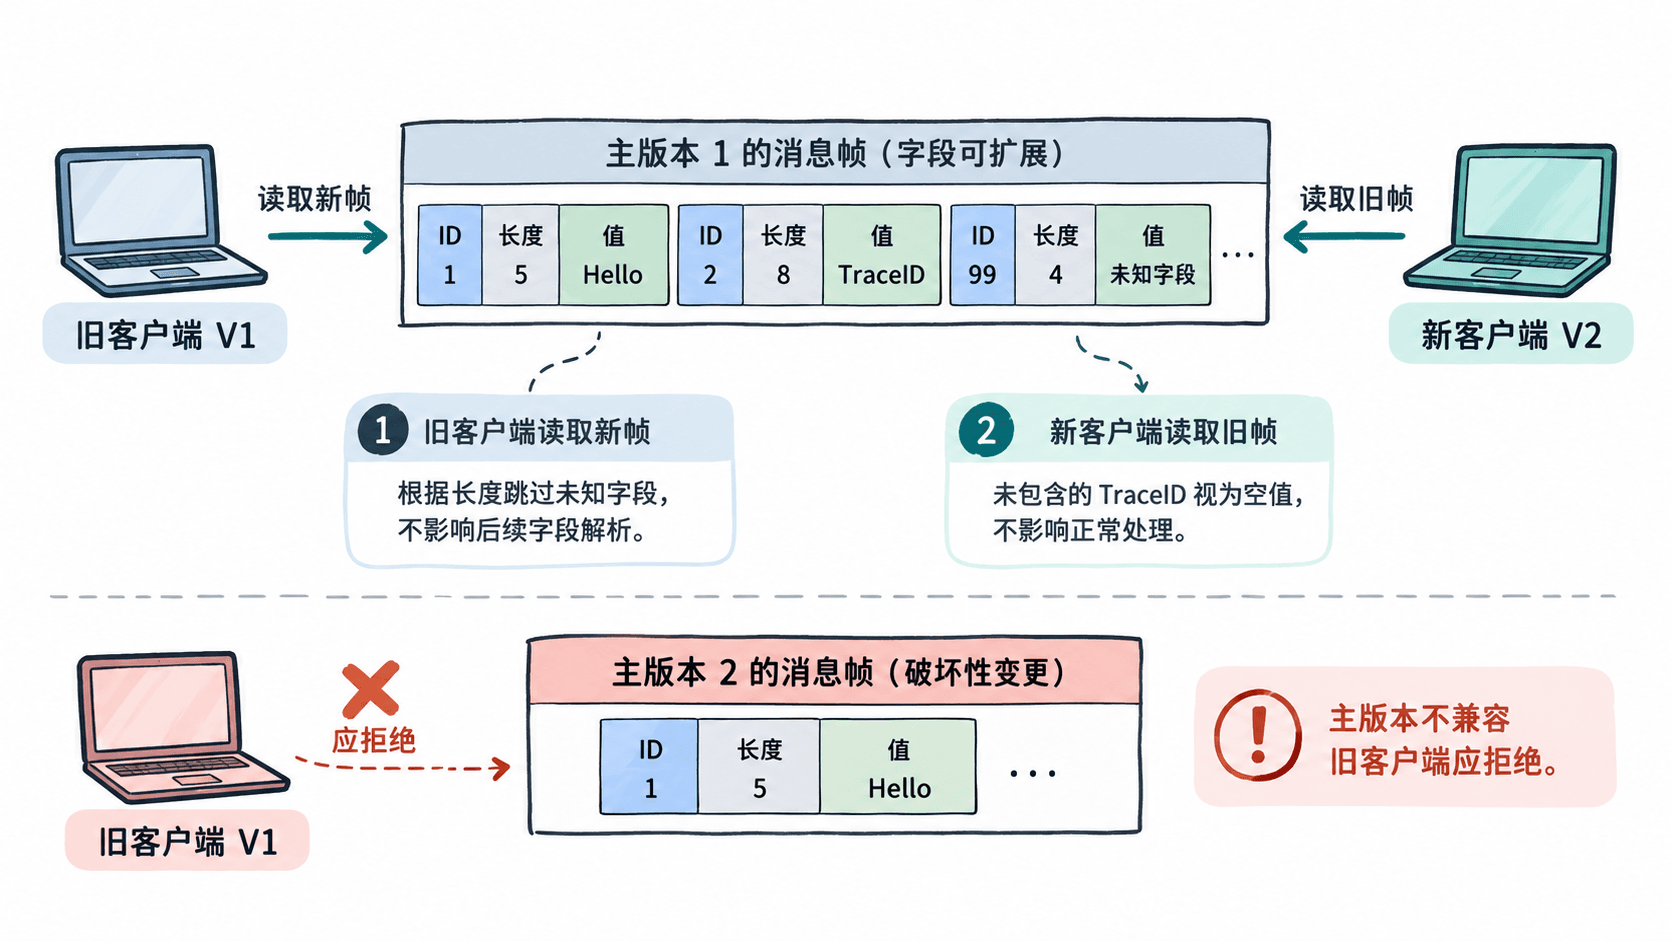
这种设计把“能不能读”与“认不认识所有字段”分开。旧端只要还能识别帧结构,就可以忽略未知字段;只有字段编码方式、基础语义或帧结构发生不兼容变化时,才提升主版本并明确拒绝。
让未知字段可以跳过
示例帧由 GP 魔数、1 字节主版本、1 字段数量,以及若干 TLV 字段组成。每个字段都带 1 字节 ID 和 2 字节长度,因此解码器遇到不认识的 ID 时,仍能用长度找到下一个字段边界。字段 1 是消息 ID,字段 2 是文本,字段 3 是 V2 新增的可选 TraceID。
关键约束是:新增字段不能改变旧字段的含义。如果原来的字段 2 表示 UTF-8 文本,就不能在不升级主版本的情况下把它改成压缩后二进制数据;“字段 ID 没变”并不等于协议仍兼容。
用新旧解码器交叉验证
下面的完整程序同时构造旧帧和新帧。decodeV1 只读取字段 1、2,因此会自然忽略字段 3 和未来字段 99;decodeV2 在此基础上识别字段 3。解析器会拒绝未知主版本、截断字段和多余尾部字节,避免把损坏数据误判成兼容数据。
package main

import (
    "bytes"
    "encoding/binary"
    "fmt"
)

type Field struct {
    ID    byte
    Value []byte
}

type MessageV1 struct {
    ID   uint32
    Text string
}

type MessageV2 struct {
    MessageV1
    TraceID string
}

func encodeFrame(major byte, fields ...Field) ([]byte, error) {
    if len(fields) > 255 {
        return nil, fmt.Errorf("too many fields: %d", len(fields))
    }

    var buf bytes.Buffer
    buf.WriteString("GP")
    buf.WriteByte(major)
    buf.WriteByte(byte(len(fields)))

    for _, f := range fields {
        if len(f.Value) > 65535 {
            return nil, fmt.Errorf("field %d too large", f.ID)
        }

        // TLV 的长度让旧解码器即使不认识字段 ID,也能跳到下一字段。
        buf.WriteByte(f.ID)
        var size [2]byte
        binary.BigEndian.PutUint16(size[:], uint16(len(f.Value)))
        buf.Write(size[:])
        buf.Write(f.Value)
    }
    return buf.Bytes(), nil
}

func parseFields(frame []byte) (map[byte][]byte, error) {
    if len(frame) < 4 || string(frame[:2]) != "GP" {
        return nil, fmt.Errorf("invalid frame header")
    }
    if frame[2] != 1 {
        // 主版本不同代表当前解析规则不能保证兼容。
        return nil, fmt.Errorf("unsupported major version: %d", frame[2])
    }

    count := int(frame[3])
    offset := 4
    fields := make(map[byte][]byte, count)

    for i := 0; i < count; i++ {
        if offset+3 > len(frame) {
            return nil, fmt.Errorf("truncated field header")
        }

        id := frame[offset]
        size := int(binary.BigEndian.Uint16(frame[offset+1 : offset+3]))
        offset += 3
        if offset+size > len(frame) {
            return nil, fmt.Errorf("truncated field %d", id)
        }

        // 先保存原始字段;具体版本只消费自己认识的 ID。
        fields[id] = frame[offset : offset+size]
        offset += size
    }

    if offset != len(frame) {
        return nil, fmt.Errorf("unexpected trailing bytes")
    }
    return fields, nil
}

func decodeV1(frame []byte) (MessageV1, error) {
    fields, err := parseFields(frame)
    if err != nil {
        return MessageV1{}, err
    }

    idBytes, ok := fields[1]
    if !ok || len(idBytes) != 4 {
        return MessageV1{}, fmt.Errorf("missing or invalid id")
    }
    textBytes, ok := fields[2]
    if !ok {
        return MessageV1{}, fmt.Errorf("missing text")
    }

    return MessageV1{
        ID:   binary.BigEndian.Uint32(idBytes),
        Text: string(textBytes),
    }, nil
}

func decodeV2(frame []byte) (MessageV2, error) {
    base, err := decodeV1(frame)
    if err != nil {
        return MessageV2{}, err
    }

    fields, _ := parseFields(frame)
    // 旧帧没有字段 3 时,string(nil) 得到空字符串,作为可选字段默认值。
    return MessageV2{MessageV1: base, TraceID: string(fields[3])}, nil
}

func u32(v uint32) []byte {
    var b [4]byte
    binary.BigEndian.PutUint32(b[:], v)
    return b[:]
}

func main() {
    oldFrame, _ := encodeFrame(1,
        Field{ID: 1, Value: u32(7)},
        Field{ID: 2, Value: []byte("ping")},
    )
    newFrame, _ := encodeFrame(1,
        Field{ID: 1, Value: u32(7)},
        Field{ID: 2, Value: []byte("ping")},
        Field{ID: 3, Value: []byte("trace-42")},
        Field{ID: 99, Value: []byte("future")},
    )

    legacy, _ := decodeV1(newFrame)
    currentOld, _ := decodeV2(oldFrame)
    currentNew, _ := decodeV2(newFrame)

    fmt.Printf("legacy: id=%d text=%q\n", legacy.ID, legacy.Text)
    fmt.Printf("current reads old: trace=%q\n", currentOld.TraceID)
    fmt.Printf("current reads new: trace=%q\n", currentNew.TraceID)
}
预期输出
legacy: id=7 text="ping"
current reads old: trace=""
current reads new: trace="trace-42"
第一行证明旧解码器能读取包含新字段和未知字段的新帧;第二行证明新解码器读取旧帧时把缺失的 TraceID 处理为默认空值;第三行则证明新端能读取新增字段。实际项目还应把这三类组合固化成自动化兼容测试,而不是只验证“当前版本对当前版本”。
什么时候必须提升主版本
如果变更导致旧端无法找到字段边界、同一字段的编码方式被替换、必填字段被删除,或原有字段语义发生不兼容改变,就应提升主版本并让旧端明确拒绝。相反,仅新增可选字段、增加新的枚举值或扩展元数据时,应优先设计为可跳过、可缺省。
协议发布前至少验证四个方向:旧端读旧帧、旧端读新帧、新端读旧帧、新端读新帧。兼容策略只有在这四条路径都有明确预期时才算完整;版本号本身只是开关,真正保证升级稳定的是字段边界、默认值和失败规则。