
Go / 系统课时
找出网络服务的排队点
找出网络服务的排队点
高并发服务变慢时,CPU 不一定高,真正的问题常是请求在某个边界排队。本篇把连接接入、goroutine、锁、内部队列与后端依赖串成等待链,并用可观测的等待时间逐段定位最先堆积的位置。
学习目标
- 能把一次请求拆成可测量的等待链,而不是只看总耗时
- 能区分 goroutine 堆积、锁竞争、队列拥塞和后端变慢
- 能用等待时间、队列长度与吞吐变化验证真正的排队点
先把请求路径改写成等待链
排队点不是“哪里最慢”,而是“请求在哪里开始等待”。一次网络请求通常会经过接入、并发准入、共享资源、内部队列和后端调用。定位时要在这些边界分别测量等待时间,而不是只记录处理函数的总耗时。
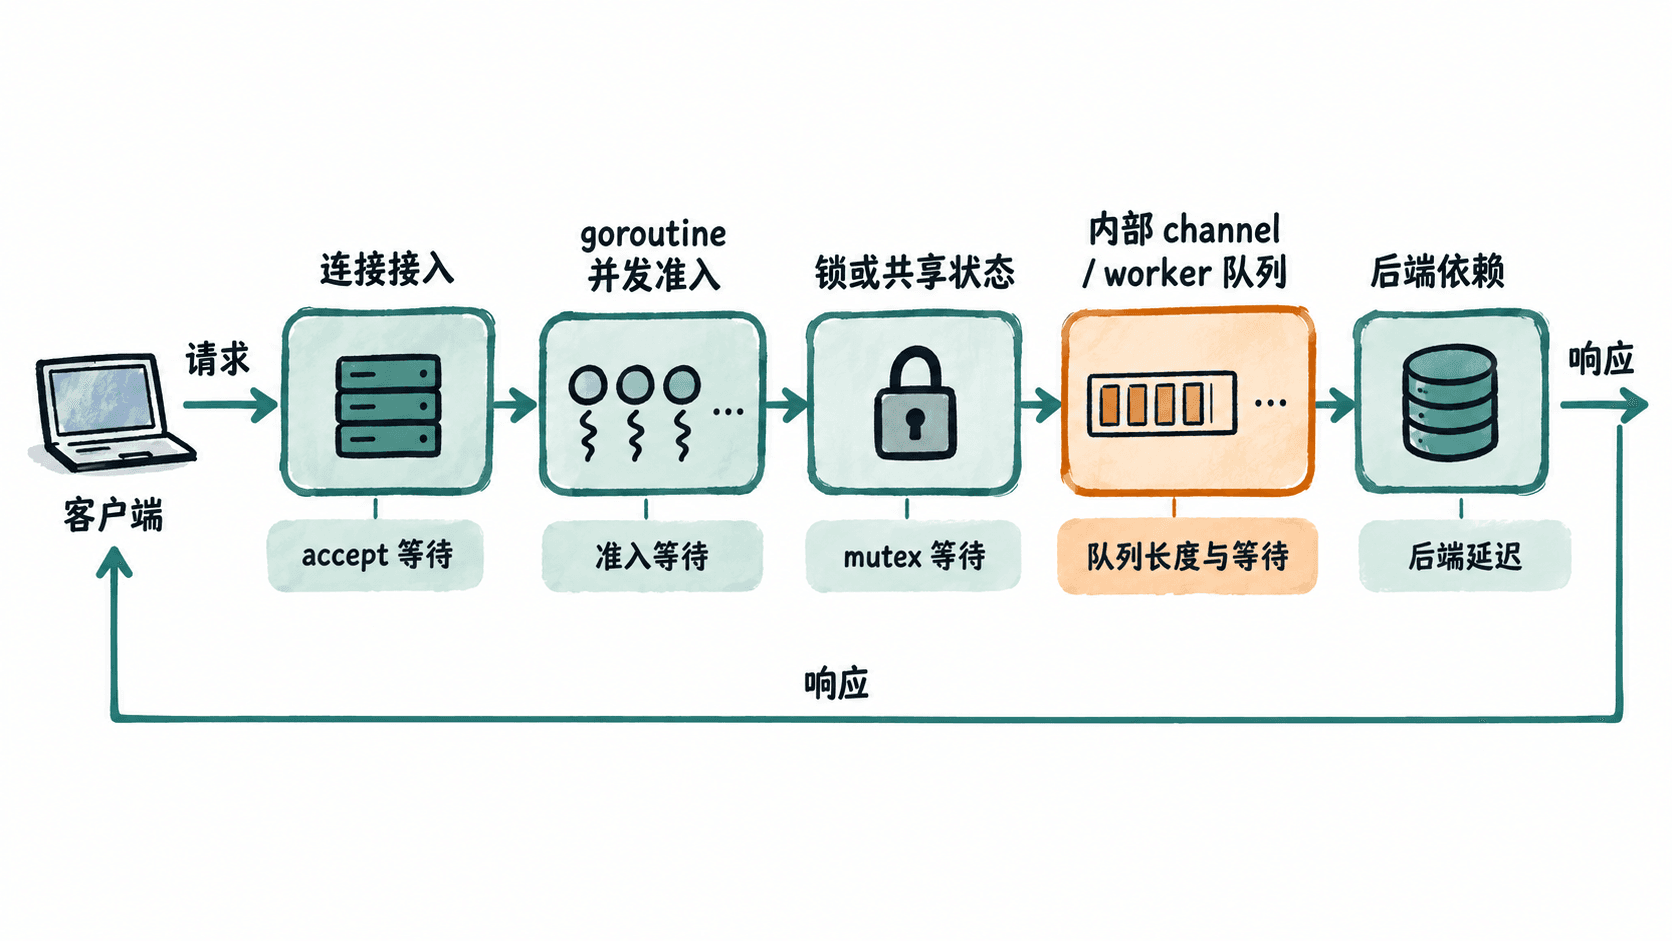
判断排队点时优先看三组信号:等待时间是否持续上升、等待中的对象数量是否增加、吞吐是否已经到平台期。只有延迟升高而没有等待增长,问题更可能是执行本身变慢,而不是排队。
在关键边界直接测等待时间
下面的示例用三个受限资源模拟并发准入、锁和后端槽位,并分别记录等待是否超过 20ms。真实服务可以把同样的计时方式放到 semaphore、mutex、channel send/receive 或连接池获取操作的前后。
package main

import (
    "fmt"
    "sync"
    "time"
)

func main() {
    workerSem := make(chan struct{}, 1)
    backendSem := make(chan struct{}, 1)
    workerSem <- struct{}{}
    backendSem <- struct{}{}

    var mu sync.Mutex
    mu.Lock()

    var ready sync.WaitGroup
    var done sync.WaitGroup
    ready.Add(3)
    done.Add(3)

    waits := make(chan struct {
        name string
        d    time.Duration
    }, 3)

    go func() {
        defer done.Done()
        start := time.Now()
        ready.Done()
        workerSem <- struct{}{}
        waits <- struct {
            name string
            d    time.Duration
        }{"worker", time.Since(start)}
        <-workerSem
    }()

    go func() {
        defer done.Done()
        start := time.Now()
        ready.Done()
        mu.Lock()
        waits <- struct {
            name string
            d    time.Duration
        }{"mutex", time.Since(start)}
        mu.Unlock()
    }()

    go func() {
        defer done.Done()
        start := time.Now()
        ready.Done()
        backendSem <- struct{}{}
        waits <- struct {
            name string
            d    time.Duration
        }{"backend", time.Since(start)}
        <-backendSem
    }()

    // 等三个 goroutine 都抵达待测边界后,再保持资源占用 30ms。
    ready.Wait()
    time.Sleep(30 * time.Millisecond)
    <-workerSem
    mu.Unlock()
    <-backendSem

    done.Wait()
    close(waits)

    seen := map[string]bool{}
    for w := range waits {
        seen[w.name] = w.d >= 20*time.Millisecond
    }

    fmt.Printf("worker_wait_detected=%t\n", seen["worker"])
    fmt.Printf("mutex_wait_detected=%t\n", seen["mutex"])
    fmt.Printf("backend_wait_detected=%t\n", seen["backend"])
}
将示例保存为 main.go 后运行:
go run main.go预期输出
worker_wait_detected=true
mutex_wait_detected=true
backend_wait_detected=true
示例只证明“等待可被单独测量”。线上服务还应累计等待时长分布,而不是只记布尔值;例如统计 P50、P95、P99,并同时记录当前队列长度或正在等待的 goroutine 数。
按固定顺序缩小范围
先从最靠前的边界检查。若接入层已经堆积,后面的 goroutine、锁和数据库指标可能只是连带现象。若接入正常,再检查并发准入和 goroutine 状态;goroutine 数持续增长而完成速率不变,通常意味着下游正在形成等待链。
接着检查共享锁和 channel。锁竞争的特征是 goroutine 大量停在同一组 Lock 调用上;channel 或 worker pool 拥塞则表现为发送方阻塞、队列长度接近上限或任务等待时间增长。最后再看连接池、RPC、数据库等后端依赖,确认是否在“获取资源”阶段排队,还是资源拿到以后执行本身变慢。
用运行时剖析验证怀疑点
Go 的 block profile 适合观察 channel、select 等阻塞,mutex profile 用来观察锁竞争。生产环境不应长期使用过高采样率;先在压测或短时间诊断窗口中开启,再把采样结果与请求级指标对齐。
package diagnostics

import "runtime"

func EnableContentionProfiles() {
    // block profile 记录阻塞事件;mutex profile 采样锁竞争。
    runtime.SetBlockProfileRate(1)
    runtime.SetMutexProfileFraction(5)
}这是片段示例,需要由服务启动流程调用,并通过 net/http/pprof 或程序内 runtime/pprof 导出 profile。生效后应能在 block profile 中看到阻塞栈,在 mutex profile 中看到竞争锁栈;具体采样数量会随负载变化。
真正的排队点应同时满足因果闭环:该边界等待上升、请求吞吐受限,并且减小该等待后端到端延迟随之下降。只看 goroutine 数量、CPU 或单次 profile 热点,都不足以单独下结论。