
大数据与流处理 / 系统课时
区分事件时间与处理时间
区分事件时间与处理时间
同一条流数据既有“业务事件何时发生”,也有“Flink 何时处理到它”两条时间线。网络延迟、乱序和重放会让两者出现偏差。本篇通过同一批事件的窗口归属对比,建立选择事件时间或处理时间的判断标准。
学习目标
- 区分事件时间与处理时间分别来自哪里、回答什么问题。
- 理解乱序和延迟为什么会改变处理时间统计,却不应改变事件时间口径。
- 在 Flink SQL 表结构中识别事件时间属性、处理时间属性与 Watermark 的职责。
两个时间属性回答不同问题
事件时间来自记录自身,描述业务事实发生的时间;处理时间来自 Flink 运行任务所在机器的时钟,描述算子真正处理到记录的时间。它们不是精度高低的区别,而是统计问题不同。
| 时间语义 | 时间来源 | 典型问题 | 对网络延迟的敏感度 |
|---|---|---|---|
| 事件时间 | 记录中的时间戳 | 10:00 到 10:01 实际发生了多少订单 | 低,允许用 Watermark 管理乱序 |
| 处理时间 | 算子当前系统时钟 | 这一分钟 Flink 实际处理了多少条记录 | 高,晚到记录会落到更晚的时间段 |
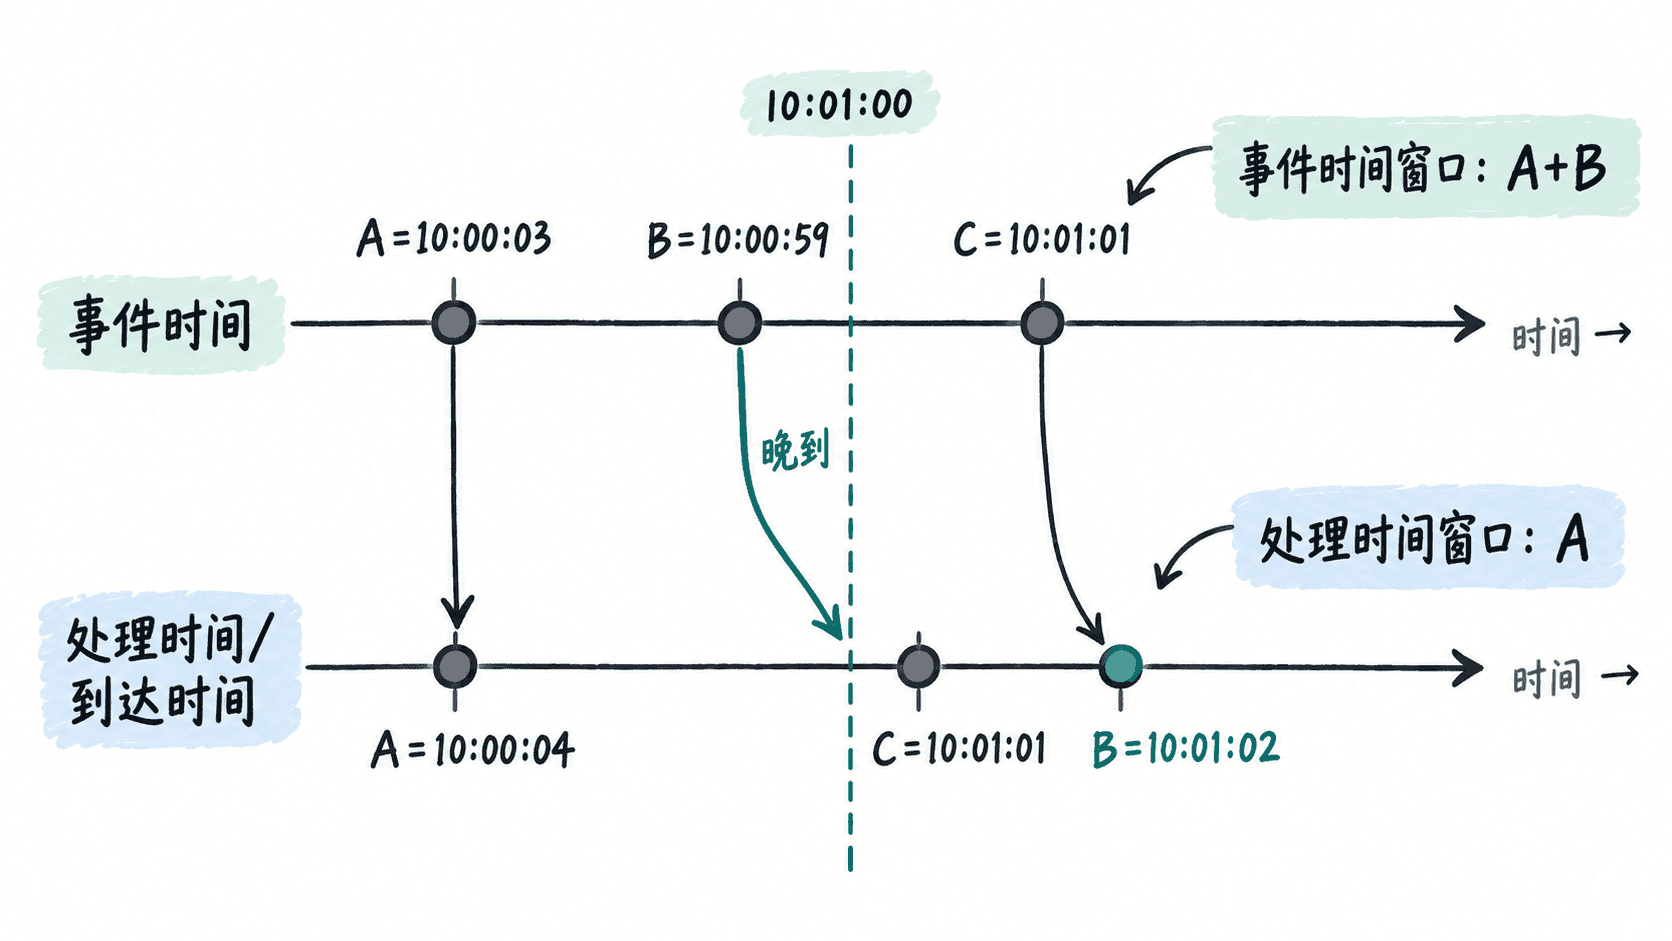
如果业务要求“无论消息晚到还是重放,仍按原发生时刻统计”,应优先使用事件时间;如果关心的是当前计算系统实际吞吐和处理节奏,处理时间更直接。
在表结构中声明时间
下面是 DDL 片段示例,<SOURCE_CONNECTOR> 需要替换成实际 Source 连接器,并补齐该连接器必需的参数,因此这段代码不能独立运行。
CREATE TABLE orders (
  order_id BIGINT,
  event_ts TIMESTAMP(3),
  -- 处理时间由算子处理记录时的系统时钟产生。
  proc_time AS PROCTIME(),
  -- Watermark 把 event_ts 声明为事件时间属性并容忍 5 秒乱序。
  WATERMARK FOR event_ts AS event_ts - INTERVAL '5' SECOND
) WITH (
  'connector' = '<SOURCE_CONNECTOR>'
);
event_ts 在声明 Watermark 后成为事件时间属性;Watermark 表达式允许事件最多按这里的策略落后于已观察到的时间进度。proc_time 则由 PROCTIME() 生成,值取决于记录被算子处理时的系统时钟,不需要也不能靠源记录恢复。
验证时可在补全连接器配置后执行 DESCRIBE orders,确认 event_ts 带有 Watermark 定义,而 proc_time 是处理时间计算列。具体展示格式可能随 Flink 版本不同。
同一批数据为什么会落入不同窗口
假设按一分钟窗口统计三条记录:
| 事件 | 事件时间 | 到达并被处理的时间 |
|---|---|---|
| A | 10:00:03 | 10:00:04 |
| B | 10:00:59 | 10:01:02 |
| C | 10:01:01 | 10:01:01 |
按事件时间看,窗口 [10:00:00, 10:01:00) 应包含 A 和 B,因为 B 的业务时间仍是 10:00:59。按处理时间看,10:00 这一分钟只处理到 A;B 到 10:01:02 才被看到,会进入更晚的处理时间窗口。
这正是两种语义的核心差异:事件时间尽量还原业务发生顺序,处理时间忠实反映计算系统看到数据的顺序。
按统计口径选择时间语义
订单金额、支付成功数、设备告警数等业务指标通常希望重放后仍得到相同的时间归属,更适合事件时间。实时吞吐、算子每分钟处理量、当前系统负载等运行指标关注“此刻处理了什么”,更适合处理时间。
事件时间还必须配合 Watermark 推进时间进度,否则系统无法仅凭一个时间戳判断某个窗口何时可以认为大体收齐。处理时间没有这个等待乱序的过程,因此实现更直接,但结果会随延迟、背压和重放时刻变化。
避免两个常见误判
表里存在 TIMESTAMP 字段,并不自动意味着查询已经采用事件时间;在 Flink SQL 中,需要把合适的时间戳列声明为事件时间属性并定义 Watermark。反过来,PROCTIME() 也不是消息进入 Kafka、数据库或网关的时间,而是 Flink 处理记录时看到的当前时间。
当结果要求按原始业务时间可复现时,优先选择事件时间;当问题本身就是“系统此刻处理了多少”,再选择处理时间。