
大数据与流处理 / 系统课时
定义流式表与连接器
定义流式表与连接器
本课把一条持续产生的数据流定义成 Flink SQL 可查询的表,并用可运行 DDL 分清物理字段、计算列与连接器配置各自负责什么,避免把表结构、数据来源和业务派生逻辑混在一起。
学习目标
- 使用
CREATE TABLE定义可持续读取的流式表 - 区分物理字段、计算列与连接器配置的职责
- 判断更换外部数据源时哪些 Schema 可以保持不变
一张表定义里有三类信息
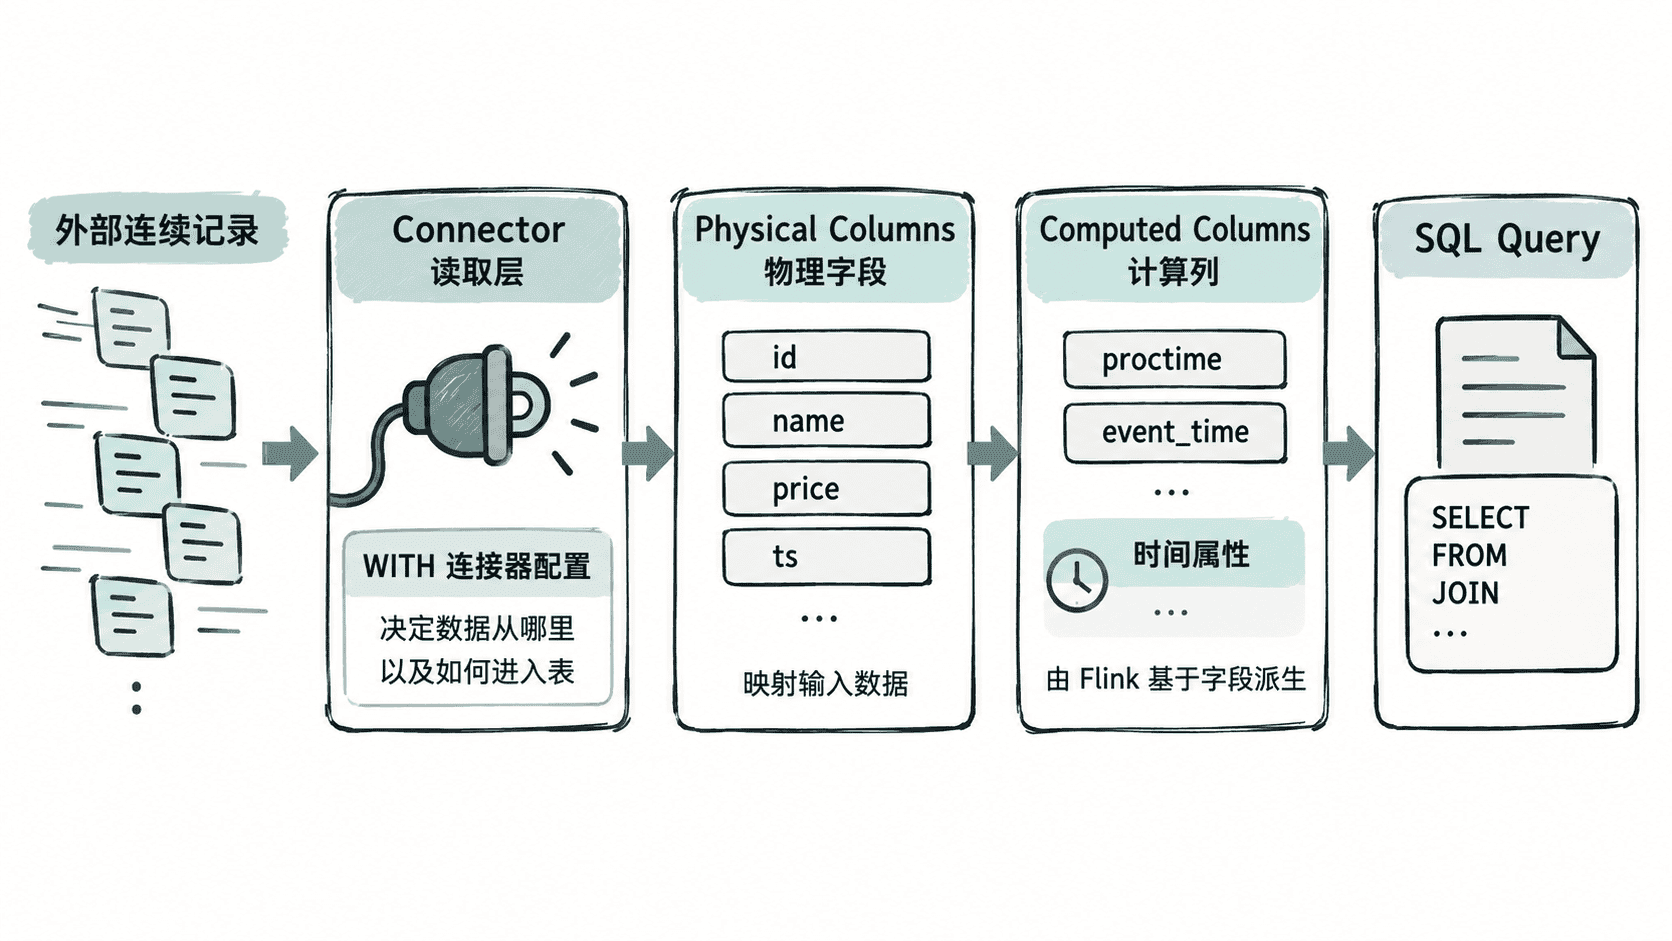
Flink SQL 面向的是表,但底层数据可能来自消息队列、文件、数据库变更流或生成器。DDL 的作用不是把外部系统复制进 Flink,而是建立一层映射:连接器负责取得记录,物理字段承接连接器产生的数据,计算列再基于这些字段形成查询可用的逻辑字段。
例如外部记录只包含 order_id、customer_id 和 amount_cents,表中仍可以增加 is_large 这样的计算列,或增加处理时间属性。计算列没有要求连接器真的提供同名字段,它由 Flink 在读取记录后计算。
用 DDL 建立可查询的流式表
下面使用 DataGen 连接器生成记录,不依赖 Kafka 等外部服务。order_id 按序递增,其余两个物理字段保持固定值;is_large 与 proc_time 都不是生成器提供的原始字段,而是表层定义出来的逻辑字段。
CREATE TEMPORARY TABLE orders (
    order_id BIGINT,
    customer_id BIGINT,
    amount_cents BIGINT,
    is_large AS amount_cents >= 5000,
    proc_time AS PROCTIME()
) WITH (
    'connector' = 'datagen',
    'rows-per-second' = '2',
    'fields.order_id.kind' = 'sequence',
    'fields.order_id.start' = '1',
    'fields.order_id.end' = '1000000',
    'fields.customer_id.min' = '42',
    'fields.customer_id.max' = '42',
    'fields.amount_cents.min' = '1000',
    'fields.amount_cents.max' = '1000'
);

SELECT order_id, customer_id, amount_cents, is_large, proc_time
FROM orders;预期输出:查询会持续产生记录,order_id 递增,proc_time 为运行时生成的处理时间,因此实际时间值不同。
1 | 42 | 1000 | false | <TIME>
2 | 42 | 1000 | false | <TIME>
3 | 42 | 1000 | false | <TIME>
...
这里最值得观察的是:DataGen 实际只生成三个物理字段,is_large 来自表达式计算,proc_time 来自 Flink 的处理时间语义。SQL 查询面对的却是包含五个字段的表。
分清 Schema 与连接器的边界
物理字段描述进入表后的数据类型和字段名,例如 order_id BIGINT。它们通常需要与连接器和数据格式能够产生的字段对应,否则会出现解析失败、字段缺失或类型转换问题。
计算列描述查询层的派生关系,例如 is_large AS amount_cents >= 5000。它不会要求外部系统新增字段,也不会把计算结果写回原始数据源。处理时间属性同样属于 Flink 表语义,而不是消息本身携带的数据。
WITH 子句则解决另一类问题:使用哪个连接器、去哪里读取、采用什么格式,以及连接器自身需要哪些参数。把连接地址、Topic、文件路径等配置写进 Schema 字段定义,会模糊数据契约与运行环境的边界。
更换数据来源时先找不变量
假设以后把 DataGen 换成 Kafka,只要 Kafka 中解析出的记录仍能提供 order_id、customer_id 和 amount_cents,上层计算列和大部分 SQL 查询就可以保持不变;需要修改的主要是 WITH 中的连接器及格式配置。
反过来,如果外部字段从 amount_cents BIGINT 改成了字符串金额,那么这已经不是单纯的连接器切换,而是输入数据契约发生变化,Schema 和依赖它的计算表达式都应重新检查。设计流式表时,把数据来源、物理字段和逻辑派生分层处理,后续迁移连接器和复用 SQL 会容易得多。