
大数据与流处理 / 系统课时
理解动态表与连续查询
理解动态表与连续查询
传统 SQL 面向某一时刻的有限关系表,而流式数据会持续到达、修正甚至撤回。本课建立动态表的核心心智模型:SQL 语义仍然作用于表,只是输入表和查询结果会随数据流不断变化。
学习目标
- 理解动态表、数据流与关系表快照之间的对应关系
- 说明连续查询为什么可以复用传统 SQL 的关系语义
- 判断一个查询的结果是只追加还是会持续更新
从静态查询到连续查询
在批处理数据库中,执行一条查询时,输入表可以看作固定快照。查询读取这份快照,计算完成后返回一个有限结果集,之后结果不会再因为新数据自动变化。
流处理中,输入没有天然的结束时刻。每当新的记录到达,输入所代表的逻辑表就可能发生变化。如果查询一直运行,那么结果也必须随输入变化持续更新,这种长期运行并不断维护结果的查询就是连续查询。
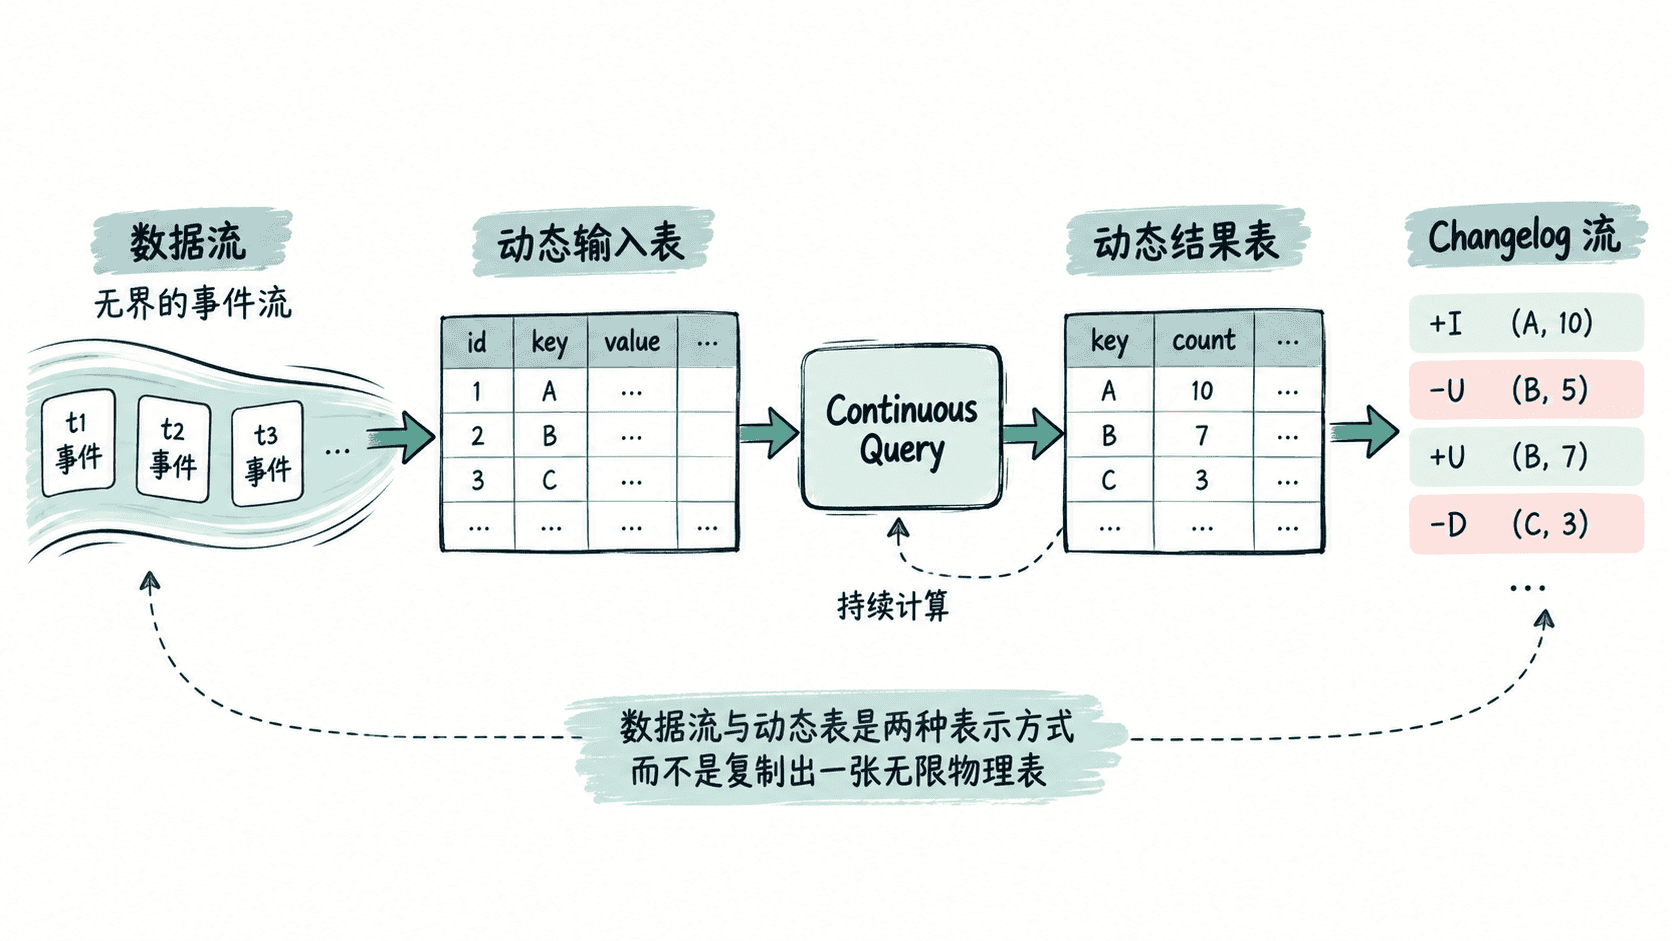
动态表可以理解为一张随时间变化的逻辑关系表。流中的每条变化消息都会让这张表从一个有效状态转移到下一个有效状态,而不是要求系统真的保存一张不断增长、每次都全量重算的表。
用快照理解动态表
假设输入是订单变化流,查询按用户计算累计金额。随着事件到达,同一条 SQL 在不同时刻对应不同的结果快照。
| 时刻 | 输入变化 | 当前累计结果 |
|---|---|---|
| T1 | 用户 A 新增金额 50 | A = 50 |
| T2 | 用户 B 新增金额 30 | A = 50,B = 30 |
| T3 | 用户 A 再新增金额 20 | A = 70,B = 30 |
这里的每一行“当前累计结果”都可以看作动态结果表在该时刻的一个快照。连续查询并不是在 T1、T2、T3 分别重新启动三次,而是在同一个运行中的作业内维护必要状态,并在输入变化后增量更新结果。
因此,动态表模型解决了一个关键映射问题:无界流负责描述变化,关系表负责描述某一时刻的状态,连续查询负责把输入状态的变化传播到结果状态。
SQL 语义没有被改写
动态表并没有发明另一套 SQL。对任意时刻取一个快照,查询结果仍应符合普通关系查询的语义。例如 GROUP BY 仍然表示按键分组,SUM 仍然计算组内聚合,JOIN 仍然按照连接条件构造关系结果。
区别在于结果不再只有一个最终版本。新记录到达后,某个分组的聚合值可能变化;连接表出现新匹配项后,已有结果也可能新增或修正。Flink 会把这些变化转换成可传播的 Changelog,而不是要求下游反复接收整张结果表。
这种模型让开发者可以用熟悉的声明式 SQL 描述“结果应该是什么”,由执行引擎负责维护状态、处理输入变化并生成增量结果。
判断结果是否会变化
不是所有连续查询都会产生更新。最简单的筛选或字段投影通常可以保持只追加:一条输入记录通过条件后产生一条新结果,旧结果不需要修改。
聚合、去重以及许多连接查询则可能修改已经存在的逻辑结果。例如某个用户当前累计金额为 50,新订单到达后变为 70,结果表中同一逻辑行发生了更新,而不是简单再追加一个互不相关的最终值。
理解动态表后,Flink SQL 的流式执行就不必被想象成“对流直接做一套特殊 SQL”:数据流描述变化,动态表描述状态,连续查询始终维护符合关系语义的最新结果。