
大数据与流处理 / 系统课时
控制 Join 状态规模
控制 Join 状态规模
流式 Join 的主要成本往往不是一次比较,而是为了等待未来匹配而长期保存两侧记录。本课从输入速率、可匹配时间范围和单条状态大小估算状态规模,并通过缩小输入、显式限制关联时间和谨慎设置状态 TTL 控制增长,同时避免因过早清理造成漏匹配。
学习目标
- 根据输入速率、保留时长和记录大小估算 Join 状态量级
- 使用过滤、投影和有界时间条件减少需要保留的数据
- 区分业务时间范围与状态 TTL,理解过早清理对正确性的影响
先找出状态为什么持续增长
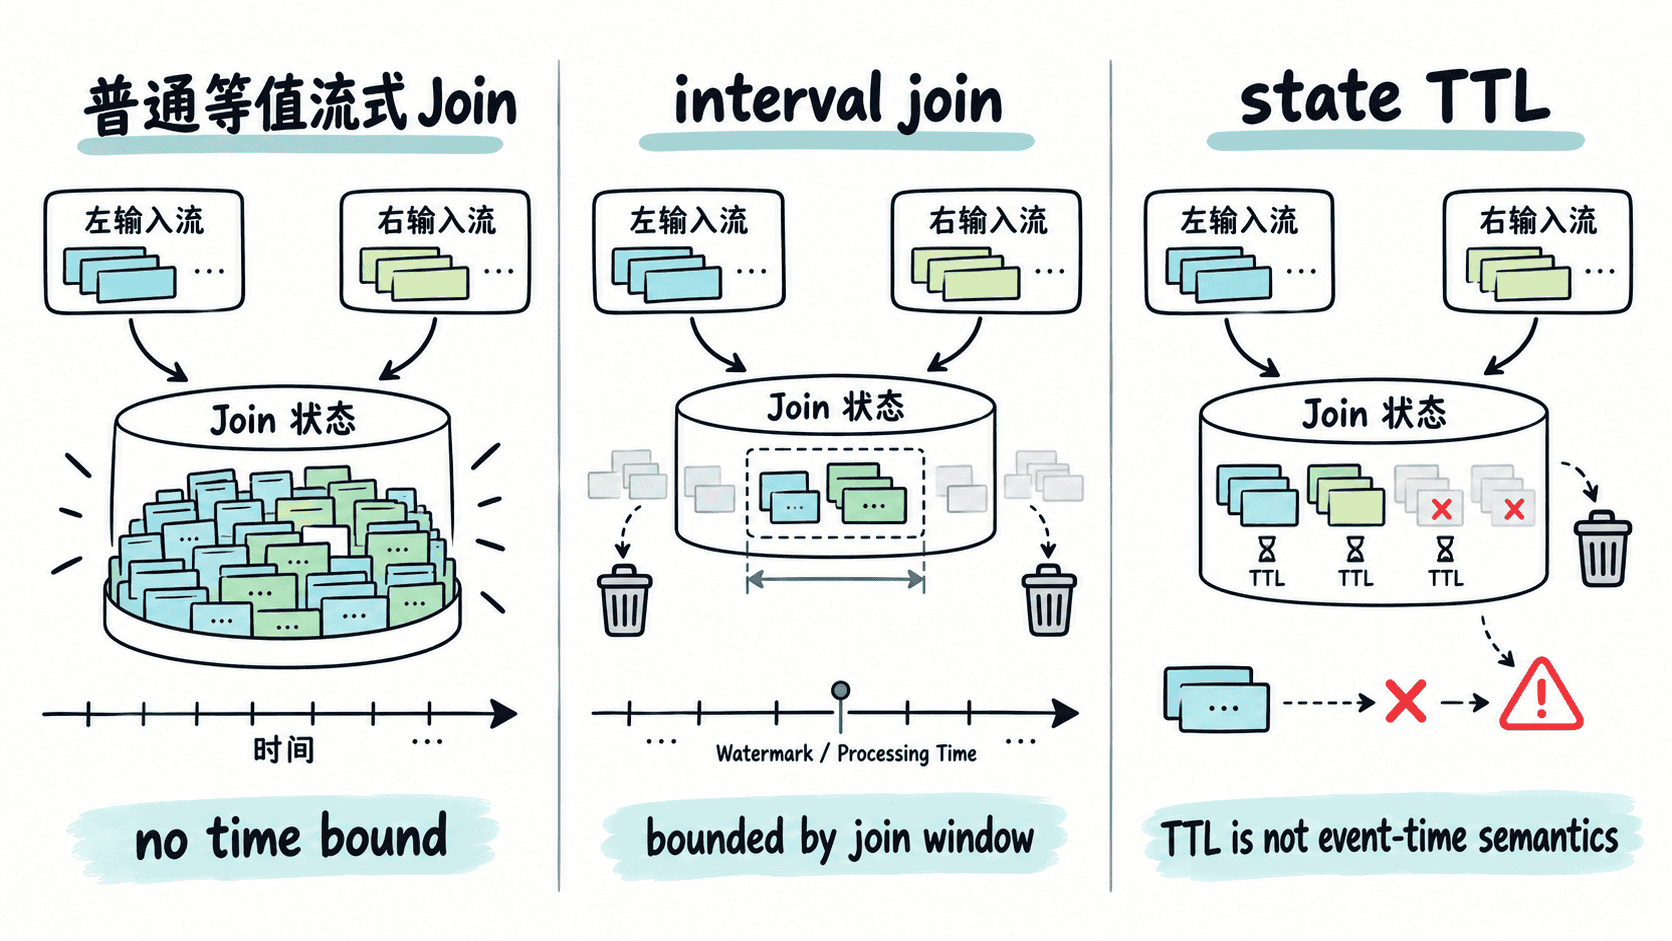
普通流式等值 Join 只有 left.key = right.key 时,系统无法仅凭当前数据判断一条记录以后是否还会遇到匹配项。只要两侧都持续输入,Join 就可能不断积累待匹配状态。
估算时不必先追求精确字节数。可以先用“输入速率 × 需要保留的时间 × 平均状态记录大小”估算两侧基础量级,再额外考虑序列化、索引结构、状态后端和 Checkpoint 开销。例如每秒 1000 条、保留 30 分钟、平均每条 300 字节,仅原始记录就约为 540 MB,实际占用通常还会更高。
优先从 SQL 语义缩小状态
最安全的优化通常发生在数据进入 Join 之前。只保留关联真正需要的行和字段,可以同时减少网络传输、序列化和状态大小。能在 Source 侧完成的过滤不要等到 Join 之后再做,大字段如果不参与关联和输出,也应尽早裁剪。
如果业务本身存在明确的可匹配时间范围,应把这个事实写进 SQL,而不是让普通等值 Join 无限等待。下面使用处理时间构造一个可直接运行的 DataGen 示例,只允许同一用户在前后 10 分钟内的记录互相匹配。
CREATE TEMPORARY TABLE clicks (
  user_id BIGINT,
  page STRING,
  pt AS PROCTIME()
) WITH (
  'connector' = 'datagen',
  'rows-per-second' = '20',
  'fields.user_id.min' = '1',
  'fields.user_id.max' = '1000',
  'fields.page.length' = '8'
);
CREATE TEMPORARY TABLE orders (
  user_id BIGINT,
  amount INT,
  pt AS PROCTIME()
) WITH (
  'connector' = 'datagen',
  'rows-per-second' = '10',
  'fields.user_id.min' = '1',
  'fields.user_id.max' = '1000',
  'fields.amount.min' = '1',
  'fields.amount.max' = '1000'
);
SELECT c.user_id, c.page, o.amount
FROM clicks AS c
JOIN orders AS o
  ON c.user_id = o.user_id
 AND c.pt BETWEEN o.pt - INTERVAL '10' MINUTE
              AND o.pt + INTERVAL '10' MINUTE;
预期结果
查询持续输出 user_id 相同且处理时间相差不超过 10 分钟的匹配记录。
DataGen 产生的具体 user_id、page 和 amount 每次运行可能不同。
随着处理时间推进,已经不可能再进入匹配窗口的旧记录可以退出 Join 状态,不需要无限期保留。
这里的关键不是固定使用 10 分钟,而是让时间范围来自真实业务语义。若订单与行为在业务上可能跨数小时甚至数天关联,就不能为了减少状态而任意缩短窗口。
把 TTL 当成最后一道治理手段
无法写出可靠时间边界的普通 Join,有时会使用 table.exec.state.ttl 限制长期闲置状态。下面是 SQL Client 当前会话中的配置示例。
SET 'table.exec.state.ttl' = '30 min';预期结果
当前 SQL Client 会话中的 table.exec.state.ttl 被设置为 30 min。
后续使用该配置的有状态算子允许清理超过保留策略的旧状态;具体清理时机和展示信息由 Flink 版本与状态后端决定。
可以执行 SET; 检查当前会话配置。更重要的是,TTL 只是状态生命周期策略,并不能证明一条记录在业务事件时间上已经不可能再次匹配。若 40 分钟后到来的右侧记录本应与已被清理的左侧记录关联,结果就可能缺失。
按风险顺序控制状态
排查状态过大时,先确认输入基数是否异常,包括重复数据、过滤失效和热点 Key;再检查是否携带了不必要的大字段。接着判断业务是否允许使用 interval join、temporal join 等具有明确时间或版本语义的关联方式,让系统能够依据语义淘汰旧状态。
只有无法从业务语义得到安全边界时,才评估 TTL,并把可能丢失的迟到匹配写入验收条件。上线后还应同时观察 Join 算子的状态规模、Checkpoint 大小与耗时、背压和输入速率;如果状态下降只是因为记录被过早删除,而结果完整性同时下降,这不是有效优化。