
大数据与流处理 / 系统课时
控制 Lookup 缓存与新鲜度
控制 Lookup 缓存与新鲜度
Lookup Join 的性能瓶颈通常不在 SQL 本身,而在每条事实数据是否都要访问外部维表。本节用 JDBC Lookup 为例,把缓存容量、过期策略与维度更新频率放到同一条链路里分析,并给出可验证的配置方法。
学习目标
- 解释 Lookup 缓存命中、未命中与维表访问之间的关系。
- 根据允许的数据陈旧时间选择缓存容量与过期策略。
- 通过更新可见性、外部查询压力和内存占用验证配置是否合理。
看清缓存命中背后的代价
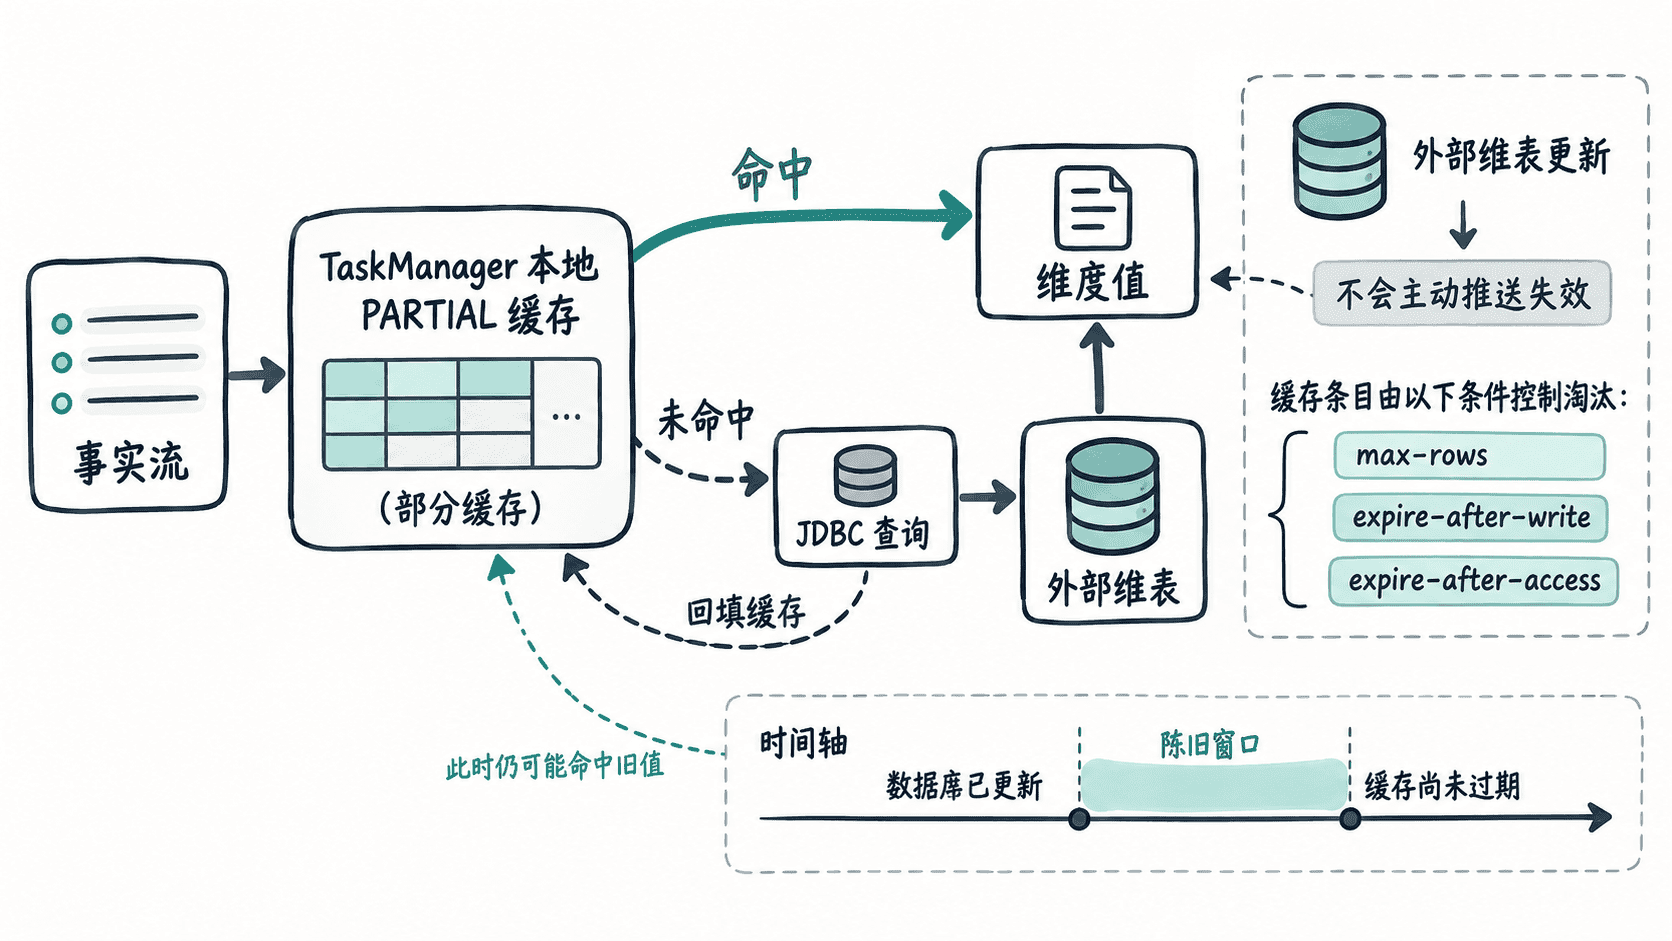
开启部分缓存后,Lookup 请求先查 TaskManager 侧的本地缓存。命中时直接返回维度行;未命中时才访问外部数据库,并把查询结果放入缓存。这样能显著减少数据库 QPS,但缓存中的值不会因为数据库刚刚更新就自动立刻失效。
因此这里同时存在三个目标:更高命中率、更低外部查询量、更短陈旧时间。它们不能同时无限优化。缓存越大、条目保留越久,通常吞吐越稳定;但维度值发生变化后,旧值也可能被继续使用更久。
配置可控的部分缓存
下面是片段示例,假定外部 MySQL 已存在 customer_dim 表,并且运行环境已经安装匹配的 Flink JDBC Connector 与 MySQL 驱动。<HOST>、<PORT>、<USER>、<PASSWORD> 需要替换为实际值。
CREATE TABLE customer_dim (
  customer_id BIGINT,
  customer_level STRING,
  region STRING,
  PRIMARY KEY (customer_id) NOT ENFORCED
) WITH (
  'connector' = 'jdbc',
  'url' = 'jdbc:mysql://<HOST>:<PORT>/app',
  'table-name' = 'customer_dim',
  'username' = '<USER>',
  'password' = '<PASSWORD>',
  'lookup.cache' = 'PARTIAL',
  'lookup.partial-cache.max-rows' = '100000',
  'lookup.partial-cache.expire-after-write' = '30s',
  'lookup.partial-cache.cache-missing-key' = 'false',
  'lookup.max-retries' = '3'
);
预期结果
缓存命中:直接返回本地缓存中的维度行
缓存未命中:访问 JDBC 维表,并将查询结果写入本地缓存
条目写入满 30s:条目过期,下一次访问重新查询外部维表
max-rows 限制单个本地缓存可保留的工作集。过小会频繁淘汰热点之外的键,导致命中率下降;过大则会增加 TaskManager 内存压力。每个 TaskManager 进程会持有本地缓存,因此扩容到更多 TaskManager 时,总缓存占用和冷启动回源压力都可能增加,不能只用“单条记录大小 × max-rows”估算整个作业。
对于新鲜度,更适合优先使用 expire-after-write 给陈旧窗口设置上界。expire-after-access 会在条目被访问后重新计算空闲时间,热点键可能长期不被淘汰,因此它更适合清理冷数据,而不适合作为严格的新鲜度上界。
把维度更新频率变成配置依据
先定义业务能接受的最大陈旧时间,再反推过期时间。例如维度平均每 10 分钟更新一次,并不意味着缓存就应该保留 10 分钟;如果业务要求更新后 1 分钟内可见,过期时间就应围绕这个 1 分钟目标设计,并把数据库复制延迟、网络延迟也留进预算。
负缓存也会影响新鲜度。lookup.partial-cache.cache-missing-key 为 true 时,“查不到”也可能被缓存;如果维表经常新增键,旧的空结果可能暂时遮住刚插入的数据。此时应缩短过期时间,或像示例一样关闭缺失键缓存。
用更新可见性验证而不是凭感觉调参
验证时固定一个维度键,先让它被 Lookup 命中,再直接更新数据库中的该键。随后持续发送引用同一键的事实数据,记录旧值最后一次出现的时间和新值第一次出现的时间。两者之间的间隔应落在业务允许范围内。
同时观察外部数据库查询 QPS、Lookup 延迟、TaskManager 内存和缓存命中/未命中趋势。若缩短过期时间后数据库压力明显上升但新鲜度收益很小,应适当放宽 TTL;若热点键长期保持旧值,则应检查是否错误使用了仅按访问过期的策略。最终配置应满足新鲜度 SLA,同时让外部维表留有稳定的容量余量。