
大数据与流处理 / 系统课时
执行流式等值 Join
执行流式等值 Join
本课用一个可重复的双流示例执行 Flink SQL 等值 Join,并把结果变化和状态语义连起来。你会看到任一侧新记录到达时如何探测另一侧状态,以及为什么普通流式 Join 可能持续占用状态。
学习目标
- 执行两个无界表之间的等值
JOIN - 解释新记录和更新记录如何改变动态表结果
- 判断普通流式 Join 的状态增长风险
无界表上的 Join 在做什么
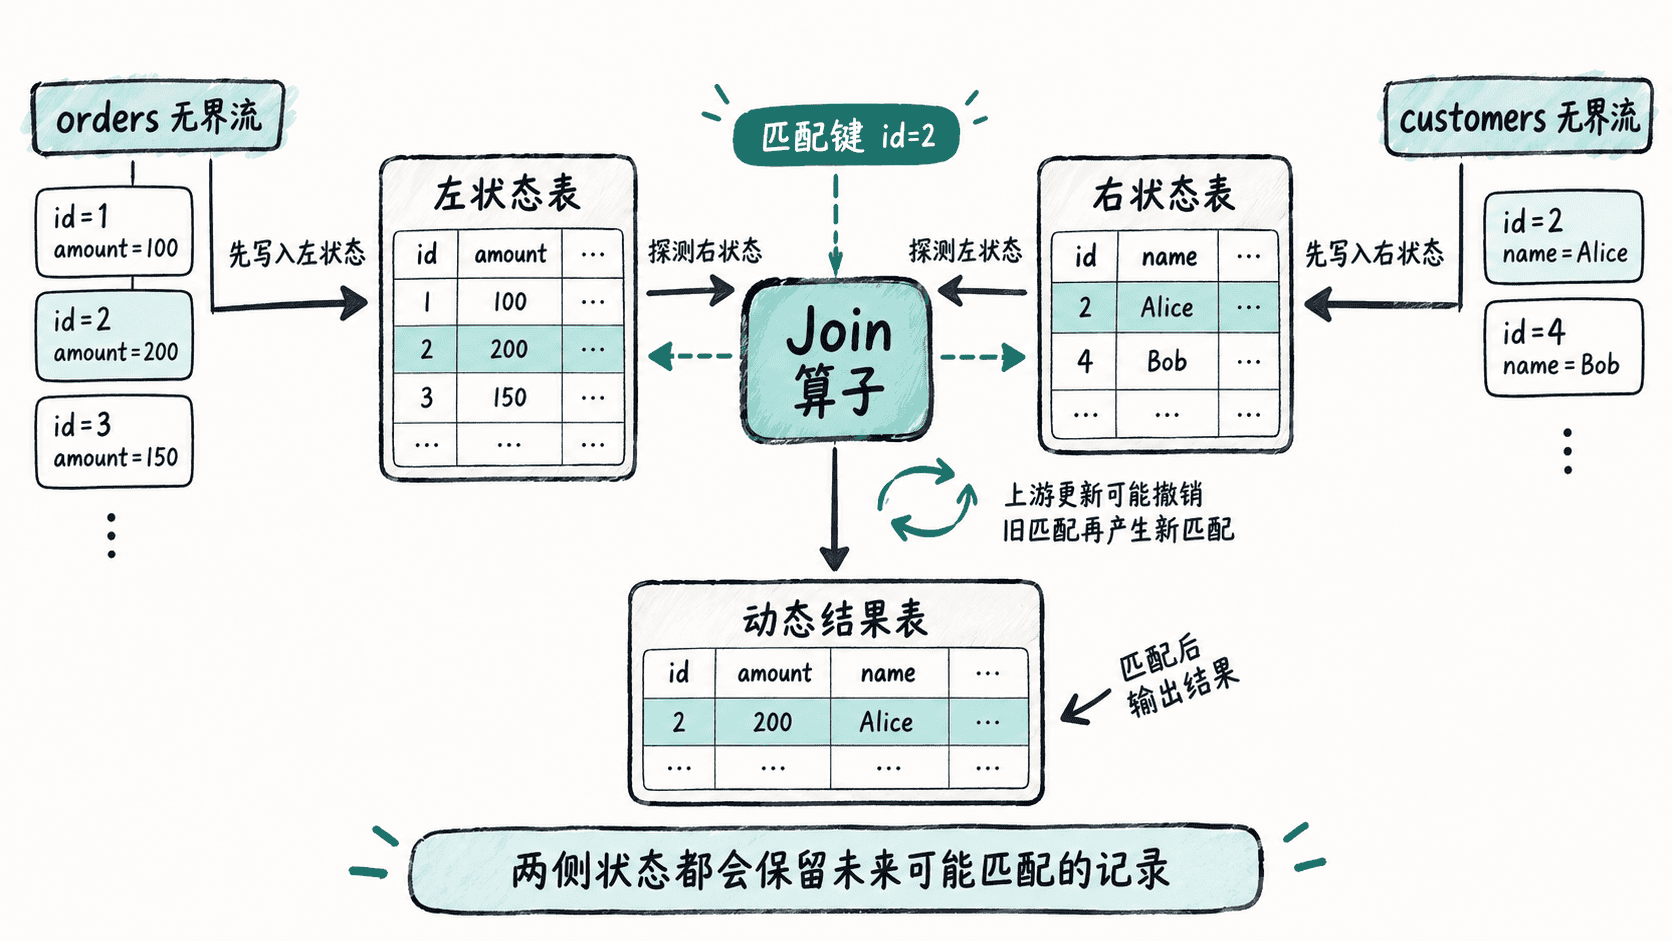
批处理 Join 面对的是固定数据集,而流式 Join 的两张表会持续变化。对于条件 left.id = right.id,左侧新记录到达时需要查右侧已经保存的记录;右侧新记录到达时也要反向查左侧。
因此,普通流式等值 Join 通常需要同时维护两侧状态。即使某条记录暂时没有匹配,也不能立即丢弃,因为未来另一侧仍可能出现同键记录。
跑一个可重复的双流示例
下面示例可在带 DataGen 连接器的 Flink SQL Client 中运行。两张表分别产生有限序列,左侧键为 1~3,右侧键为 2~4,因此最终只有 2 和 3 能匹配。
CREATE TEMPORARY TABLE left_stream (
  order_id BIGINT
) WITH (
  'connector' = 'datagen',
  'rows-per-second' = '1',
  'fields.order_id.kind' = 'sequence',
  'fields.order_id.start' = '1',
  'fields.order_id.end' = '3'
);

CREATE TEMPORARY TABLE right_stream (
  customer_id BIGINT
) WITH (
  'connector' = 'datagen',
  'rows-per-second' = '1',
  'fields.customer_id.kind' = 'sequence',
  'fields.customer_id.start' = '2',
  'fields.customer_id.end' = '4'
);

SELECT
  l.order_id,
  r.customer_id
FROM left_stream AS l
JOIN right_stream AS r
  ON l.order_id = r.customer_id;
预期输出:
+I | 2 | 2
+I | 3 | 3两行的到达顺序可能不同,但最终匹配集合相同。1 没有右侧同键记录,4 没有左侧同键记录,所以不会出现在内连接结果中。
新增和更新怎样改变结果
对插入型流,任一侧新增同键记录都可能立刻产生新的 Join 行。假设左侧已经保存 order_id=2,右侧随后到达 customer_id=2,Join 算子会在右记录到达时探测左状态并输出匹配结果;反过来的到达顺序也成立。
如果上游是 CDC 等更新型动态表,情况还多一步:旧值可能先使原有匹配失效,新值再建立新的匹配。下游看到的是插入、更新或回撤组成的 changelog;具体 RowKind 形式取决于上游 changelog 能力、执行计划和下游接收方式,但语义始终是“结果表随两侧表的变化而持续修正”。
| 输入变化 | Join 需要做的事 | 可能的结果变化 |
|---|---|---|
| 一侧新增新键 | 保存本侧并探测另一侧 | 无匹配或新增匹配 |
| 一侧新增已存在键 | 探测另一侧全部同键记录 | 可能新增多行 |
| 一侧更新 Join 键 | 撤销旧键影响,再按新键探测 | 旧结果消失,新结果出现 |
状态为什么可能一直增长
普通流式 Join 没有时间上界。对于当前未匹配的记录,系统无法证明它“以后永远不会匹配”,所以必须保留状态;长时间运行后,两侧状态可能不断增大。
可以配置 table.exec.state.ttl 让空闲状态最终被清理,但 TTL 是资源保护手段,不是 Join 语义中的时间条件。过早清理会让晚到记录失去原本应该匹配的历史状态,因此必须把可接受的数据保留时长和正确性要求一起评估。
如果业务天然存在时间范围,例如“订单只和前后 10 分钟内的支付关联”,应优先考虑带时间约束的 Interval Join、Window Join 或合适的 Temporal Join。只有确实需要跨任意未来时间等待匹配时,才应使用没有时间边界的普通流式等值 Join,并同时监控状态规模。