
大数据与流处理 / 系统课时
处理空闲分区与时间停滞
处理空闲分区与时间停滞
这节课处理一个典型故障:数据仍在进入,事件时间窗口却迟迟不出结果。常见根因是某个输入分区长时间无记录,Watermark 停在旧位置并拖住下游时间进度。你将用时间线区分空闲分区、慢分区和普通处理延迟。
学习目标
- 解释多输入场景下整体 Watermark 为什么受最慢分区约束。
- 根据分区事件时间与 Watermark 变化定位窗口停滞原因。
- 配置空闲超时,并验证窗口恢复推进后的副作用。
先看整体 Watermark 为什么会停住
在并行源中,每个输入分区都会独立推进事件时间。下游为了不提前关闭窗口,通常只能采用各有效输入 Watermark 中的最小值。只要某个分区还停在旧时间,其他分区即使不断产生新数据,也不能单方面把整体 Watermark 推过去。
例如三个分区当前状态如下:
| 分区 | 最新事件时间 | 近似 Watermark |
|---|---|---|
| P0 | 12:05:20 | 12:05:15 |
| P1 | 12:00:15 | 12:00:10 |
| P2 | 12:05:18 | 12:05:13 |
如果 P1 从 12:00:15 之后就不再收到记录,而系统仍把它视为活跃输入,那么整体 Watermark 会被卡在接近 12:00:10。任何结束时间晚于这个值的事件时间窗口,都可能继续等待。
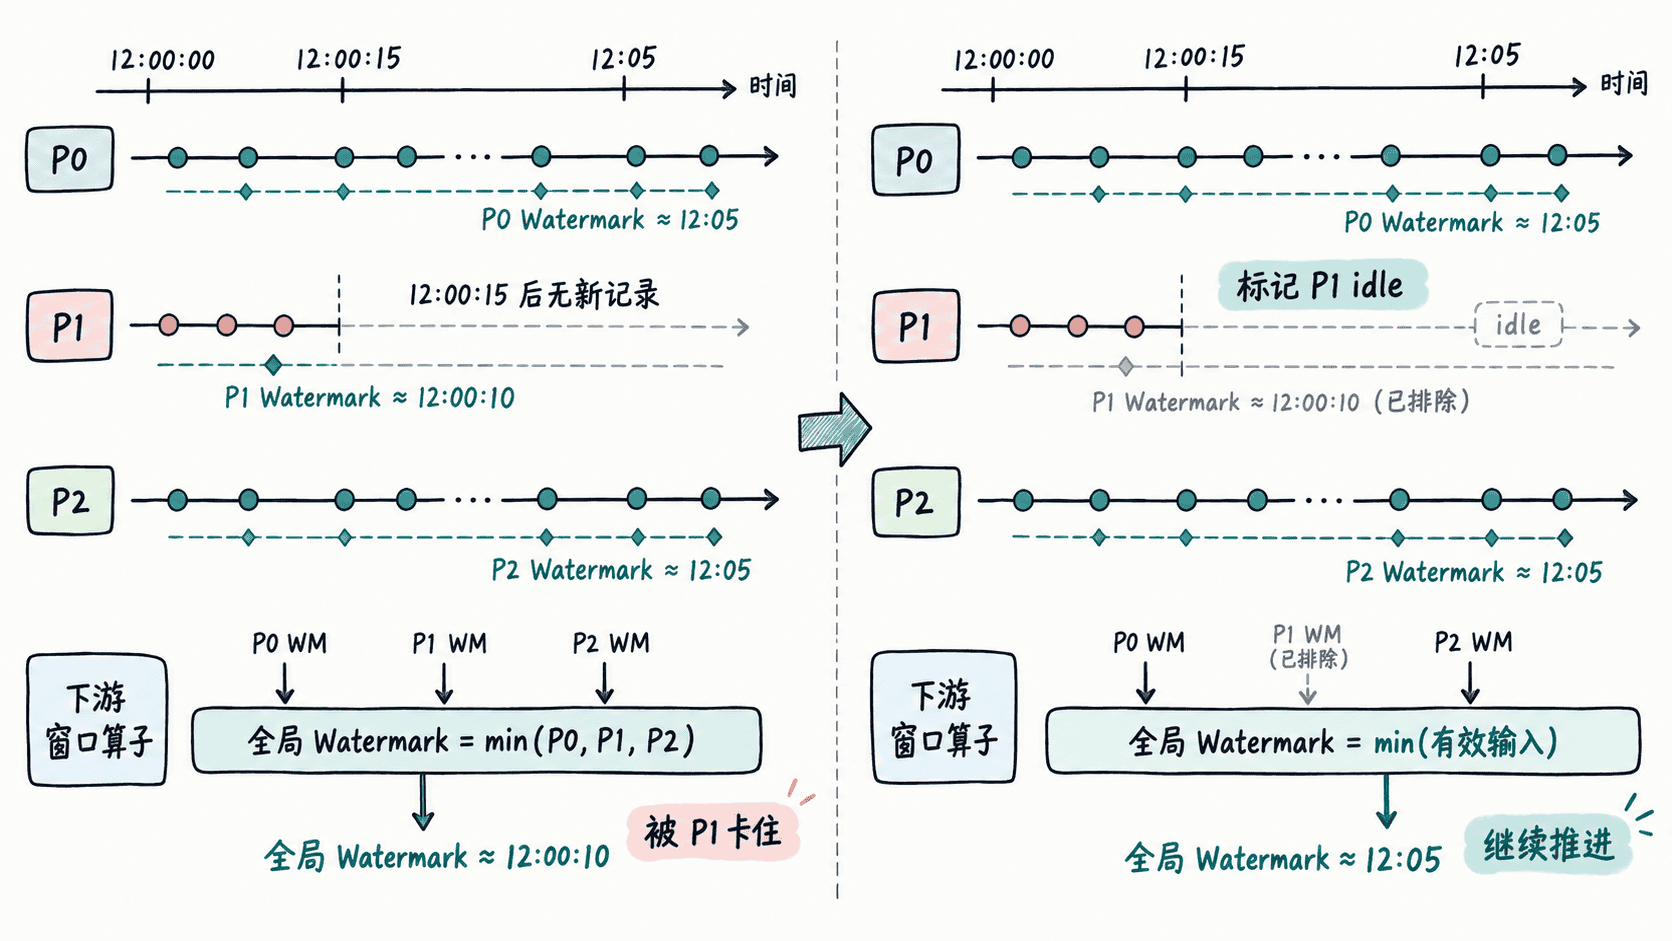
这类现象和“分区仍有数据,但事件时间本身增长很慢”不同。后者不是空闲输入,Watermark 仍应受它约束;贸然把它排除,会让真正晚到的数据更容易落到已经关闭的窗口之后。
配置空闲输入超时
Flink SQL 可以通过 table.exec.source.idle-timeout 设置源空闲超时。下面把持续 30 秒无记录的源输入标记为空闲;这是一项会影响后续查询规划和运行行为的会话配置,应在提交查询前设置。
SET 'table.exec.source.idle-timeout' = '30 s';预期结果:当某个源输入连续约 30 秒没有收到记录时,它可以被标记为空闲并暂时不再拖住下游 Watermark 的最小值计算;仍有数据的分区则继续推动事件时间前进。不同 Flink 版本或客户端的提示文本可能不同,因此不要用固定日志字符串作为唯一验收标准。
超时不能设得比正常数据间隔还小。假设某个分区本来就每 20~40 秒才产生一条记录,把空闲超时设成 5 秒,会频繁把正常分区误判为空闲;等它恢复数据时,较旧记录可能已经落后于当前 Watermark。
建立窗口不出结果的定位顺序
先确认“数据还在流动”具体指什么:是所有分区都有新记录,还是只有部分分区有新记录。随后比较各源子任务的输入时间与 Watermark 进度,找出哪个输入长时间不再前进。
定位时按下面顺序收集证据:
- 确认窗口使用的是事件时间字段,而不是处理时间。
- 确认活跃分区的事件时间仍在增长,并观察整体 Watermark 是否停在一个旧值。
- 查找是否存在长时间无记录的分区;如果停滞时间点接近该分区最后一批事件时间,优先怀疑空闲分区。
- 如果分区持续有记录但时间戳一直很旧,应排查上游时间戳生成、时区或数据积压,而不是启用更激进的空闲超时。
- 如果记录和 Watermark 都整体变慢,还应检查背压或算子处理阻塞,因为 Watermark 也需要沿执行图向下游传播。
这条顺序的目的,是先证明“最慢输入是谁”,再决定是否使用 idleness。仅凭“窗口没出结果”直接调大或调小 Watermark 延迟,很容易掩盖真正的问题。
验证修复后的时间线
配置空闲超时后,不要只看窗口终于有结果。至少同时验证三个现象:空闲分区达到超时后不再卡住整体 Watermark;活跃分区继续推动 Watermark 前进;原本等待的窗口在 Watermark 越过结束边界后完成。
还要观察空闲分区恢复时的行为。它重新产生的数据如果事件时间明显早于当前 Watermark,就可能成为迟到数据,已经完成的窗口不会因为这个分区“复活”而自动回退重算。因此,合理的空闲超时应大于正常静默间隔,又小于业务可以接受的结果等待时间。
空闲检测解决的是“没有记录导致无法继续估计事件时间进度”,不是所有 Watermark 停滞问题。把分区活跃度、事件时间增长和 Watermark 变化放在同一条时间线上,才能判断该调 idleness、修时间戳,还是处理背压。