
大数据与流处理 / 系统课时
设计 JDBC Lookup Join
设计 JDBC Lookup Join
本节把关系数据库直接作为外部维度源,通过 JDBC Lookup Join 为持续到来的事实流补充当前维度信息。重点不只是写出 SQL,而是同时设计查询键、缓存策略和数据库容量,避免每条事实都把一次随机查询压到线上数据库。
学习目标
- 能使用处理时间编写 JDBC Lookup Join
- 能根据查询键和索引设计评估单次 Lookup 的成本
- 能用事实流速率、缓存命中率和数据库容量估算是否需要缓存或限流
先明确 Lookup Join 的语义
JDBC Lookup Join 在事实记录到达时,按连接键去外部数据库查询维度行。它通常使用左表的处理时间 PROCTIME(),因此拿到的是查询发生时数据库可见的值,而不是事实事件发生时的历史版本。
这和 CDC 事件时间 Temporal Join 的目标不同:前者适合“补充当前属性”,后者适合“按事实时间还原历史属性”。如果账单、风控或审计要求历史可重放,不能仅靠普通 JDBC Lookup Join。
定义处理时间事实表和 JDBC 维表
下面以订单事实流关联 customer_dim 为例。proc_time 由 Flink 生成,不需要来自 Kafka 消息;JDBC 表只声明查询所需字段即可。
CREATE TABLE order_fact (
  order_id STRING,
  customer_id BIGINT,
  amount DECIMAL(12, 2),
  proc_time AS PROCTIME()
) WITH (
  'connector' = 'kafka',
  'topic' = 'order-fact',
  'properties.bootstrap.servers' = '<HOST>:<PORT>',
  'properties.group.id' = 'order-jdbc-lookup',
  'scan.startup.mode' = 'latest-offset',
  'format' = 'json'
);

CREATE TABLE customer_dim (
  customer_id BIGINT,
  customer_level STRING,
  region STRING,
  PRIMARY KEY (customer_id) NOT ENFORCED
) WITH (
  'connector' = 'jdbc',
  'url' = 'jdbc:mysql://<HOST>:<PORT>/shop',
  'table-name' = 'customer_dim',
  'username' = '<USER>',
  'password' = '<PASSWORD>'
);

SHOW TABLES;
预期输出
SHOW TABLES 结果应至少包含:
customer_dim
order_fact
生效行为:每条 order_fact 记录都会以 customer_id 作为 Lookup 条件访问 customer_dim。实际 JDBC 连接器版本可能提供缓存、重试和超时参数,选项名称应以当前连接器文档为准,但底层容量判断不变。
写出 Lookup Join
Lookup Join 的 SQL 仍然使用 FOR SYSTEM_TIME AS OF,但时间点来自处理时间列。右侧 JDBC 表不会被 Flink 持续订阅成完整 CDC 状态,而是在需要时执行点查。假设数据库中 customer_id=2001 当前为 GOLD / west,事实流到达一笔对应订单。
SELECT
  o.order_id,
  o.customer_id,
  o.amount,
  d.customer_level,
  d.region
FROM order_fact AS o
LEFT JOIN customer_dim FOR SYSTEM_TIME AS OF o.proc_time AS d
ON o.customer_id = d.customer_id;
预期输出
order_id | customer_id | amount | customer_level | region
O9001    | 2001        | 88.00  | GOLD           | west
如果数据库随后把该客户等级改为 PLATINUM,后续到达的事实可能查到新值;已经输出的旧事实不会因为数据库变化自动回写。
让查询键真正走索引
Lookup Join 的连接条件应尽量命中维表主键或高选择性的唯一索引。下面的数据库定义让 customer_id 成为主键,从而把点查控制在稳定的索引访问路径。以下 SQL 在 MySQL 的 shop 数据库中执行。
USE shop;

CREATE TABLE customer_dim (
  customer_id BIGINT PRIMARY KEY,
  customer_level VARCHAR(20) NOT NULL,
  region VARCHAR(32) NOT NULL
);

INSERT INTO customer_dim (customer_id, customer_level, region)
VALUES (2001, 'GOLD', 'west');

EXPLAIN SELECT customer_level, region
FROM customer_dim
WHERE customer_id = 2001;
预期结果
执行计划应使用 PRIMARY 主键索引按 customer_id 点查,而不是全表扫描;具体 cost、rows 和执行计划文本会因 MySQL 版本与统计信息不同而变化。如果 Join 条件变成低选择性的 region,即使 SQL 语法成立,也可能一次返回大量行或触发低效扫描。设计 Lookup Join 时应先问“能否用稳定的业务键定位一行”,再考虑 Flink 侧调优。
用容量公式判断是否需要缓存
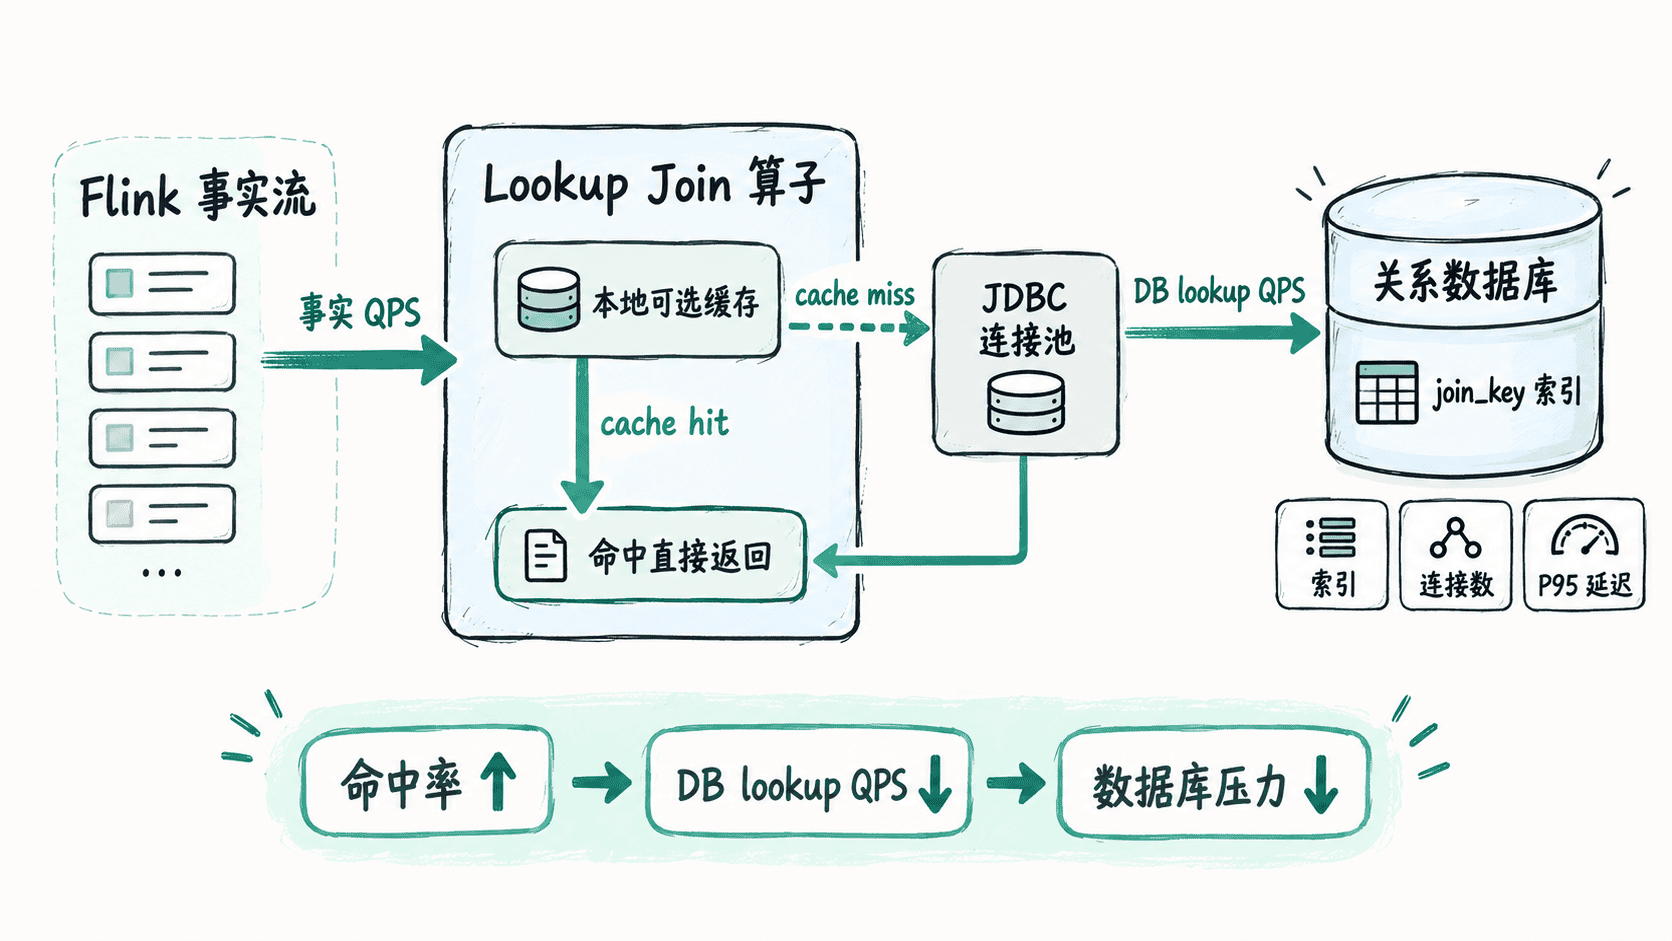
没有缓存时,数据库查询速率大致等于事实流速率。存在缓存后,可以用下面的近似关系做第一轮容量估算:
例如事实流为 5000 条每秒,缓存命中率为 90%,则数据库仍要承担约 500 QPS。还要叠加并行子任务数量、连接池上限、查询尾延迟以及数据库本身的其他业务流量,不能只看平均 QPS。
缓存适合热点键明显、维度变化不频繁且允许短暂陈旧的场景。TTL 太长会放大旧值窗口,TTL 太短则命中率不足;如果维度要求秒级强一致,缓存收益和一致性要求往往互相冲突。
验收 Lookup Join 设计
上线前至少验证三件事:第一,数据库执行计划确实使用预期索引;第二,在目标并发下测量 Lookup 的 P50/P95 延迟与失败率;第三,观察事实峰值时数据库 QPS、活跃连接数和 CPU 是否仍有安全余量。
如果数据库已经接近容量上限,优先考虑提高缓存命中率、降低无效 Lookup、把热点维度同步到可本地化查询的存储,或改用 CDC 方式把维度状态维护在 Flink 中,而不是简单增加算子并行度。增加并行度会同时提高潜在数据库并发,可能让吞吐问题演化成数据库雪崩。