
大数据与流处理 / 系统课时
理解 Regular Join 状态
理解 Regular Join 状态
Regular Join 在两条持续输入的动态表之间做等值关联时,系统无法提前知道一条旧记录是否还会与未来数据匹配,因此通常要长期保留两侧 Join 状态。本篇用一条 SQL 和状态流转示意,解释状态为何增长、风险从哪里来,以及什么时候应改用有时间边界的 Join。
学习目标
- 解释 Regular Join 为什么需要同时保存左右两侧记录
- 判断无时间边界关联为何可能造成持续状态增长
- 区分 Regular Join 与有界时间 Join 的适用场景
Regular Join 为什么要保存两侧记录
假设订单流和支付流都不会结束,只按 order_id 做普通等值关联。下面是片段示例:假定 orders 与 payments 已注册为持续更新的动态表。
SELECT
    o.order_id,
    o.user_id,
    p.payment_id,
    p.amount
FROM orders AS o
JOIN payments AS p
ON o.order_id = p.order_id;
预期结果
当两侧出现相同 order_id 时输出匹配组合;
暂时没有匹配到的记录继续留在 Join 状态中,等待未来数据。
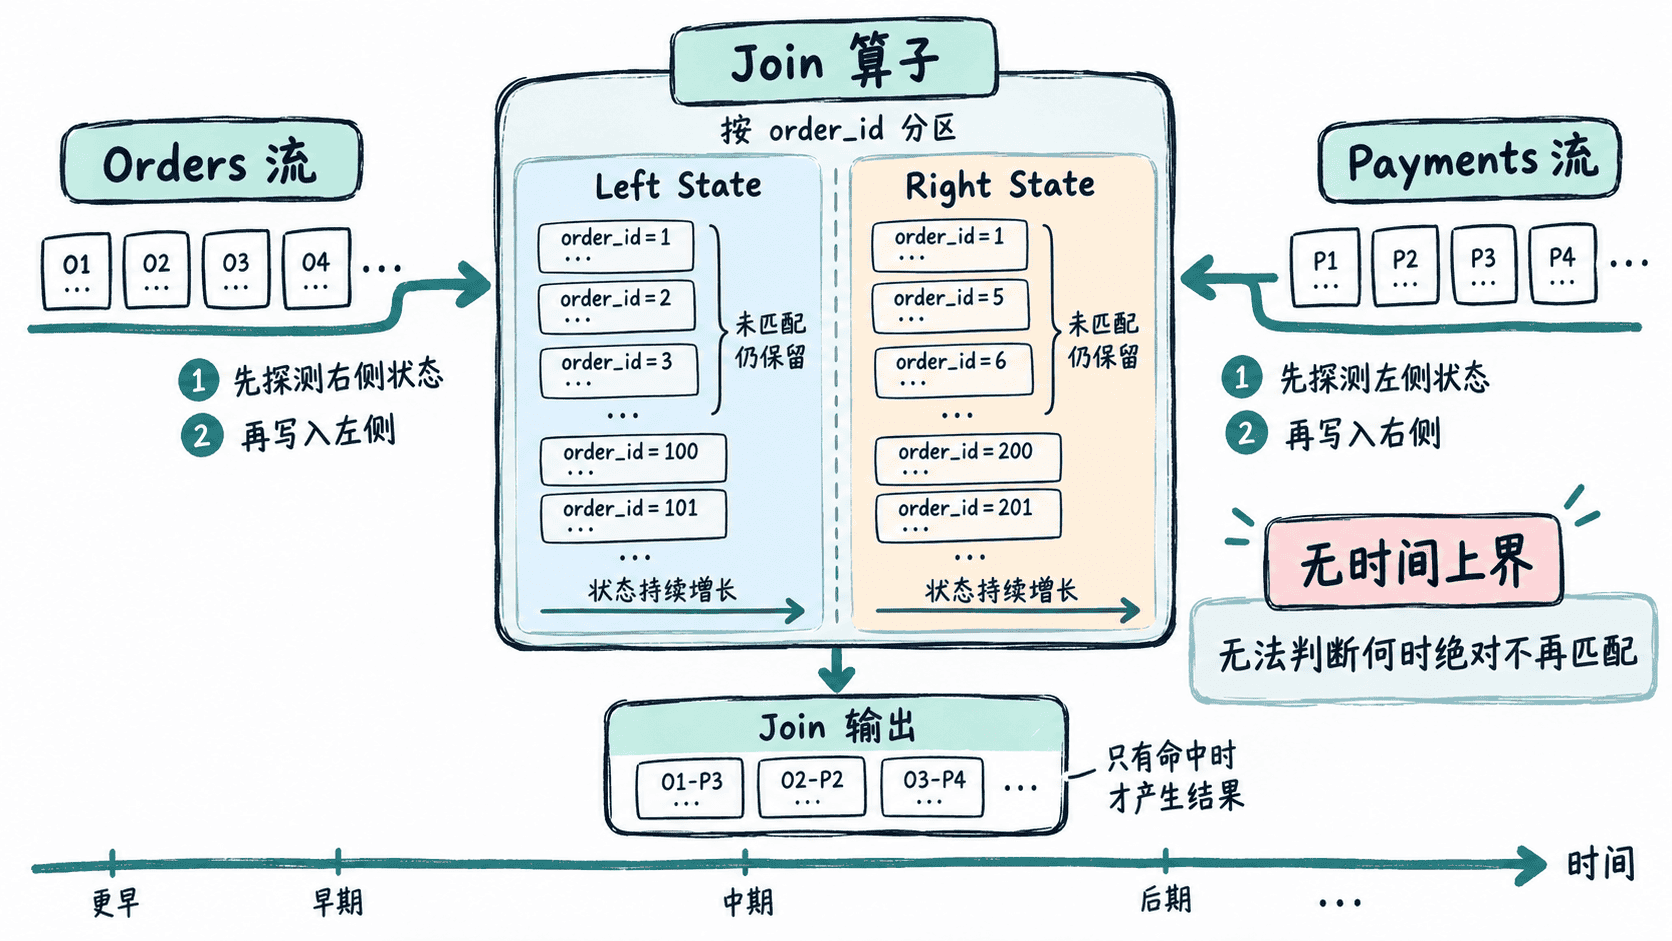
对任意一条订单,Flink 不能仅凭“当前还没看到支付”就认定它以后也不会匹配;支付侧记录同理。因此新记录到达时,算子既要查询另一侧已有状态,也要把当前记录保存下来,供未来记录继续匹配。
状态为什么会持续增长
Regular Join 的关键问题不是“Join 一定很大”,而是没有语义上的淘汰时刻。只要两侧都是无界输入,某个键在很久以后仍可能再次出现,旧记录就可能仍然有匹配价值。
增长速度取决于输入量、Join Key 基数、重复键数量以及未匹配记录比例。状态变大后,常见代价包括更高的状态存储占用、更慢的 checkpoint、更大的恢复数据量,以及后台状态读写压力上升。
如果业务设置状态 TTL,只能把它视为工程上的截断策略,而不是 Regular Join 自带的正确性边界。TTL 到期后删除的记录若本来还能与更晚的数据匹配,结果就会缺失,因此 TTL 必须与业务可接受的数据时效一起评估。
什么时候该换一种 Join
如果业务本身存在明确时间关系,例如“支付只能关联下单后 15 分钟内的订单”,应优先把这个边界写成 Interval Join;系统就能在时间推进后证明旧状态不再可能参与匹配。
如果需要的是“事实流按事件发生时看到的维表版本”,更适合 Temporal Join;如果希望按固定窗口成组计算,则应考虑 Window Join。Regular Join 适合确实允许任意未来记录继续匹配、并且能够接受其状态成本的场景。
判断标准很简单:如果你无法回答“一条已经保存的记录在什么时候可以确定永远不会再匹配”,那么这个 Regular Join 就没有天然的状态终点,必须在上线前把状态容量与正确性风险一起设计清楚。