
大数据与流处理 / 系统课时
从批式 SQL 转向流式 SQL
从批式 SQL 转向流式 SQL
同一条 GROUP BY 在批处理中会等输入结束后给出最终表,在流处理中却要随着新记录不断修正结果。本节用一个聚合查询建立动态表、状态与更新日志的心智模型,让你知道“SQL 没变,结果为什么会持续变化”。
学习目标
- 区分有限数据集与无界数据流上的 SQL 执行语义
- 理解动态表、持续查询和状态之间的关系
- 识别流式聚合结果为什么需要更新而不是只追加
同一条聚合为何得到两种结果
先假设有一张 orders(region, amount) 表,查询只做按区域汇总。下面是片段示例,依赖已经存在的 orders 表:
SELECT
  region,
  SUM(amount) AS total_amount
FROM orders
GROUP BY region;
如果输入只有三条记录并且随后结束:
| 到达顺序 | region | amount |
|---|---|---|
| 1 | east | 10 |
| 2 | east | 5 |
| 3 | west | 7 |
有限输入结束后的预期结果为:
east  15
west   7
批式处理可以等到“没有下一条数据”之后一次性给出最终答案。无界流没有天然结束点,因此查询不能等待最终时刻;每来一条新记录,都要让当前结果保持正确。
动态表如何持续变化
在流式 SQL 中,可以把输入流理解为持续修改一张逻辑上的动态表。聚合算子会保存每个 region 的当前累计值,新订单到来后读取旧状态、计算新值,再把结果变化发给下游。
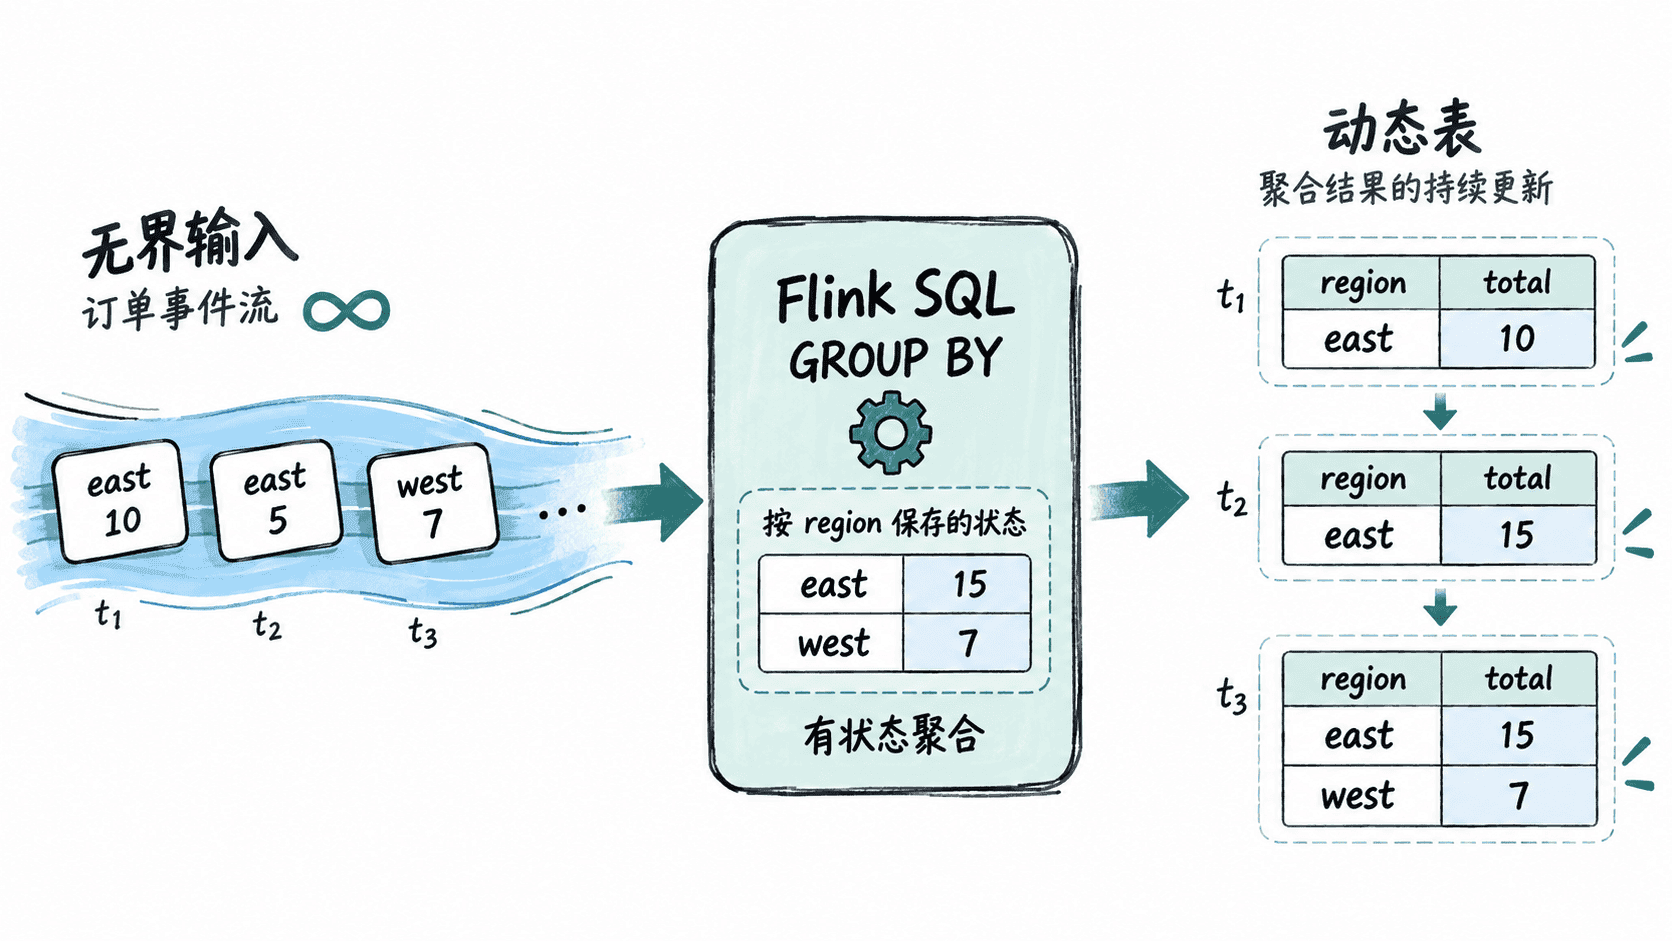
这也是流式聚合通常属于有状态计算的原因。对于 SUM、COUNT 这类按键聚合,系统至少要记住每个分组当前的结果,否则下一条记录到来时无法计算更新值。
Changelog 表达结果发生了什么变化
动态表本身是逻辑模型,真正向下游传递时通常要编码为 changelog。新分组第一次出现可以表示为插入;已有分组的值变化可以表示为更新;某些查询还可能产生删除。
例如 east 从 10 变为 15,语义上不是又多出一条彼此独立的最终记录,而是同一个键对应的结果被修正。具体下游是否需要 UPDATE_BEFORE、只接收 UPDATE_AFTER,取决于查询计划和接收端支持的 changelog 模式。
从“查一张表”转向“维护一个结果”
批式 SQL 更像“对已经存在的数据求答案”,流式 SQL 更像“对持续变化的数据维护当前答案”。这会进一步引出三个工程问题:状态要保存多久、什么时候可以认为某个时间范围完整,以及两个随时间变化的数据源应该按哪个时点关联。
后续学习窗口、Watermark 和时态关联时,都可以回到这个判断:输入是否持续到来,以及一条晚到或新到的数据是否会改变已经计算出的结果。