
大数据与流处理 / 系统课时
使用主键表达行身份
使用主键表达行身份
在流式 SQL 中,更新不是“又来一行”这么简单:系统必须知道新值是在修改哪一条逻辑记录。主键提供稳定的行身份,让聚合、去重和 Upsert Sink 能把多次变更归到同一个键上,而不是不断追加重复结果。
学习目标
- 解释主键为什么是更新流中的行身份,而不只是表结构约束
- 判断聚合与去重查询何时能产生稳定唯一键
- 理解稳定主键对 Upsert 输出和下游覆盖写入的意义
主键标识同一条逻辑记录
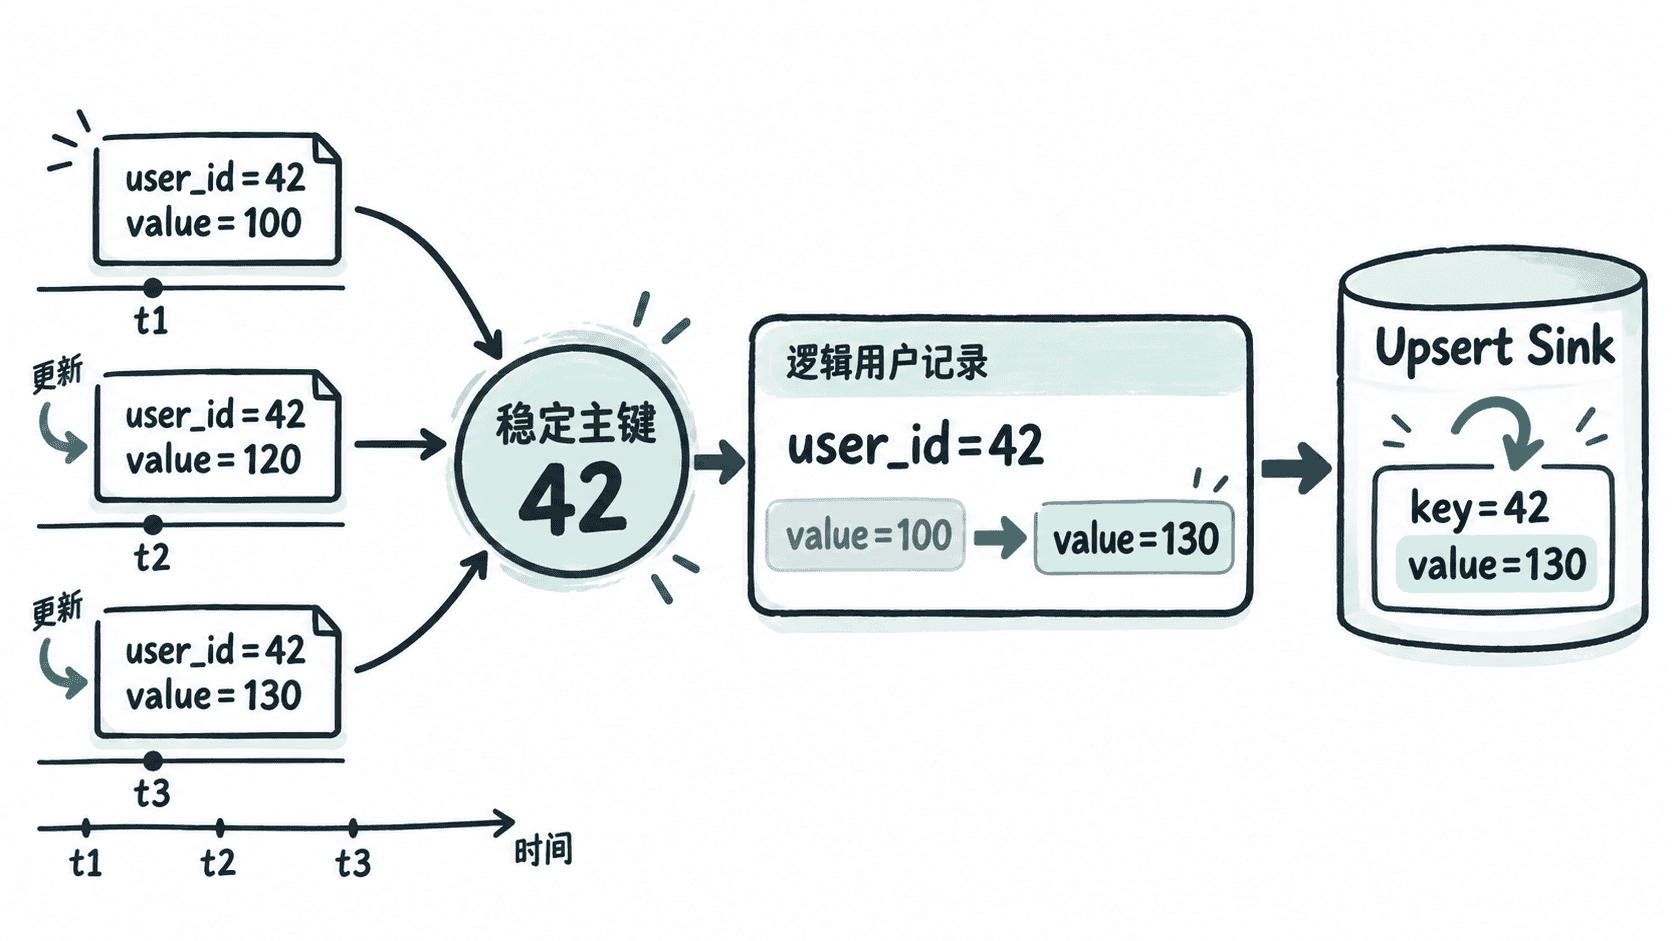
动态表会随输入持续变化。假设用户 42 的累计积分先是 100,随后变成 130,业务语义通常不是存在两条用户记录,而是键 42 对应的那一行被更新了。只要键稳定,下游就能用同一个键覆盖旧值。
在 Flink 表定义中,主键通常写成 PRIMARY KEY (...) NOT ENFORCED。它表达列值应当唯一且非空,但 Flink 不替外部系统逐行检查约束,因此数据源仍需保证键的真实性。
下面是片段示例,连接器参数需要按实际环境补齐:
CREATE TABLE user_score (
  user_id BIGINT,
  score BIGINT,
  updated_at TIMESTAMP(3),
  PRIMARY KEY (user_id) NOT ENFORCED
) WITH (
  'connector' = 'upsert-kafka',
  'topic' = 'user-score',
  'properties.bootstrap.servers' = '<HOST>:<PORT>',
  'key.format' = 'json',
  'value.format' = 'json'
);
预期结果
表定义声明 user_id 为稳定行身份;写入 Upsert 类型下游时,相同 user_id 的新值用于更新同一条逻辑记录。实际主机和端口会不同。验证时应重点检查源端是否真的保证 user_id 唯一,以及下游是否把该字段作为消息键或存储主键。
查询也会产生唯一键
主键不一定只来自源表。无界聚合 GROUP BY user_id 的结果中,每个 user_id 对应一条当前聚合结果,因此分组列可以成为结果表的唯一键。随着新事件到达,聚合值改变,但逻辑行仍由同一个 user_id 标识。
去重也依赖同样的原则。若查询明确为每个业务键保留唯一一行,例如按 order_id 选择最新版本,那么 order_id 才能支撑稳定 Upsert。若所谓“键”会变化、可能为空或并不唯一,下游就无法安全地把更新定位到旧记录。
Upsert 为什么依赖稳定键
Append Sink 只需要处理新增行;Upsert Sink 还要把更新和删除应用到已有状态,因此必须能定位目标行。稳定唯一键使一条变更可以表达为“键 K 的当前值变为 V”或“删除键 K”,而不是靠扫描整张结果表寻找旧值。
这也是为什么聚合、去重、Top-N 等查询在接入下游前要先检查唯一键。判断标准不是 SQL 里有没有写 PRIMARY KEY,而是最终动态表能否持续、唯一地识别同一条逻辑记录。