
大数据与流处理 / 系统课时
使用 EXPLAIN 检查执行计划
使用 EXPLAIN 检查执行计划
SQL 写对并不代表物理数据流符合预期。本课用 EXPLAIN 把一条包含 Join 与聚合的查询展开为执行计划,沿 Source、Exchange、Join、Aggregate、Sink 逐层检查数据如何流动,并据此发现多余 Shuffle、错误关联或下游能力不匹配等问题。
学习目标
- 使用
EXPLAIN PLAN FOR获取 Flink SQL 执行计划 - 识别 Source、Exchange、Join、Aggregate 与 Sink 的职责和数据流向
- 根据执行计划定位意外的数据重分区与算子结构
先看物理数据流而不是 SQL 表面
Flink SQL 会经过解析、关系代数优化和物理计划生成,最终才转换成可执行的数据流。SQL 中相邻的两个操作,在物理计划里可能被合并,也可能因为按 Key 分区而插入 Exchange。
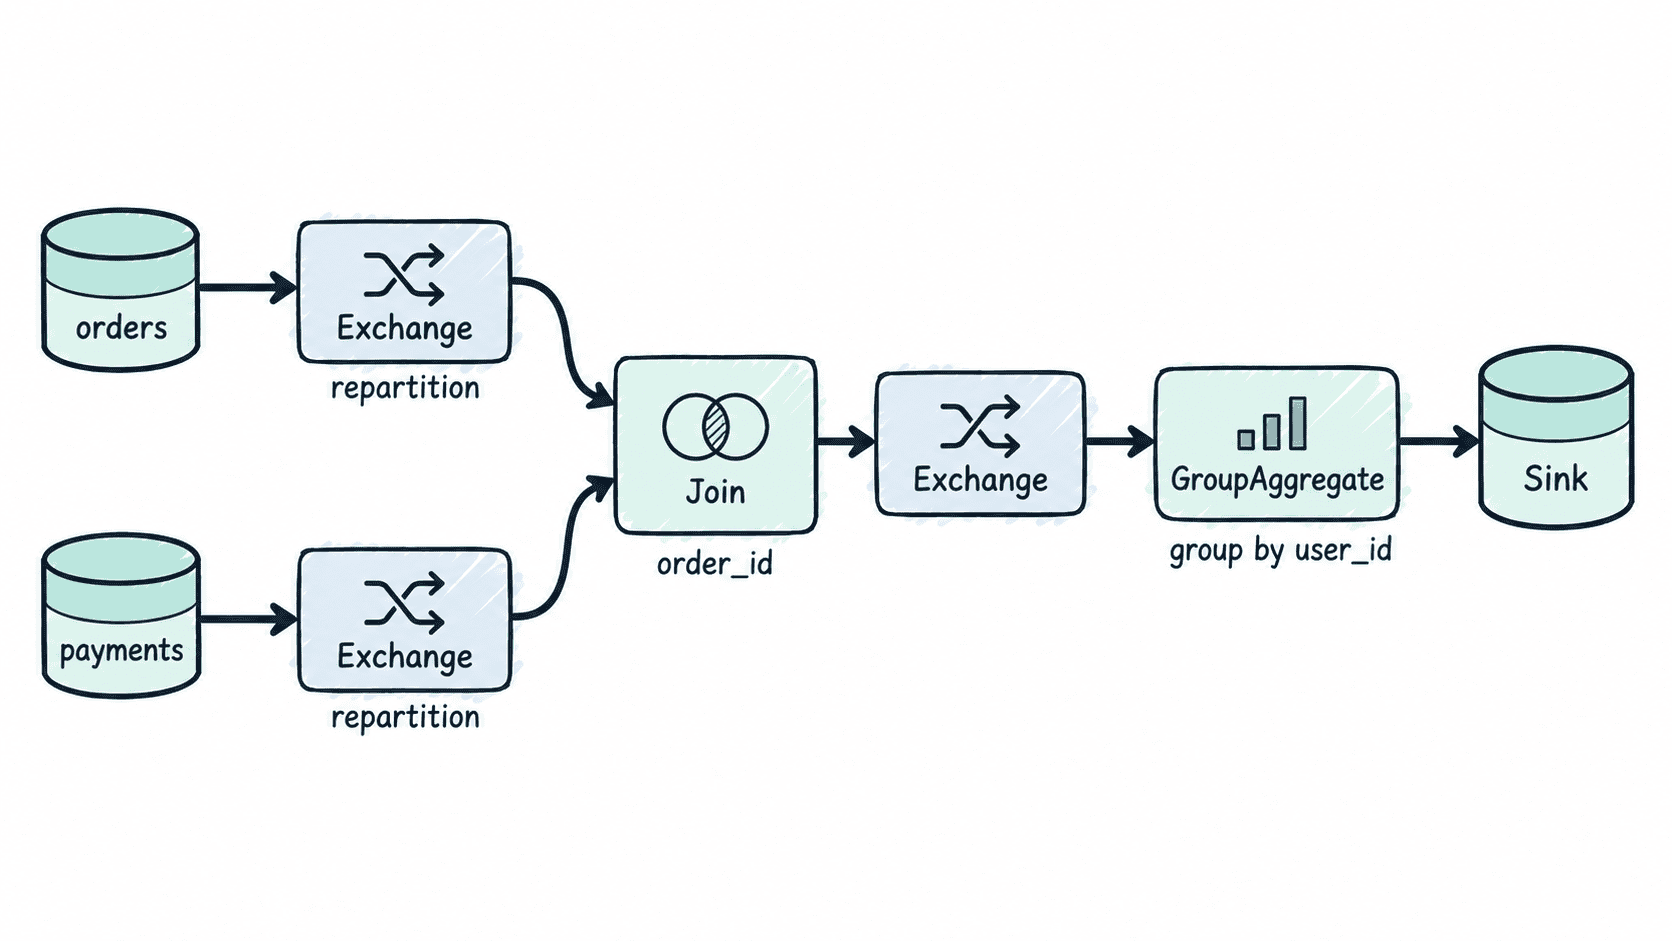
检查计划时可以沿数据流从输入向输出阅读:Source 负责读取数据,Exchange 改变分区,Join 合并两侧记录,Aggregate 维护聚合状态,Sink 接收最终的 changelog。真正需要关注的不是节点排版,而是这些算子是否按照业务预期出现。
用一条完整查询生成计划
下面的 SQL 可以直接在具备 DataGen 与 BlackHole connector 的 Flink SQL Client 中执行。两个无界数据源先按 order_id 关联,再按 user_id 计数,正好覆盖本课要检查的主要物理节点。
CREATE TEMPORARY TABLE orders (
  order_id BIGINT,
  user_id BIGINT
) WITH (
  'connector' = 'datagen',
  'rows-per-second' = '10',
  'fields.order_id.kind' = 'sequence',
  'fields.order_id.start' = '1',
  'fields.order_id.end' = '100000',
  'fields.user_id.min' = '1',
  'fields.user_id.max' = '1000'
);
CREATE TEMPORARY TABLE payments (
  payment_id BIGINT,
  order_id BIGINT
) WITH (
  'connector' = 'datagen',
  'rows-per-second' = '10',
  'fields.payment_id.kind' = 'sequence',
  'fields.payment_id.start' = '1',
  'fields.payment_id.end' = '100000',
  'fields.order_id.min' = '1',
  'fields.order_id.max' = '100000'
);
CREATE TEMPORARY TABLE result_sink (
  user_id BIGINT,
  order_count BIGINT
) WITH (
  'connector' = 'blackhole'
);
EXPLAIN PLAN FOR
INSERT INTO result_sink
SELECT o.user_id, COUNT(*) AS order_count
FROM orders AS o
JOIN payments AS p
  ON o.order_id = p.order_id
GROUP BY o.user_id;
预期结果
DDL 创建成功。
EXPLAIN 返回逻辑计划和优化后的物理计划等内容。
在物理计划中应能识别:
两个输入 Source -> 按关联键重分区的 Exchange -> Join
Join 输出 -> 为按 user_id 聚合进行的 Exchange -> Aggregate -> Sink
具体节点名称、编号和排版会随 Flink 版本与优化结果变化。
这里不要机械要求每一级都单独出现。例如部分投影或过滤可能被合并进 Source 或 Calc;真正需要确认的是分区键、关联条件和聚合键有没有发生意外变化。
逐个检查关键节点
看到 Source 时,先确认读取的是预期表,并检查过滤、字段裁剪等优化有没有尽量靠近输入端。大量无用字段或本可提前过滤的数据进入 Join,会直接放大网络和状态成本。
看到 Exchange 时,要问清楚为什么需要重新分区。等值 Join 通常要求两侧相同关联键落到同一并行实例,因此 Join 前出现按 order_id 的 Exchange 很正常;聚合改用 user_id,Join 后再次重分区同样合理。若连续出现多个无法解释的 Exchange,就应重新检查 Key、聚合方式或上游操作。
看到 Join 时,确认关联类型和条件与 SQL 一致。特别要留意普通流式等值 Join:如果没有时间范围,它通常需要持续保存可能在未来匹配的两侧记录,这也是后续排查状态膨胀时首先要识别的结构。
看到 Aggregate 时,确认分组键是否正确,并意识到流式聚合通常会产生更新型 changelog。最后检查 Sink 是否能够消费上游输出模式;如果下游只接受追加数据,而计划需要更新或撤回,就不能只看 SQL 语法是否通过。
用计划回答三个排障问题
遇到吞吐下降、状态变大或结果模式异常时,执行计划至少应该回答三个问题:数据在哪些位置重新分区,哪个算子在长期维护状态,以及最终 Sink 接收到什么类型的变化。
如果实际计划与预想不一致,不要先调并行度或内存参数。先回到 SQL 条件、Join Key、时间约束和聚合键解释每一个关键节点;只有物理数据流正确,资源调优才有稳定意义。