
大数据与流处理 / 系统课时
搭建 Flink SQL 实验环境
搭建 Flink SQL 实验环境
本节搭建一个可重复的本地 Flink SQL 环境:启动集群、进入 SQL Client,并用内置 DataGen 连接器跑完一条有限查询。完成后你会拥有后续练习可直接复用的 JobManager、TaskManager 和交互式 SQL 入口。
学习目标
- 用固定版本的 Docker Compose 启动 Flink 2.3.0 本地集群
- 通过 SQL Client 提交 DDL 与查询并观察结果
- 区分内置连接器与需要额外 JAR 的外部连接器
选择可重复的本地方案
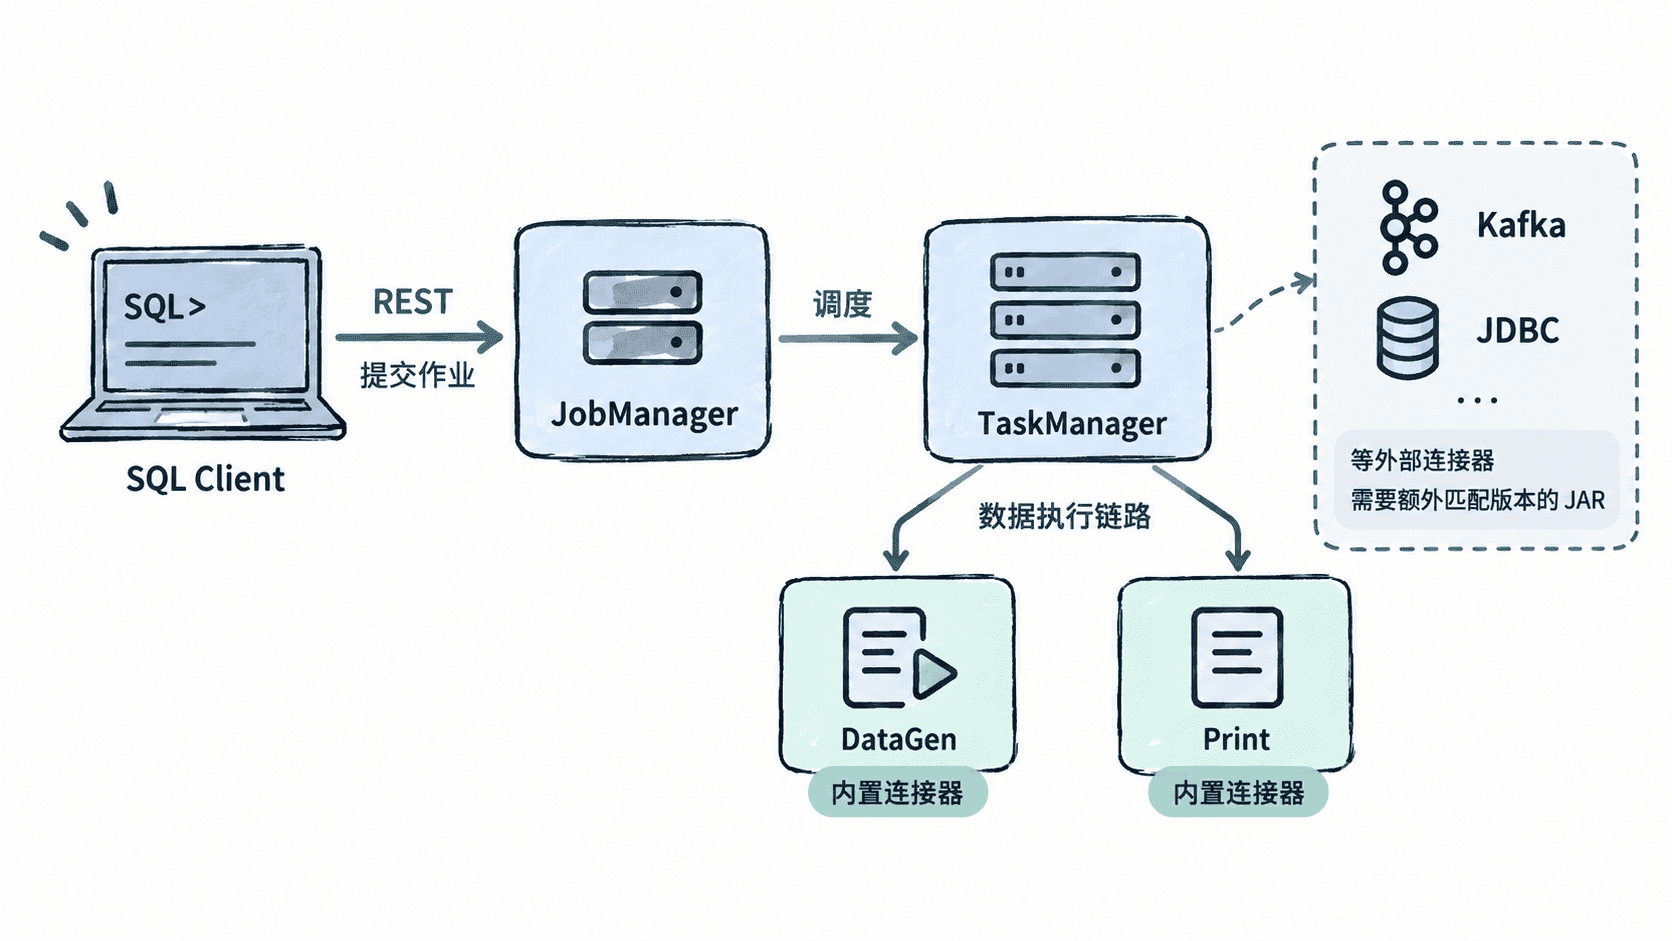
本课使用 Docker Compose,并把镜像固定为 flink:2.3.0,避免不同机器上的 Java 与本地安装路径差异。基础实验只使用内置的 DataGen 与 Print 连接器,不需要额外下载 JAR;以后接入 Kafka、JDBC 等外部系统时,再为对应 Flink 版本准备连接器依赖。
创建 docker-compose.yml,内容如下。该配置定义一个 JobManager、一个 TaskManager 和一个按需启动的 SQL Client:
services:
  jobmanager:
    image: flink:2.3.0
    command: jobmanager
    ports:
      - "8081:8081"
    environment:
      - |
        FLINK_PROPERTIES=
        jobmanager.rpc.address: jobmanager

  taskmanager:
    image: flink:2.3.0
    command: taskmanager
    depends_on:
      - jobmanager
    environment:
      - |
        FLINK_PROPERTIES=
        jobmanager.rpc.address: jobmanager
        taskmanager.numberOfTaskSlots: 2

  sql-client:
    image: flink:2.3.0
    command: bin/sql-client.sh
    depends_on:
      - jobmanager
    environment:
      - |
        FLINK_PROPERTIES=
        jobmanager.rpc.address: jobmanager
rest.address: jobmanager生效后,jobmanager 暴露 Web/REST 端口,taskmanager 提供执行槽位,sql-client 通过服务名 jobmanager 连接集群。三个容器的职责关系如下:
启动集群并确认服务
在 docker-compose.yml 所在目录执行:
docker compose up -d jobmanager taskmanager
docker compose ps --status running --services
预期输出至少包含下面两个服务,顺序可能不同:
jobmanager
taskmanager
如果 8081 已被占用,只需修改主机侧端口映射,例如改成 <PORT>:8081;容器内部仍使用 8081。实际主机端口值可能不同。
进入 SQL Client
集群运行后启动交互式客户端:
docker compose run --rm sql-client预期结果是进入 SQL Client,并看到可输入语句的提示符:
Flink SQL>SQL Client 负责解析会话中的 SQL 并把作业提交到已运行的 Flink 集群。它不是独立计算引擎,因此如果 JobManager 没有启动,客户端即使能打开,也无法正常提交需要执行的查询。
用 DataGen 完成冒烟验证
在 Flink SQL> 中执行下面的完整示例。number-of-rows = 5 把 DataGen 变成有限源,因此聚合查询会在生成五行后结束,适合验证环境是否真正可执行 SQL:
CREATE TABLE smoke_source (
  id BIGINT
) WITH (
  'connector' = 'datagen',
  'number-of-rows' = '5',
  'fields.id.kind' = 'sequence',
  'fields.id.start' = '1',
  'fields.id.end' = '5'
);

SELECT COUNT(*) AS cnt
FROM smoke_source;
预期结果是查询结束并得到计数 5;SQL Client 的表格边框样式可能随终端而不同,但数据应等价于:
cnt
5
如果查询一直不结束,先检查是否漏写 number-of-rows;没有这个选项时 DataGen 默认可以持续产生数据,查询就会保持运行。
准备后续外部连接器
DataGen 和 Print 足够验证 Flink SQL 的 DDL、持续查询和结果输出。Kafka、JDBC 等连接器通常以独立 JAR 提供,SQL Client 可以通过 --jar 指定单个依赖,或通过 --library 加载目录;依赖版本必须与当前 Flink 版本兼容。
遇到 Could not find any factory for identifier '<ID>' 这类错误时,优先检查对应连接器 JAR 是否已被 SQL Client 加载,而不是反复修改 DDL。<ID> 的实际值可能是 kafka、jdbc 等连接器标识。
完成上述冒烟查询后,环境验收标准很简单:JobManager 和 TaskManager 都在运行、SQL Client 能连接集群、有限 DataGen 查询能返回 5。满足这三点,就可以在同一环境继续练习无界表、时间属性和时态关联。