
大数据与流处理 / 系统课时
判断查询的 Changelog 模式
判断查询的 Changelog 模式
流式查询的结果会持续变化,不能只看一条 SQL 最终“长什么样”。判断 Changelog 模式时,要先问结果行会不会被后续数据改写,再结合输入流是否含更新、算子是否会撤回旧结果以及结果是否存在稳定唯一键。
学习目标
- 区分只追加结果与包含更新、删除的动态结果
- 根据过滤、聚合、去重和 Join 的语义判断常见 Changelog 类型
- 在设计 Sink 前识别查询是否需要处理更新前、更新后或删除消息
先判断结果会不会被改写
Flink 的动态表变更可理解为四类行事件:+I 表示插入,-U 表示更新前,+U 表示更新后,-D 表示删除。真正需要关注的不是符号本身,而是查询是否可能让已经输出的逻辑结果失效。
若输入是只追加流,简单投影和过滤通常仍是只追加:一行一旦通过过滤就不会被后续事件改写。无界聚合则不同,新事件会改变已有分组的聚合值,因此结果需要更新。若旧结果必须显式撤回,还会出现更新前或删除语义。
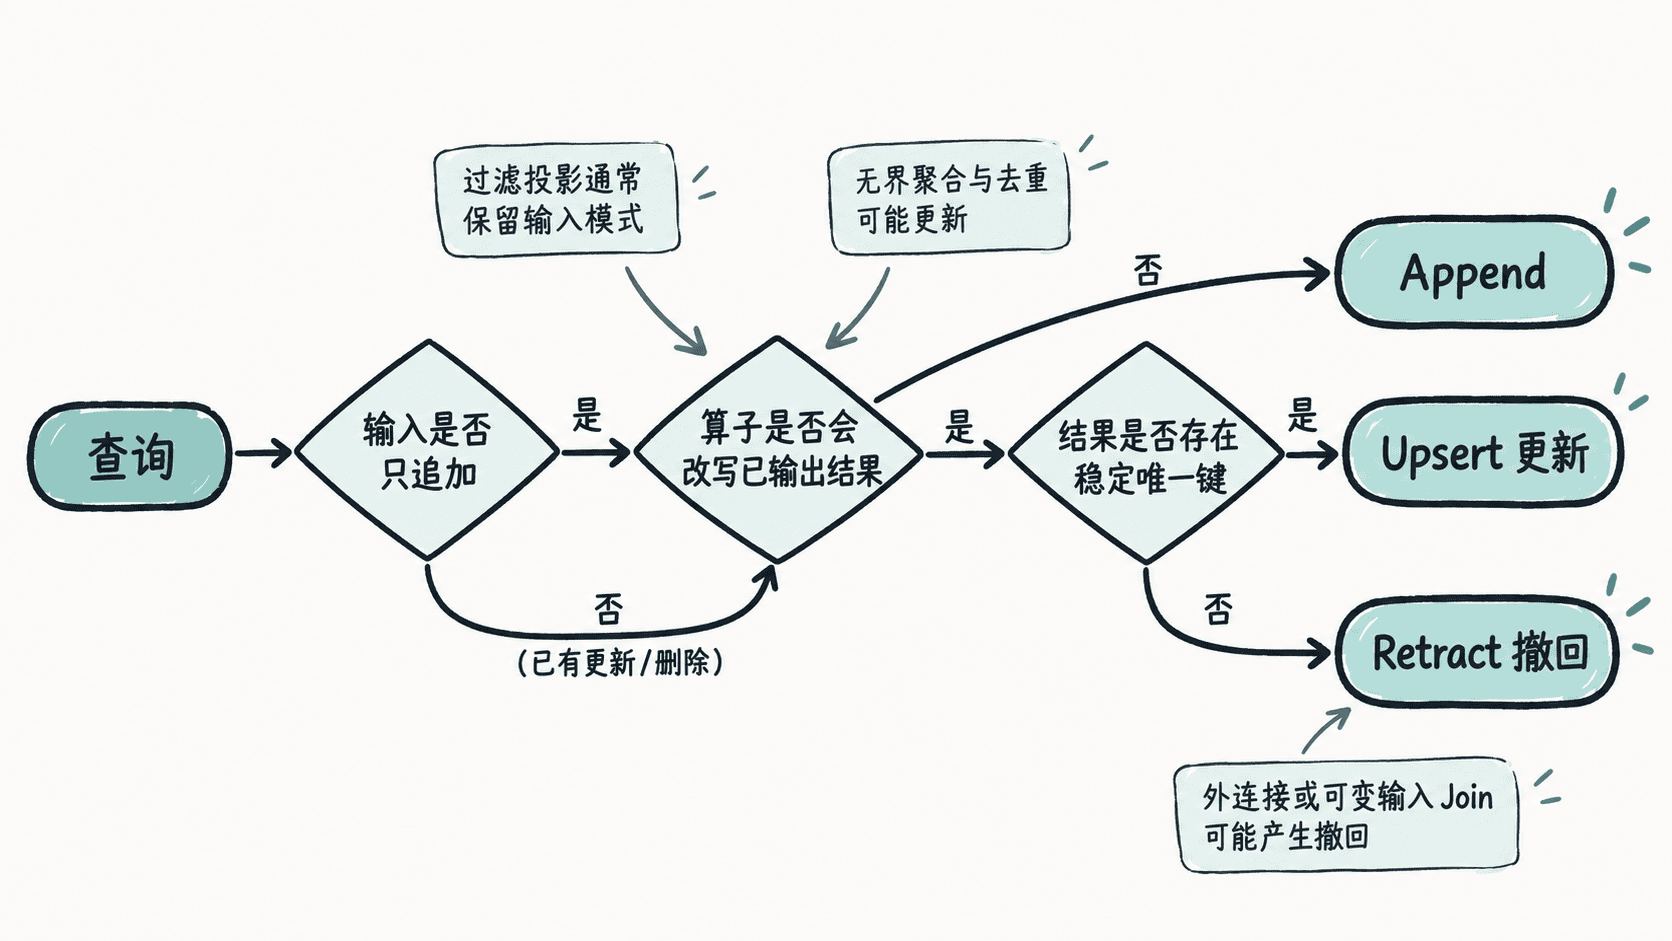
用算子语义快速判断
简单过滤与投影本身不会创造更新。如果上游只产生插入,结果通常也是 Append-only;如果上游本来就会更新或删除,它们通常会把这些变化继续传播。
无界 GROUP BY 聚合会反复修改同一分组的当前结果。下面是片段示例,假设 orders 是已注册的流表:
SELECT
  customer_id,
  COUNT(*) AS order_count
FROM orders
GROUP BY customer_id;
预期结果
同一 customer_id 后续收到新订单时,order_count 会变化,因此结果不是只追加表,而是更新型动态表。去重与 Top-N 也要看“赢家”是否可能变化。后来的记录若能替换当前保留行,就需要更新旧结果。普通内连接在两个只追加输入上可以持续追加新匹配,但只要任一侧会更新或删除,对应匹配结果也可能需要撤回;外连接还可能先输出未匹配行,之后因新匹配到达而修正结果。
唯一键决定能否按键更新
同样是“结果会变”,有无稳定唯一键会影响下游表达方式。若结果能推导出唯一键,例如 GROUP BY customer_id 的 customer_id,下游可以按键接收当前值,适合 Upsert 语义。
若结果没有稳定键,下游无法只凭新值定位要替换的旧行,往往需要携带更完整的撤回信息。因而判断 Changelog 不能只看算子名称,还要同时看唯一键是否能从源主键、分组键或其他约束中保留下来。
在接 Sink 前做最后检查
接入 Kafka、数据库或其他 Sink 前,按固定顺序检查:上游源表提供哪些变更类型;查询是否会修改已产生的结果;结果是否有稳定唯一键;Sink 能接受哪些变更。四项中任一项不匹配,都可能在规划阶段失败,或迫使系统增加额外的归一化处理。
批式 SQL 只关心最终快照,流式 SQL 还必须说明“快照如何变化”。能先判断 Changelog,再选择 Sink,才能避免把持续更新的动态表误当成只能追加的事件流。