
大数据与流处理 / 系统课时
观察持续查询的结果变化
观察持续查询的结果变化
本课用一条持续输入的数据流观察过滤、表达式计算和聚合如何共同影响查询结果,并直接查看聚合结果从插入变成连续更新的过程,为理解后续 Changelog 与时态查询建立直觉。
学习目标
- 理解流式 SQL 查询为什么会长期运行而不是一次返回后结束
- 观察过滤、投影表达式和聚合对持续结果的影响
- 从
+I、-U、+U识别动态表结果的变化
持续查询维护的是不断变化的结果
批处理 SQL 通常面对一组已经存在的数据,查询完成后即可得到最终结果。流式 SQL 的输入可能一直没有结束,因此查询也会长期运行:每有新记录到达,算子就继续处理,并在必要时修改当前结果。
单纯的过滤和投影通常不会修改已经输出的旧记录。新数据满足过滤条件时,再产生一条新结果即可。但 GROUP BY 聚合不同,同一个分组收到后续数据后,原来的计数、求和等结果会被新的值替代。
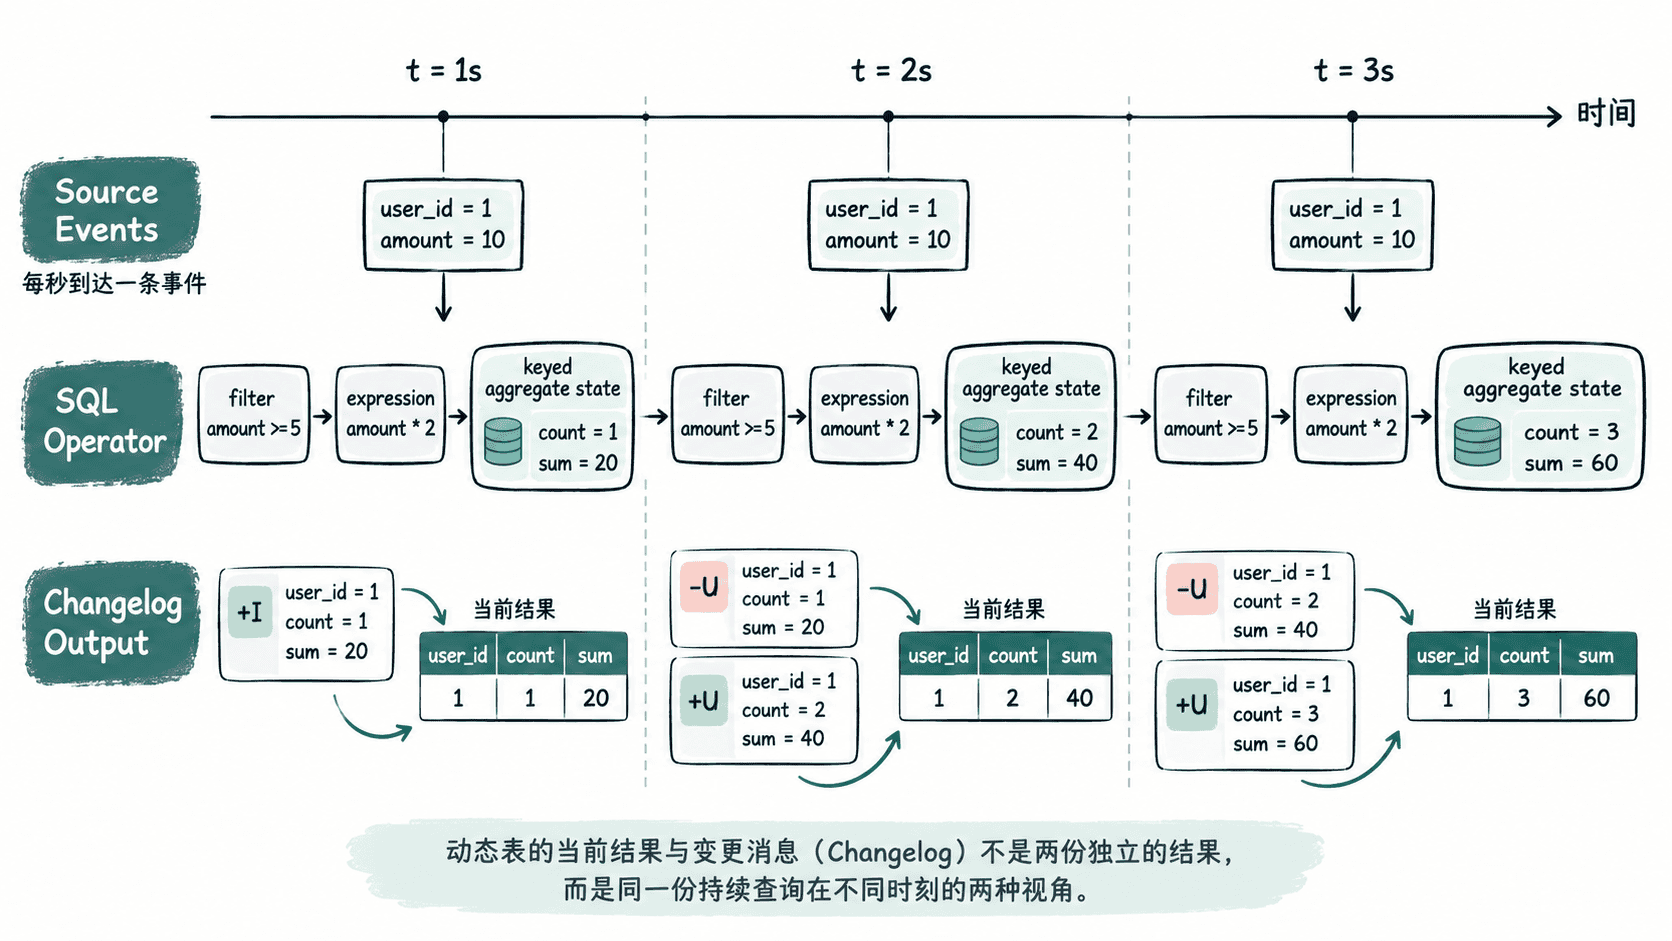
用可控数据观察结果演化
下面让 DataGen 每秒产生一条完全相同的记录:user_id 固定为 1,amount 固定为 10。查询先执行 amount >= 5 过滤,再计算 amount * 2,最后按用户聚合。Print 连接器会把动态表的变更以 Changelog 形式输出。
SET 'parallelism.default' = '1';
SET 'table.exec.mini-batch.enabled' = 'false';

CREATE TEMPORARY TABLE events (
    user_id BIGINT,
    amount BIGINT
) WITH (
    'connector' = 'datagen',
    'rows-per-second' = '1',
    'fields.user_id.min' = '1',
    'fields.user_id.max' = '1',
    'fields.amount.min' = '10',
    'fields.amount.max' = '10'
);

CREATE TEMPORARY TABLE stats (
    user_id BIGINT,
    cnt BIGINT,
    projected_sum BIGINT
) WITH (
    'connector' = 'print'
);

INSERT INTO stats
SELECT
    user_id,
    COUNT(*) AS cnt,
    CAST(SUM(amount * 2) AS BIGINT) AS projected_sum
FROM events
WHERE amount >= 5
GROUP BY user_id;
预期输出:在关闭 mini-batch 且单并行度运行时,前几次聚合更新会呈现下面的变化;作业会继续运行,因此后续计数仍会增长。
+I[1, 1, 20]
-U[1, 1, 20]
+U[1, 2, 40]
-U[1, 2, 40]
+U[1, 3, 60]
...
每条输入的 amount 都是 10,所以过滤条件始终成立,表达式 amount * 2 每次贡献 20。第一条记录建立 cnt=1、projected_sum=20,随后同一分组不断收到新记录,聚合值就持续变化。
读懂插入与更新消息
+I 表示 Insert,也就是当前结果中第一次出现这一行。第一条事件到达后,用户 1 的聚合结果此前不存在,因此产生 +I[1, 1, 20]。
第二条事件到达后,同一个用户的当前结果必须从 (1, 20) 更新为 (2, 40)。Print Sink 因而可以看到 -U[1, 1, 20] 与 +U[1, 2, 40]:前者撤回更新前的值,后者给出更新后的值。第三条事件继续产生同样的更新过程。
判断查询是追加还是会改旧结果
过滤条件只决定新记录是否进入下游,普通投影只改变新记录的字段,因此这两类操作通常可以把结果看成持续追加。它们本身不需要回头修改早先已经产生的记录。
聚合、去重以及某些连接操作则需要维护状态。新数据可能改变已有结果,于是下游不能只接收新增行,还必须能够理解更新甚至删除。这也是流式 SQL 与传统一次性查询最关键的区别之一:SQL 文本看起来仍像在查表,但这张表可能随时间持续演化。
观察持续查询时,不应只问某一时刻返回了什么,还要问新数据到达后旧结果是否可能改变。这个问题一旦回答清楚,后续理解 Changelog、Upsert 以及时态关联都会更自然。