
容器与云原生 / 系统课时
理解容器文件系统
理解容器文件系统
本课解决容器内文件变化为何无法长期保存的问题,通过观察容器文件系统的写入层、删除行为和重建过程,理解什么时候需要引入持久化方案。
学习目标
- 理解镜像层、容器可写层和持久化存储之间的关系
- 掌握容器删除和重建后数据变化规律
- 能够判断应用数据是否需要独立存储
容器文件系统的基本模型
Docker 容器启动后,会基于镜像创建一个可写层。镜像本身保持只读,容器运行期间产生的新文件、修改和删除记录都会写入这一层。
这种设计让容器可以快速创建和销毁,但也意味着容器内部保存的数据默认属于容器生命周期,而不是应用生命周期。
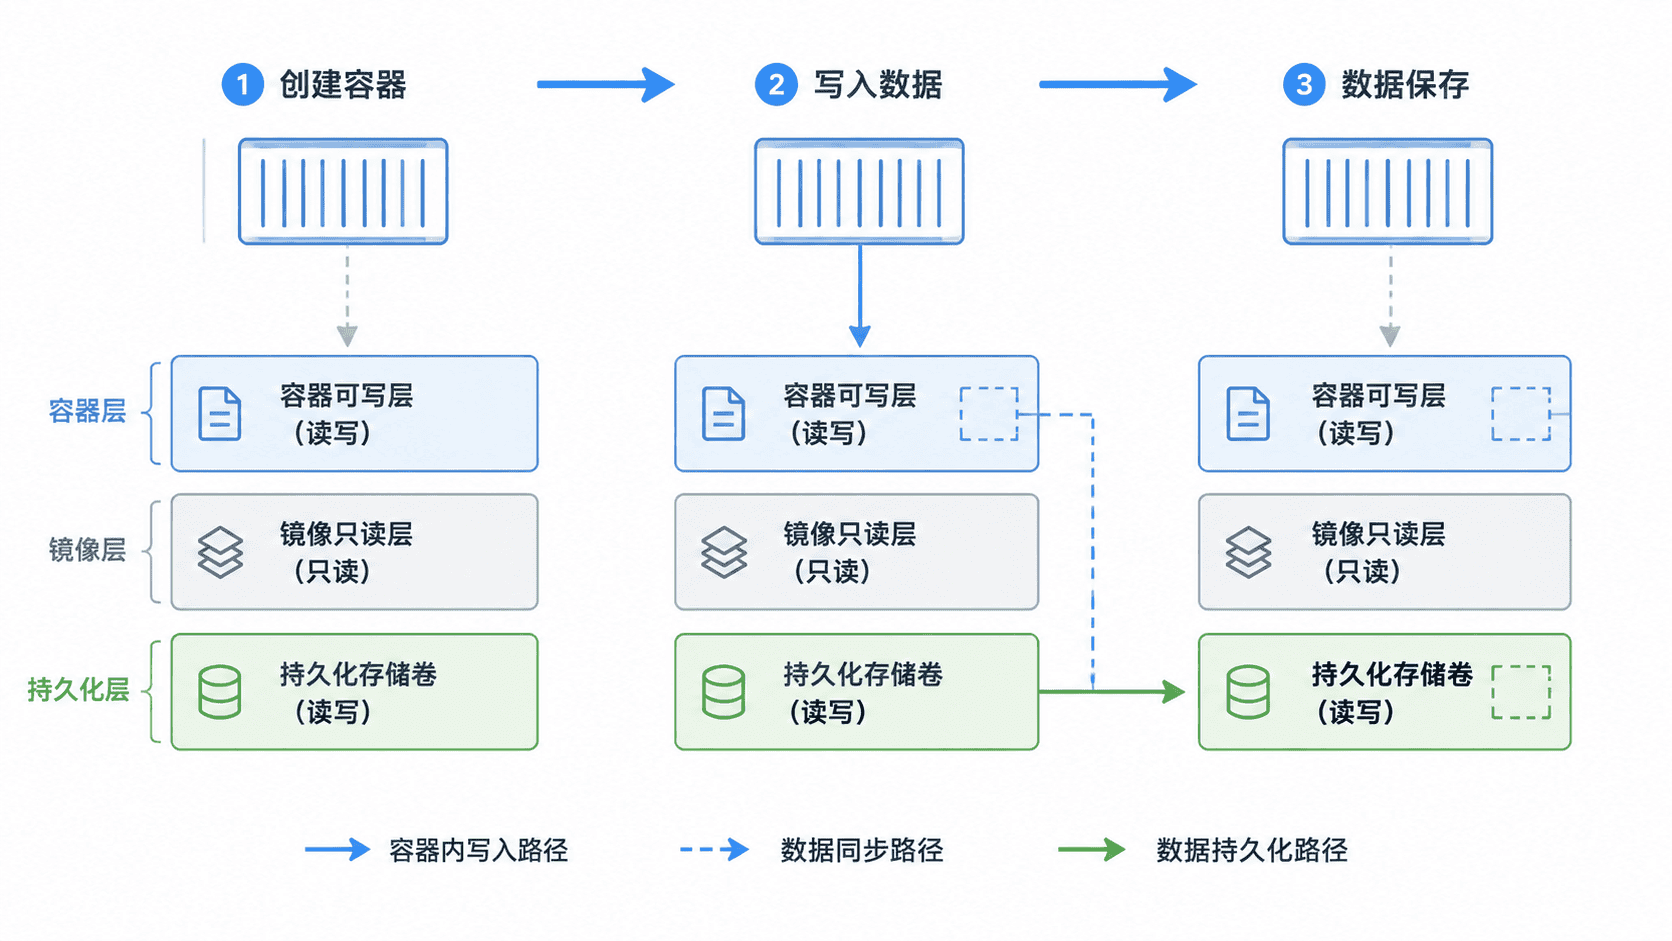
观察容器写入变化
可以通过简单实验观察容器删除前后的文件变化。
bash
docker run --name demo-container alpine sh -c "echo hello > /tmp/data.txt && cat /tmp/data.txt"
docker rm demo-container
预期输出
text
hello删除容器后,/tmp/data.txt 所在的可写层也会被删除。如果重新创建相同镜像的新容器,文件不会自动出现。
理解不可变容器原则
生产环境通常希望容器保持不可变:运行中的容器不直接修改应用文件,而是通过重新构建镜像或更新配置发布新版本。
不可变容器可以降低环境漂移问题,但业务数据不能依赖容器写入层保存,例如数据库文件、上传文件和用户生成内容。
判断哪些数据需要持久化
需要持久化的数据通常具有以下特点:
- 容器重建后仍需要保留
- 多个容器实例需要共享访问
- 数据生命周期长于单个容器
例如数据库目录应使用数据卷或外部存储,而临时缓存文件通常可以保留在容器内部。可以使用数据卷验证挂载效果:
bash
docker volume create app-data
docker run --rm -v app-data:/data alpine sh -c "echo saved > /data/file.txt && cat /data/file.txt"
预期输出
text
saved数据卷由 Docker 独立管理,即使临时容器删除,卷中的内容仍然存在。
按自己的节奏,确认真正理解。