
架构与系统设计 / 系统课时
Repository 变成万能查询类怎么办
Repository 变成万能查询类怎么办
当 OrderRepository 开始出现按客户、状态、日期、分页、统计等几十个方法时,问题通常不是“方法太多”,而是把聚合持久化和读模型查询塞进了同一个抽象。本节用拆分示例说明仓储该保留什么、复杂查询该放到哪里。
学习目标
- 判断 Repository 何时已经混入报表、列表和搜索职责
- 区分领域仓储与查询服务的输入、输出和变化原因
- 用最小拆分方式阻止 Repository 继续膨胀
先识别万能 Repository 的坏味道
领域仓储的核心职责,是让领域层以“集合”的方式取得和保存聚合。它通常围绕聚合标识、业务上有意义的少量查找方式,以及聚合生命周期展开。
当接口不断出现 findByCustomerIdAndStatusAndCreatedAtBetween、分页列表、金额统计、导出条件等方法时,查询需求已经在驱动仓储接口变化。尤其是返回 DTO、投影字段或跨多个聚合的统计结果时,这些需求更像读模型,而不是“加载一个聚合继续执行业务规则”。
把写模型和读模型分开
一个实用的边界是:Repository 面向领域对象和聚合生命周期,查询服务面向展示、筛选和统计结果。两者可以暂时共用同一个数据库,甚至由同一个基础设施类实现,但对上层暴露的接口要分开。
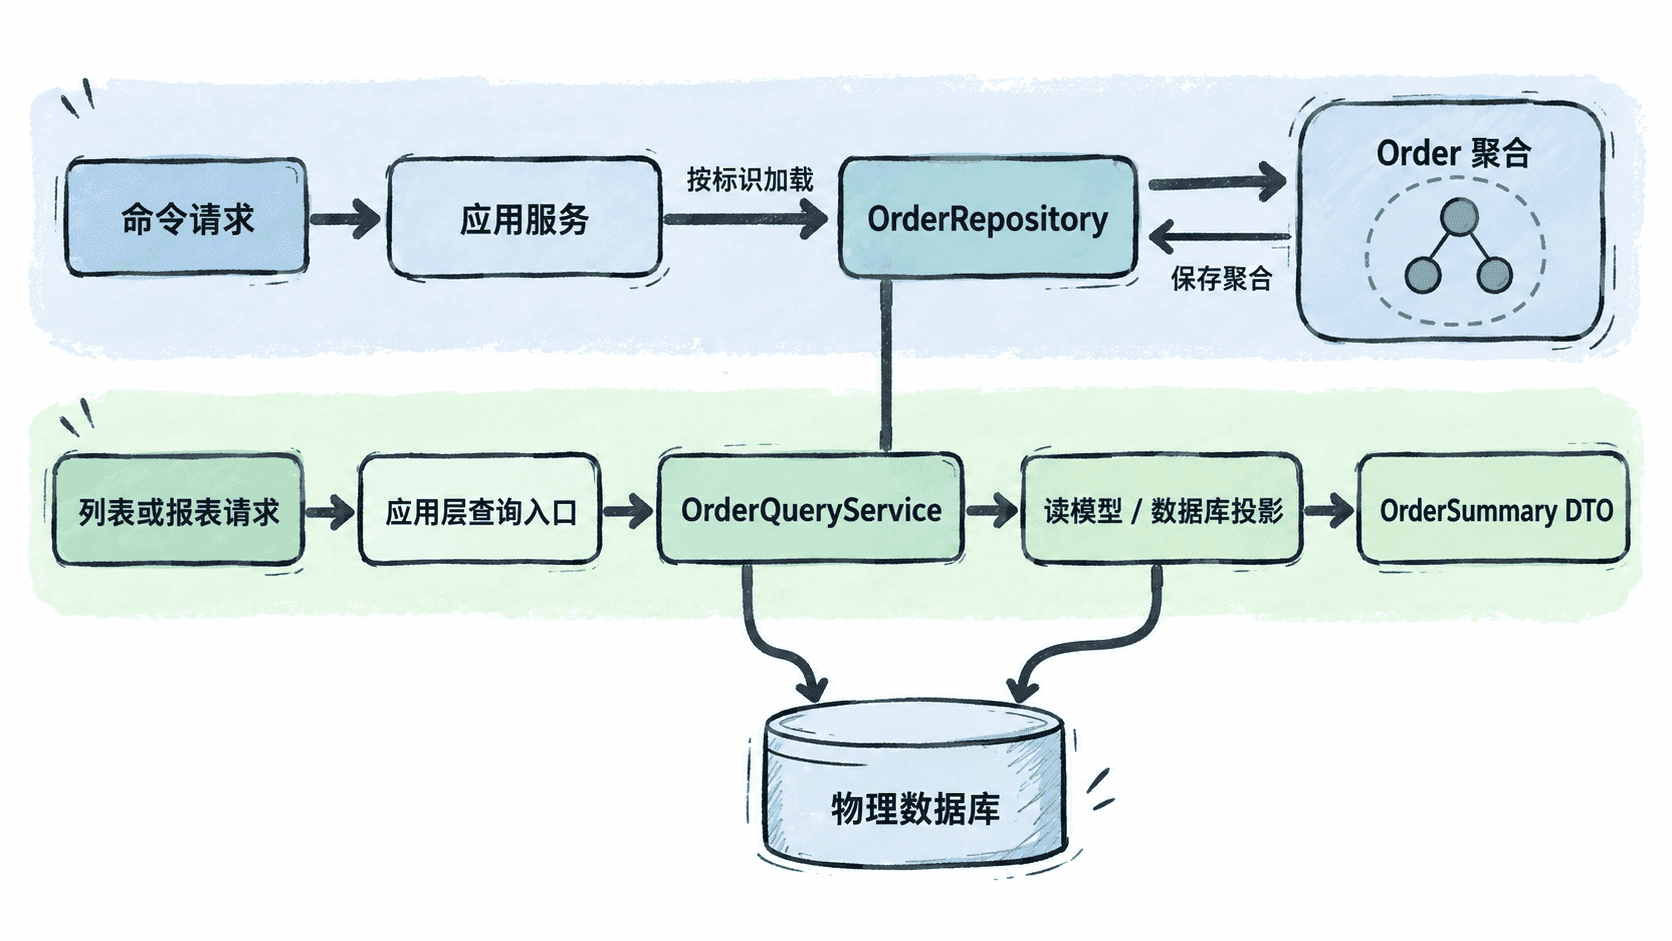
下面的完整 Java 17 示例把按标识加载聚合留给 Repository,把“按客户和状态筛选列表”放到查询服务。示例为了聚焦边界,使用内存集合代替数据库。
import java.util.LinkedHashMap;
import java.util.List;
import java.util.Map;
import java.util.Optional;

public class RepositorySplitDemo {

    record Order(long id, long customerId, String status, int amount) {
    }

    record OrderSummary(long id, String status, int amount) {
    }

    interface OrderRepository {
        Optional<Order> findById(long id);

        void save(Order order);
    }

    interface OrderQueryService {
        List<OrderSummary> findByCustomer(long customerId, String status);
    }

    static final class InMemoryOrderStore
            implements OrderRepository, OrderQueryService {

        private final Map<Long, Order> data = new LinkedHashMap<>();

        @Override
        public Optional<Order> findById(long id) {
            return Optional.ofNullable(data.get(id));
        }

        @Override
        public void save(Order order) {
            data.put(order.id(), order);
        }

        @Override
        public List<OrderSummary> findByCustomer(long customerId, String status) {
            // 查询服务直接生成读模型,不要求先还原完整聚合再做展示查询。
            return data.values().stream()
                    .filter(order -> order.customerId() == customerId)
                    .filter(order -> order.status().equals(status))
                    .map(order -> new OrderSummary(
                            order.id(), order.status(), order.amount()))
                    .toList();
        }
    }

    public static void main(String[] args) {
        InMemoryOrderStore store = new InMemoryOrderStore();
        store.save(new Order(1L, 100L, "PAID", 29900));
        store.save(new Order(2L, 100L, "PENDING", 9900));

        Order loaded = store.findById(1L).orElseThrow();
        List<OrderSummary> rows = store.findByCustomer(100L, "PAID");

        System.out.println("domain-load=" + loaded.id());
        System.out.println("query-count=" + rows.size());
        System.out.println(rows.get(0));
    }
}
预期输出(使用 Java 17 编译并运行):
domain-load=1
query-count=1
OrderSummary[id=1, status=PAID, amount=29900]
这里同一个 InMemoryOrderStore 同时实现两个接口,只是为了证明“物理实现可以复用,语义接口仍应拆开”。真实项目中,查询服务完全可以改用专门 SQL、视图、搜索引擎或只读副本,而不会迫使领域仓储跟着页面需求变化。
拆分时不要走到另一个极端
如果某个查询确实是执行业务行为所必需的,例如“按业务唯一键取得当前聚合”,它仍然可以属于 Repository。不要看到 find 就一律迁走。
更可靠的判断方法是看返回值和使用目的:返回聚合并马上执行领域行为,优先考虑 Repository;返回列表 DTO、统计值、跨聚合投影,且主要用于展示或检索,优先考虑查询服务。这样可以让领域接口围绕业务规则稳定,让高频变化的读取需求拥有自己的演进空间。