
架构与系统设计 / 系统课时
分层最重要的是目录还是依赖方向
分层最重要的是目录还是依赖方向
把 controller、application、domain、infrastructure 分成四个 package,只能让文件看起来整齐;如果领域代码仍直接依赖 ORM、消息客户端或 Web 框架,技术细节依旧会向核心业务渗透。判断分层是否成立,关键要看代码依赖指向谁。
学习目标
- 区分“目录分层”和“依赖分层”。
- 理解为什么核心业务不应直接依赖外部技术实现。
- 能用接口与依赖倒置让基础设施实现依赖业务抽象。
目录分开不等于依赖正确
下面两种项目都可能有四个目录,但性质完全不同。第一种只是把类移动到了不同 package;领域对象仍直接引用数据库框架、消息 SDK 或具体仓储类。第二种则让核心层定义自己需要的抽象,由外围技术代码去实现它。
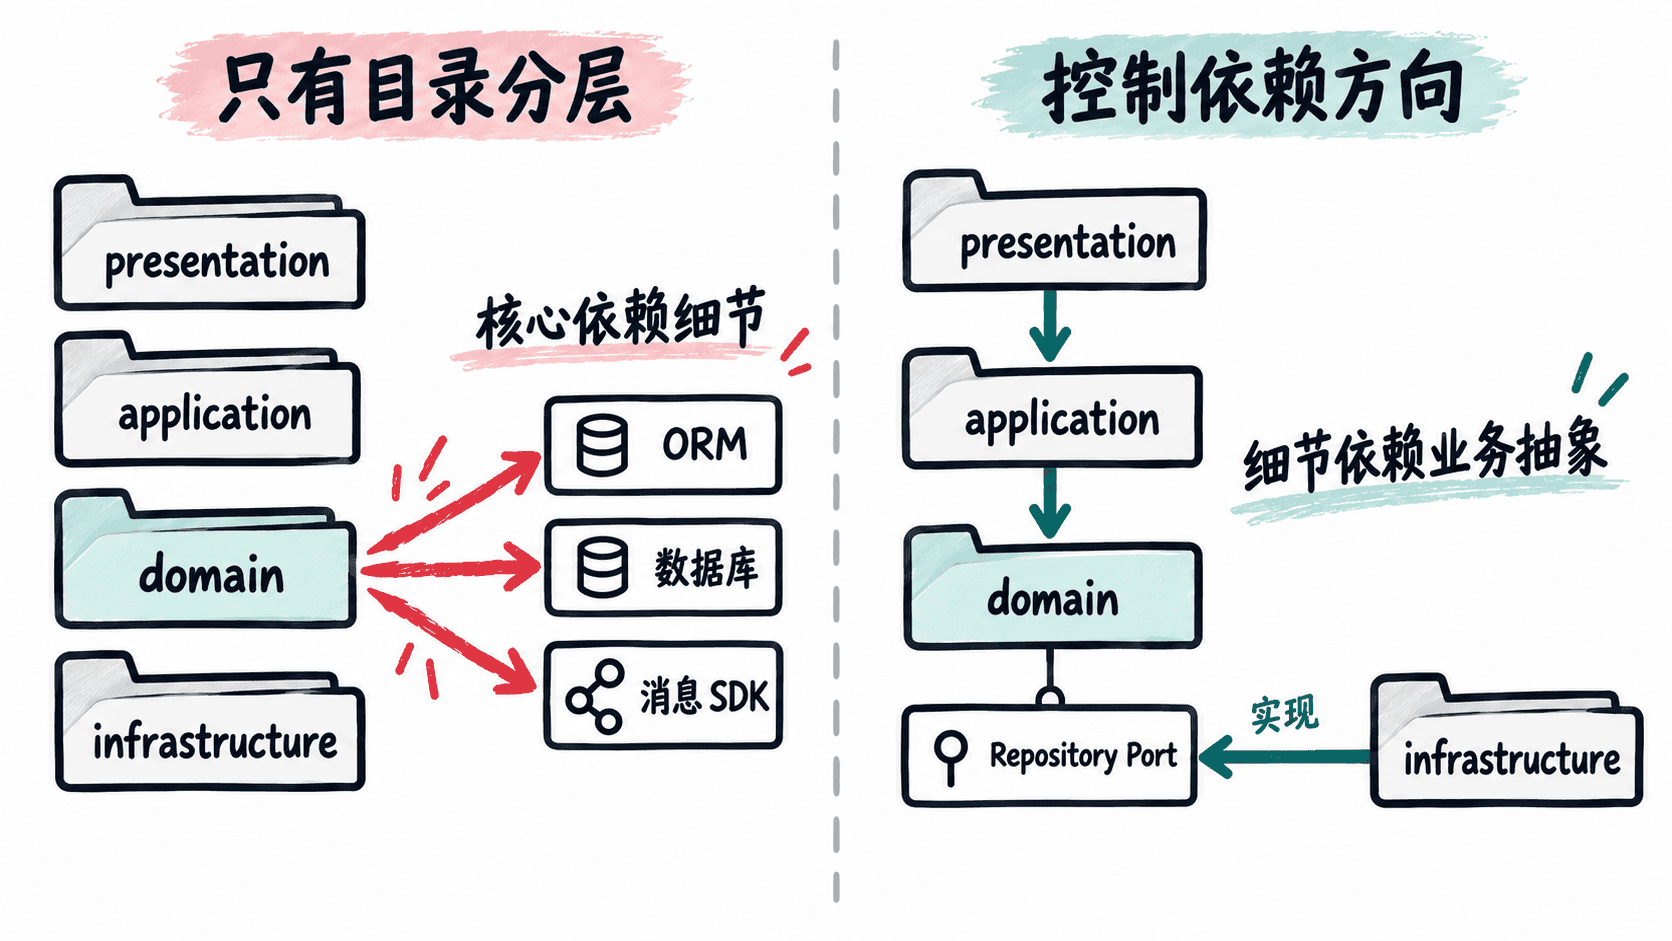
目录可以被随意跨层 import,因此它本身不会强制架构。真正有效的约束是:核心业务尽量不认识外围技术细节,外围代码可以依赖核心定义的稳定抽象。 这样数据库或消息系统变化时,修改主要集中在外围实现,而不是蔓延到业务模型。
用依赖倒置保护核心业务
下面是一个可运行的最小 Java 示例。PlaceOrderService 依赖 OrderRepository 抽象,而不是依赖某个数据库实现;具体的 DatabaseOrderRepository 在外围实现该接口。
public class DependencyDirectionDemo {
    interface OrderRepository {
        void save(Order order);
    }

    record Order(String id) {
        static Order place(String id) {
            if (id == null || id.isBlank()) {
                throw new IllegalArgumentException("order id is required");
            }
            return new Order(id);
        }
    }

    static final class PlaceOrderService {
        private final OrderRepository repository;

        PlaceOrderService(OrderRepository repository) {
            this.repository = repository;
        }

        void place(String id) {
            Order order = Order.place(id);
            repository.save(order);
        }
    }

    static final class DatabaseOrderRepository implements OrderRepository {
        @Override
        public void save(Order order) {
            System.out.println("saved " + order.id());
        }
    }

    public static void main(String[] args) {
        OrderRepository repository = new DatabaseOrderRepository();
        new PlaceOrderService(repository).place("O-1001");
    }
}
预期输出
saved O-1001这个示例里,业务侧只声明“我需要保存订单”这一能力,不关心 JDBC、JPA 还是远程存储。基础设施层选择具体技术并实现接口,因此依赖从“业务依赖数据库”改成了“数据库实现依赖业务抽象”。
依赖方向和运行调用方向不是一回事
运行时调用经常是应用服务调用仓储实现,因此直觉上容易认为“应用层依赖基础设施层”。但源码依赖可以通过接口反转:应用层或领域层只依赖 OrderRepository,真正的数据库类依赖这个接口并在程序组装时注入。
这也是为什么判断架构时不能只看调用顺序。运行时谁调用谁描述执行过程,源码里谁 import 谁才决定修改传播方向。分层设计重点控制的是后者。
检查分层是否真的成立
代码评审时可以重点检查几类信号:领域层是否 import Web、ORM 或消息客户端;应用服务是否直接 new 具体数据库实现;基础设施实现是否可以在不修改领域规则的情况下替换;跨层访问是否绕过公开接口直接操作内部对象。
并不是所有项目都必须采用同一种四层依赖图,但只要目标是让领域模型长期稳定,就应明确依赖规则,并用模块边界、构建依赖或架构测试持续约束。目录能帮助人看懂结构,依赖方向才真正决定这个结构能否守住。